
Albert理论详解:用矩阵分解与跨层参数共享减少参数量
1.介绍
Albert是Bert的一个变种,它在Bert的基础上减少了参数量,使整个模型更加的“轻量化”,同时也保持了Bert的性能,但值得注意的是,Albert虽然显著地减少了参数量,但并没有显著地减少计算时间复杂度,换言之,Albert的预测速度不一定比普通的更快,甚至可能会减慢训练的速度。(Albert只降参数量,而不减少计算量)
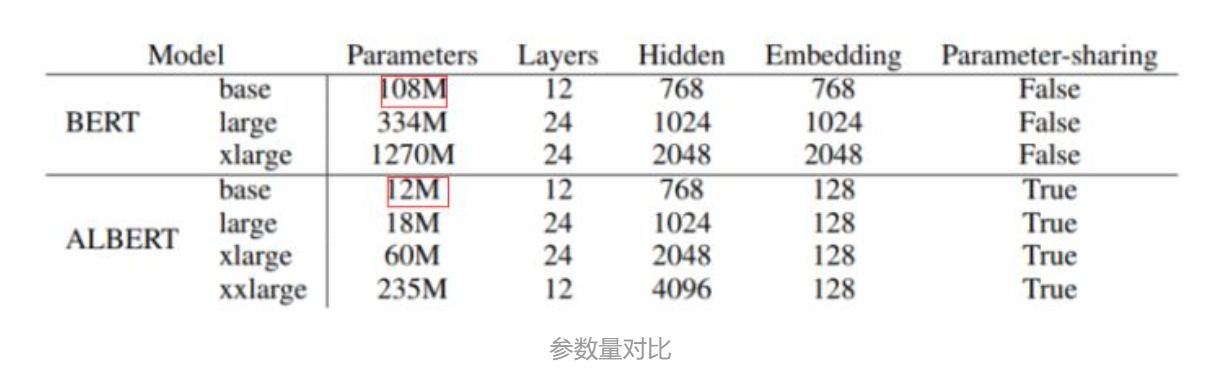
如上图所示,在base、large、xlarge这三个不同体量的模型上,Albert的参数量对比Bert均有十分明显的减少。
Albert之所以能够实现如此有效的参数缩减,原因在于它的两个特殊的机制:Factorized embedding parameterization(矩阵分解) 与 Cross-layer parameter sharing(跨层参数共享),下面将对这两个机制进行详细的介绍。
2.Factorized embedding parameterization(矩阵分解)
这一机制主要作用与embedding层上,在Bert(包括所有基于Bert的变体模型)中,为了从此表中提取特征并降维,我们首先要使用一个embedding层对输入数据进行处理。embedding的大小为词汇表的长度V乘以每个字/单词的embedding隐藏层大小H。 也就是说,一个embedding层的参数量为\(V×H\),而在Albert中,作者通过一个参数\(E\)来分解这个embedding矩阵,从而使得整体的embedding参数变小,于是\(V×H\)就转变为了\(V×E+E×H\),如果将embedding矩阵按照这种方式分解,最后得到的结果维度是不变的,依旧是\(L×H\)(\(L\)是句子长度),但如果此时,当\(E\)远小于\(H\)时,那么模型所需的参数量就会大大减少。实验证明,当\(E=128\)时效果最好。
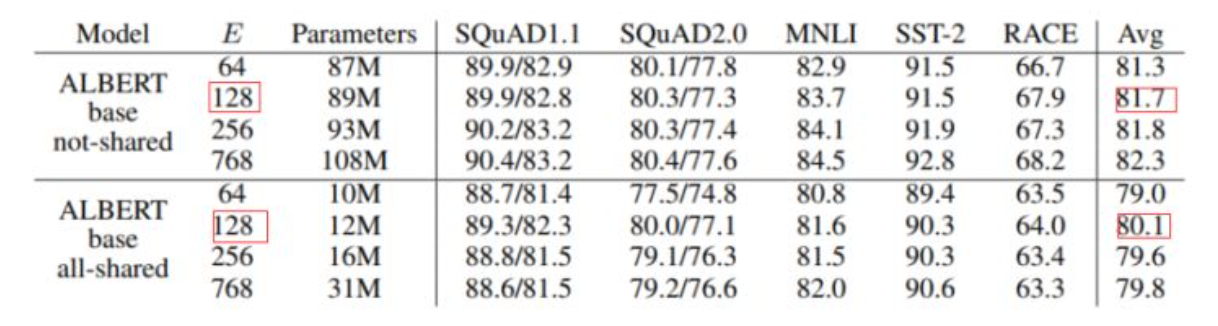
在Bert中,embedding层的\(H\)一般设定为\(768\),此时如果\(V\)的值为\(21000\),且\(E\)的值为\(128\),那么在使用矩阵分解前,参数量为\(21000×768=16128000=16M\),在使用矩阵分解后,参数的量为\(21000×128+128×768=2786304=2.7M\),由此可见,矩阵分解能够在一定程度上降低参数的量,但Albert最核心的机制并非矩阵分解,而是下面要介绍的Cross-layer parameter sharing(跨层参数共享)
3.Cross-layer parameter sharing(跨层数参数共享)
这是Albert的核心机制。
在Bert中,我们共有12个self-attention层,每一层的结构如下所示:
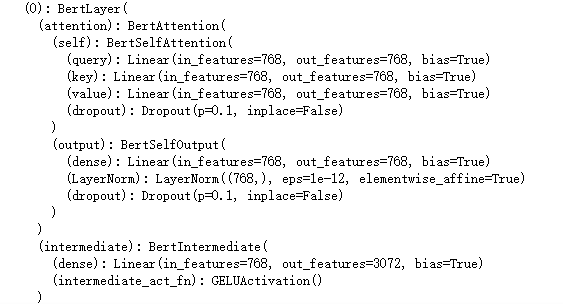
有趣的地方来了,Albert的作者经过研究发现,虽然Bert中有着12个self-attention层,但是,如果把每一层的参数都提取出来,会发现每一层的参数都基本相似。因此Albert的作者索性将一个self-attention层复制12次,用这12个完全相同的self-attention层取代原先12个不同的self-attention层。在训练时,我们其实只对一层self-attention进行训练,但在计算时,由于我们将这一层计算了12次,所以计算速度并没有显著地降低。
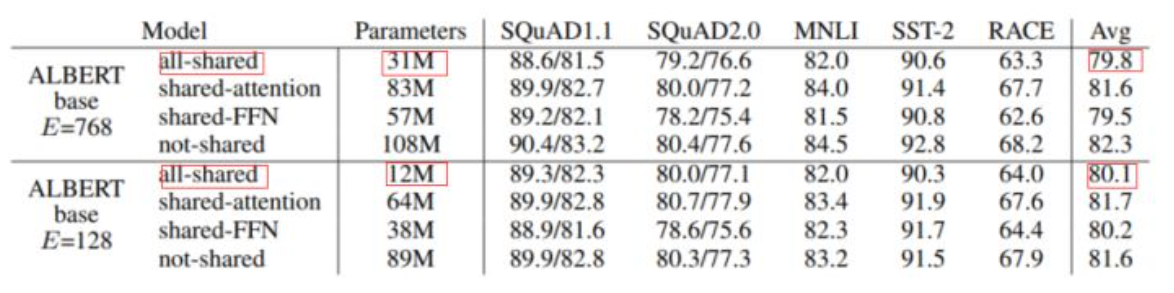
上图是几种不同的共享形式,all-shared降低的参数量最大,但同时会对最后的效果产生一定的影响,如果担心影响实际效果,可以选择shared-attention。Albert默认使用的是all-shared。
4.Albert与Bert的效果对比
作者在论文中将Bert与Albert进行了对比,对比的内容包括参数量、计算时间以及数据集评价指标:
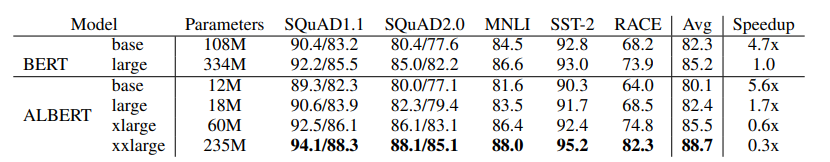
在上图中,计算速度体现在Speedup列,并以BERT-large的基准。例如,Bert-base的计算速度为4.7x,就代表Bert-base的计算速度时Bert-large的4.7倍(以此类推),但上表也表现出一个较为重要的问题:Albert的计算速度对比Bert其实并没有多大的提升,但同时,由于减少了参数的量,还会对模型的性能产生一定的影响。
考虑到这一点,作者还拿Bert-large与Albert-xxlarge进行了对比,结果如下表所示:

在上表中,Albert以较小的step,差不多的训练时间,在不同的数据集上取得了比Bert更好的效果。但考虑到实际使用时,参数量减少给训练结果带来的负面影响,Albert是否比Bert优秀还是要另当别论。
最后附上一个Albert中文预训练模型的huggingface链接:
https://huggingface.co/voidful/albert_chinese_base
Albert理论详解:用矩阵分解与跨层参数共享减少参数量的更多相关文章
- [PXE] Linux(centos6)中PXE 服务器搭建,PXE安装、启动及PXE理论详解
[PXE] Linux(centos6)中PXE 服务器搭建,PXE安装.启动及PXE理论详解 本篇blog主要讲述了[PXE] linux(centos)PXE无盘服务器搭建,安装,启动及pxe协议 ...
- Android 布局学习之——Layout(布局)详解二(常见布局和布局参数)
[Android布局学习系列] 1.Android 布局学习之——Layout(布局)详解一 2.Android 布局学习之——Layout(布局)详解二(常见布局和布局参数) 3.And ...
- JVM的GC理论详解
GC的概念 GC:Garbage Collection 垃圾收集.这里所谓的垃圾指的是在系统运行过程当中所产生的一些无用的对象,这些对象占据着一定的内存空间,如果长期不被释放,可能导致OOM(堆溢出) ...
- awk理论详解、实战
答疑解惑: 为什么用awk取IP的时候用$4? ifconfig eth0 | awk -F '[ :]+' 'NR==2{print $4}' IP第二行内容如下: inet addr:10.0.0 ...
- elastic-job详解(五):自定义任务参数
在elastic-job详解(三):Job的手动触发功能一文中讲到了如何手动触发一个Job,但是我们手动触发的时候常常需要输入一些参数.举个栗子:我们有个日统计报表,每天凌晨统计一次,统计上一天的数据 ...
- Logistic回归,梯度上升算法理论详解和实现
经过对Logistic回归理论的学习,推导出取对数后的似然函数为 现在我们的目的是求一个向量,使得最大.其中 对这个似然函数求偏导后得到 根据梯度上升算法有 进一步得到 我们可以初始化向量为0,或者随 ...
- Java基础学习总结(53)——HTTPS 理论详解与实践
前言 在进行 HTTP 通信时,信息可能会监听.服务器或客户端身份伪装等安全问题,HTTPS 则能有效解决这些问题.在使用原始的HTTP连接的时候,因为服务器与用户之间是直接进行的明文传输,导致了用户 ...
- Big Data(四)关于Hadoop的HA&CAP理论详解
问题 思路: 主从集群:结构相对简单,主与从协作 主:单点,数据一致好掌握 问题: 单点故障,集群整体不可用 压力过大,内存受限 解决方案 单点故障: 高可用方案:HA(High Available) ...
- MaxTenuringThreshold与阈值的动态调整理论详解
今天会学习“MaxTenuringThreshold”这样一个新的JVM参数,编写的示例还是会基于上一次的代码,新建个类,如下: 接下来给它设置JVM的参数,具体如下: 而接下来会新增三个参数: 这个 ...
- 华为设备RIP实施和理论详解
1.路由协议基础 共同的目的:更新.维护和控制3层的路由 工作机制: RIP,封装在UDP这个协议上,端口号520(优先级100) OSPF,封装在IP层,协议号89(优先级,内部10,外部是150- ...
随机推荐
- kettle连接mysql报Communications link failure
添加2个命名参数 1.autoReconnect=true 2.useSSL=false
- 7.webpack与vue-cli
一.模块化相关规范 1.1 模块化概述 传统开发模式的主要问题 命名冲突:多个JS文件之间,如果存在重名的变量,会发生变量覆盖问题 文件依赖:JS文件无法实现相互的引用 通过模块化解决上述问题 模块化 ...
- Nginx版本。
Nginx官网提供了三个类型的版本Mainline version:Mainline 是 Nginx 目前主力在做的版本,可以说是开发版Stable version:最新稳定版,生产环境上建议使用的版 ...
- python学习记录(二)-特殊函数
闭包函数 def outer(): var = 100 def inner(): nonlocal var var += 200 print(var) return inner res = outer ...
- 【javascript】关于charCodeAt()方法
在做算法题目leetcode 2283时,看见某些答案会使用charCodeAt(),因为自己没用过,所以作此纪录 描述在 JavaScript 中,charCodeAt() 是一种字符串方法,用于检 ...
- java 通过反射以及MethodHandle执行泛型参数的静态方法
开发过程中遇到一个不能直接调用泛型工具类的方法,因此需要通过反射来摆脱直接依赖. 被调用静态方法示例 public class test{ public static <T> T get( ...
- [Lua]敏感字检测
参考链接: https://zhuanlan.zhihu.com/p/84685657 https://www.cnblogs.com/luguoshuai/p/9254190.html 一开始打算使 ...
- Docker安装:Centos7.6安装Docker
Docker03:Centos7.6安装Docker 前提条件 内核版本 更新yum 包 卸载旧版本(如果安装过旧版本的话) 安装依赖包 设置yum源(阿里云源) 更新缓存 安装容器 启动并加入开机启 ...
- vite不能用@做为路径的解决方法
vite创建vue3后,发现原来用@做为路径的不能用了,报错信息是 Internal server error: Failed to resolve import "@ 在网上查了一下资料, ...
- Python学习笔记--第二阶段啦
初识对象 示例: 类的成员方法 上图中的self必须填写!!! 示例: 类和对象 有c和c++语言基础的话,就会发现其实是一样的道理,只是实现代码有差异 构造方法(init) 示例: 注意: 其他内置 ...