
Flink1.10定义UDAGG遇到SQL validation failed. null 问题
按照以下代码测试定义的UDAGG会一直出现org.apache.flink.table.api.ValidationException: SQL validation failed. null 问题
import org.apache.flink.configuration.JobManagerOptions

import org.apache.flink.table.api.scala.BatchTableEnvironment

import org.apache.flink.table.api.{EnvironmentSettings, TableEnvironment}

import org.apache.flink.table.catalog.hive.HiveCatalog

object testsql {

  def main(args: Array[String]): Unit = {

    val settings = EnvironmentSettings.newInstance()

      .useBlinkPlanner()

      .inStreamingMode()

      .build()

    val tEnv = TableEnvironment.create(settings)

    tEnv.sqlUpdate("create function replaces as 'com.bigdata.util.udf.Replaces'")

    tEnv.sqlUpdate("create function avgprice as \'com.bigdata.util.udf.AvgPriceAgg\'")

    tEnv.sqlUpdate(getSourceSql)//创建数据源

    tEnv.sqlUpdate(getSinkSql)//创建写入表

    tEnv.sqlUpdate(processSql)//处理逻辑

    tEnv.execute("SQL Job")

  }

def getSourceSql = "CREATE TABLE order_info (...) with(...)"

def processSql = "INSERT INTO datasink select avgprice(a.price,a.total_count) as avg_price from order_info a group by a.item_id"

def getSinkSql = "CREATE TABLE datasink (...) with(...)"

}
原来运行时的异常信息找不见了,以下是在单元测试的异常
org.apache.flink.table.api.ValidationException: SQL validation failed. null

    at org.apache.flink.table.calcite.FlinkPlannerImpl.validateInternal(FlinkPlannerImpl.scala:130)

    at org.apache.flink.table.calcite.FlinkPlannerImpl.validate(FlinkPlannerImpl.scala:105)

    at org.apache.flink.table.sqlexec.SqlToOperationConverter.convert(SqlToOperationConverter.java:124)

    at org.apache.flink.table.planner.ParserImpl.parse(ParserImpl.java:66)

    at org.apache.flink.table.api.internal.TableEnvironmentImpl.sqlQuery(TableEnvironmentImpl.java:464)

    at TestAvgPriceAgg.TestAgg(TestAvgPriceAgg.java:49)

    at sun.reflect.NativeMethodAccessorImpl.invoke0(Native Method)

    at sun.reflect.NativeMethodAccessorImpl.invoke(NativeMethodAccessorImpl.java:62)

    at sun.reflect.DelegatingMethodAccessorImpl.invoke(DelegatingMethodAccessorImpl.java:43)

    at java.lang.reflect.Method.invoke(Method.java:498)

    at org.junit.runners.model.FrameworkMethod$1.runReflectiveCall(FrameworkMethod.java:59)

    at org.junit.internal.runners.model.ReflectiveCallable.run(ReflectiveCallable.java:12)

    at org.junit.runners.model.FrameworkMethod.invokeExplosively(FrameworkMethod.java:56)

    at org.junit.internal.runners.statements.InvokeMethod.evaluate(InvokeMethod.java:17)

    at org.junit.runners.ParentRunner$3.evaluate(ParentRunner.java:306)

    at org.junit.runners.BlockJUnit4ClassRunner$1.evaluate(BlockJUnit4ClassRunner.java:100)

    at org.junit.runners.ParentRunner.runLeaf(ParentRunner.java:366)

    at org.junit.runners.BlockJUnit4ClassRunner.runChild(BlockJUnit4ClassRunner.java:103)

    at org.junit.runners.BlockJUnit4ClassRunner.runChild(BlockJUnit4ClassRunner.java:63)

    at org.junit.runners.ParentRunner$4.run(ParentRunner.java:331)

    at org.junit.runners.ParentRunner$1.schedule(ParentRunner.java:79)

    at org.junit.runners.ParentRunner.runChildren(ParentRunner.java:329)

    at org.junit.runners.ParentRunner.access$100(ParentRunner.java:66)

    at org.junit.runners.ParentRunner$2.evaluate(ParentRunner.java:293)

    at org.junit.runners.ParentRunner$3.evaluate(ParentRunner.java:306)

    at org.junit.runners.ParentRunner.run(ParentRunner.java:413)

    at org.junit.runner.JUnitCore.run(JUnitCore.java:137)

    at com.intellij.junit4.JUnit4IdeaTestRunner.startRunnerWithArgs(JUnit4IdeaTestRunner.java:68)

    at com.intellij.rt.execution.junit.IdeaTestRunner$Repeater.startRunnerWithArgs(IdeaTestRunner.java:47)

    at com.intellij.rt.execution.junit.JUnitStarter.prepareStreamsAndStart(JUnitStarter.java:242)

    at com.intellij.rt.execution.junit.JUnitStarter.main(JUnitStarter.java:70)

Caused by: java.lang.NullPointerException

    at org.apache.flink.util.Preconditions.checkNotNull(Preconditions.java:58)

    at org.apache.flink.table.functions.AggregateFunctionDefinition.<init>(AggregateFunctionDefinition.java:48)

    at org.apache.flink.table.functions.FunctionDefinitionUtil.createFunctionDefinition(FunctionDefinitionUtil.java:57)

    at org.apache.flink.table.catalog.FunctionCatalog.resolvePreciseFunctionReference(FunctionCatalog.java:336)

    at org.apache.flink.table.catalog.FunctionCatalog.lambda$resolveAmbiguousFunctionReference$2(FunctionCatalog.java:374)

    at java.util.Optional.orElseGet(Optional.java:267)

    at org.apache.flink.table.catalog.FunctionCatalog.resolveAmbiguousFunctionReference(FunctionCatalog.java:374)

    at org.apache.flink.table.catalog.FunctionCatalog.lookupFunction(FunctionCatalog.java:303)

    at org.apache.flink.table.catalog.FunctionCatalogOperatorTable.lookupOperatorOverloads(FunctionCatalogOperatorTable.java:74)

    at org.apache.calcite.sql.util.ChainedSqlOperatorTable.lookupOperatorOverloads(ChainedSqlOperatorTable.java:73)

    at org.apache.calcite.sql.validate.SqlValidatorImpl.performUnconditionalRewrites(SqlValidatorImpl.java:1194)

    at org.apache.calcite.sql.validate.SqlValidatorImpl.performUnconditionalRewrites(SqlValidatorImpl.java:1179)

    at org.apache.calcite.sql.validate.SqlValidatorImpl.performUnconditionalRewrites(SqlValidatorImpl.java:1209)

    at org.apache.calcite.sql.validate.SqlValidatorImpl.performUnconditionalRewrites(SqlValidatorImpl.java:1179)

    at org.apache.calcite.sql.validate.SqlValidatorImpl.validateScopedExpression(SqlValidatorImpl.java:936)

    at org.apache.calcite.sql.validate.SqlValidatorImpl.validate(SqlValidatorImpl.java:650)

    at org.apache.flink.table.calcite.FlinkPlannerImpl.validateInternal(FlinkPlannerImpl.scala:126)

    ... 30 more
大概意思就是sql校验没有通过,对照代码行数在执行processSql 这句的时候有问题,然后查看TableEnvironment发现只支持注册ScalarFunction,并且没有重载方法
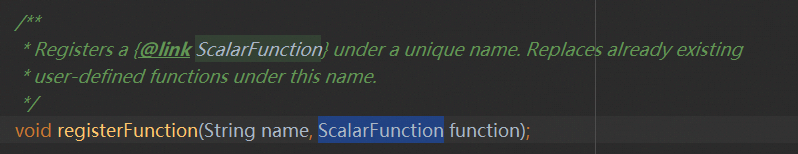
查看源码发现TableEnvironment是顶级接口
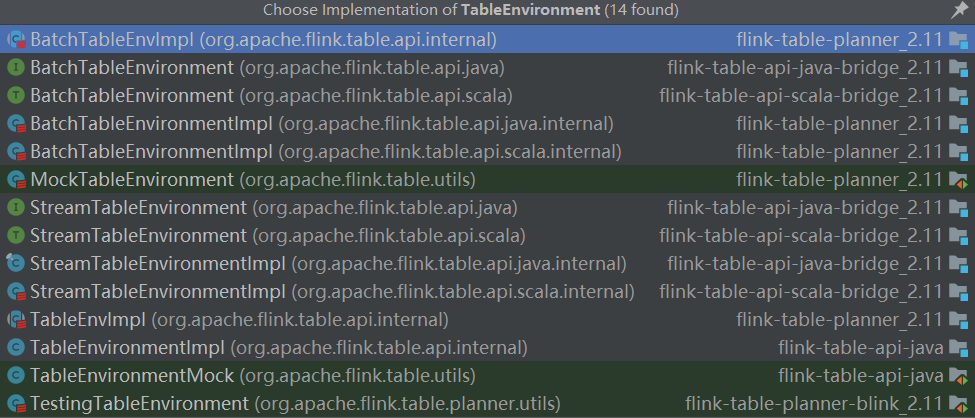
在实现上是 5 个面向用户的接口,在接口底层进行了不同的实现,5 个接口包括一个 TableEnvironment 接口,两个 BatchTableEnvironment 接口,两个 StreamTableEnvironment 接口,5 个接口文件完整路径如下:
org.apache.flink.table.api.TableEnvironment
org.apache.flink.table.api.java.BatchTableEnvironment
org.apache.flink.table.api.java.StreamTableEnvironment
org.apache.flink.table.api.scala.BatchTableEnvironment
org.apache.flink.table.api.scala.StreamTableEnvironment
其中,TableEnvironment 作为统一的接口,其统一性体现在两个方面,一是对于所有基于JVM的语言(即 Scala API 和 Java API 之间没有区别)是统一的;二是对于 unbounded data (无界数据,即流数据) 和 bounded data (有界数据,即批数据)的处理是统一的。TableEnvironment 提供的是一个纯 Table 生态的上下文环境,适用于整个作业都使用 Table API & SQL 编写程序的场景。TableEnvironment 目前只支持Scalar Functions,不支持注册 UDTF 和 UDAF,用户有注册 UDTF 和 UDAF 的需求时,可以选择使用其他 TableEnvironment。
两个 StreamTableEnvironment 分别用于 Java 的流计算和 Scala 的流计算场景,流计算的对象分别是 Java 的 DataStream 和 Scala 的 DataStream。相比 TableEnvironment,StreamTableEnvironment 提供了 DataStream 和 Table 之间相互转换的接口,如果用户的程序除了使用 Table API & SQL 编写外,还需要使用到 DataStream API,则需要使用 StreamTableEnvironment。
两个 BatchTableEnvironment 分别用于 Java 的批处理场景和 Scala 的批处理场景,批处理的对象分别是 Java 的 DataSet 和 Scala 的 DataSet。相比 TableEnvironment,BatchTableEnvironment 提供了 DataSet 和 Table 之间相互转换的接口,如果用户的程序除了使用 Table API & SQL 编写外,还需要使用到 DataSet API,则需要使用 BatchTableEnvironment。
这样就一目了然了,这里使用的TableEnvironment无法支持UDAGG,通过改造使用StreamTableEnvironment就能够完美运行了

import org.apache.flink.streaming.api.CheckpointingMode

import org.apache.flink.streaming.api.environment.CheckpointConfig.ExternalizedCheckpointCleanup

import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment

import org.apache.flink.table.api.{EnvironmentSettings}

import org.apache.flink.table.api.java.StreamTableEnvironment

object tests {

  def main(args: Array[String]): Unit = {

    val settings = EnvironmentSettings.newInstance()

      .useBlinkPlanner()

      .inStreamingMode()

      .build()

    val streamExecEnvironment = getStreamEnv

    val tEnv: StreamTableEnvironment = StreamTableEnvironment.create(streamExecEnvironment, settings)

    tEnv.sqlUpdate("create function replaces as 'com.bigdata.util.udf.Replaces'")

    tEnv.registerFunction("avgprice", new AvgPriceAgg())

    tEnv.sqlUpdate(getSourceSql)

    tEnv.sqlUpdate(getSinkSql)

    tEnv.sqlUpdate(processSql)

    tEnv.execute("SQL Job")

  }

  def getStreamEnv(): StreamExecutionEnvironment = {

    val env = StreamExecutionEnvironment.getExecutionEnvironment

    env.enableCheckpointing(60 * 1000 * 10, CheckpointingMode.EXACTLY_ONCE)

    val config = env.getCheckpointConfig

    //RETAIN_ON_CANCELLATION在job canceled的时候会保留externalized checkpoint state

    config.enableExternalizedCheckpoints(ExternalizedCheckpointCleanup.RETAIN_ON_CANCELLATION)

    //用于指定checkpoint coordinator上一个checkpoint完成之后最小等多久可以出发另一个checkpoint,当指定这个参数时,maxConcurrentCheckpoints的值为1

    config.setMinPauseBetweenCheckpoints(60 * 1000 * 5)

    //用于指定运行中的checkpoint最多可以有多少个,如果有设置了minPauseBetweenCheckpoints,则maxConcurrentCheckpoints这个参数就不起作用了(大于1的值不起作用)

    config.setMaxConcurrentCheckpoints(1)

    //指定checkpoint执行的超时时间(单位milliseconds),超时没完成就会被abort掉

    config.setCheckpointTimeout(60 * 1000 * 15)

    //用于指定在checkpoint发生异常的时候,是否应该fail该task,默认为true,如果设置为false,则task会拒绝checkpoint然后继续运行

    //https://issues.apache.org/jira/browse/FLINK-11662 1.10改为配置失败次数 配置false的话就默认最大2147483647

    config.setFailOnCheckpointingErrors(false)

    env

  }

def getSourceSql = "CREATE TABLE order_info (...) with(...)"

def processSql = "INSERT INTO datasink select avgprice(a.price,a.total_count) as avg_price from order_info a group by a.item_id"

def getSinkSql = "CREATE TABLE datasink (...) with(...)"

}
参考文档:https://blog.csdn.net/weixin_44904816/article/details/102550056
Flink1.10定义UDAGG遇到SQL validation failed. null 问题的更多相关文章
- Validation failed for query for method
问题原因 sql语法,使用@Query("select id, username, usersex, userphone from User where User.usersex = ?1& ...
- (2.10)Mysql之SQL基础——约束及主键重复处理
(2.10)Mysql之SQL基础——约束及主键重复处理 关键词:mysql约束,批量插入数据主键冲突 [1]查看索引: show index from table_name; [2]查看有约束的列: ...
- 异常 Failed to bind NettyServer on /10.133.7.216:29105, cause: Failed to bind to: /0.0.0.0:29105
"C:\Program Files\Java\jdk1.7.0_80\bin\java" -agentlib:jdwp=transport=dt_socket,address=12 ...
- Validation failed for query for method public abstract boxfish.bean.Student boxfish.service.StudentServiceBean.find(java.lang.String)!
转自:https://blog.csdn.net/lzx925060109/article/details/40323741 1. Exception in thread "main&quo ...
- ORA-19563: header validation failed for file
在测试服务器还原数据库时遇到了ORA-19563错误.如下所示 RMAN-00571: ======================================================== ...
- MS SQL错误:SQL Server failed with error code 0xc0000000 to spawn a thread to process a new login or connection. Check the SQL Server error log and the Windows event logs for information about possible related problems
早晨宁波那边的IT人员打电话告知数据库无法访问了.其实我在早晨也发现Ignite监控下的宁波的数据库服务器出现了异常,但是当时正在检查查看其它服务器发过来的各类邮件,还没等到我去确认具体情 ...
- Validation failed for one or more entities. See ‘EntityValidationErrors’解决方法
Validation failed for one or more entities. See ‘EntityValidationErrors’解决方法 You can extract all the ...
- Validation failed for one or more entities. See 'EntityValidationErrors' property for more details.
Validation failed for one or more entities. See 'EntityValidationErrors' property for more details. ...
- Validation failed for one or more entities. See ‘EntityValidationErrors’解决方法【转载】
摘自:http://www.cnblogs.com/douqiumiao/default.aspx?opt=msg Validation failed for one or more entities ...
- “Validation failed for one or more entities”异常的解决办法
日志中出现Entity Framework修改数据库时的错误: Validation failed for one or more entities. See 'EntityValidationErr ...
随机推荐
- php7.3的安装以及在Apache中部署php
安装 php7.3 1.进入php官网:https://www.php.net/downloads.php 2.点击 Windows downloads 3.下载压缩包 4.将下载好的压缩包解压,可选 ...
- 简单搭建react开发环境
目录 前言 一.node.js使用 二.vscode 1.打开文件 2.运行 3. 第一个react程序,从helloworld写起 总结 前言 安装前需要安装:node.js.vscode 一.no ...
- StatisticalOutlierRemoval:离群点移除
1.简介 StatisticalOutlierRemoval滤波器主要用于剔除离群点,或则测量误差导致的粗差点. 滤波思想为:对每一个点的邻域进行一个统计分析,计算它到所有临*点的*均距离.假设得到的 ...
- UEFI引导安装UBUNUT
1.引导方式一定要选UEFI,否则一些显卡驱动将不能安装 2.安装的时候,要在第四个界面,也就是选择覆盖安装还是保留双系统的那个界面,选择其他,一定要自己分区 3.分区: 4.一共5个重要分区: 1. ...
- 01Python变量的使用
Python变量 变量的定义 变量:在程序运行过程中,值会发生变化的量 把程序运算的中间结果临时存到内存里,以备后面的代码继续调用,这几个名字的学名就叫做"变量". 变量的作用 我 ...
- MVC3三层架构
以上部分来自黑马
- 依那西普减量维持过程中RA病人自报病情复发可能预示未来放射学进展[EULAR2015_SAT0147]
依那西普减量维持过程中RA病人自报病情复发可能预示未来放射学进展 SAT0147 SELF-REPORTED FLARES PREDICT RADIOGRAPHIC PROGRESSION IN ...
- 代码随想录-day1
链表 今天主要是把链表专题刷完了,链表专题的题目不是很难,基本都是考察对链表的操作的理解. 在处理链表问题的时候,我们通常会引入一个哨兵节点(dummy),dummy节点指向原链表的头结点.这样,当我 ...
- pg高可用方案repmgr带witness搭建
一.总体架构 操作系统版本: linux redhat7.6pg版本: 12.2repmgr版本 5.2192.168.3.73 主库: repmgr+master192.168.3.74 从库1: ...
- JAVA-GUI创作学校管理系统
1.对于学校的管理系统,我们先做一个简单的一个需求分析,我们需要做学生信息管理,教师信息管理,课程的信息管理.我们要根据自己的需求进行数据库的编写. 简单的添加了几个 2.然后我们通过eclipse+ ...