
Nvidia GPU虚拟化
1 背景
2 GPU虚拟化
- User APP:业务层,如训练或推理任务等
- Framework:框架层,如tensorflow、pytorch、paddle、megengine等
- CUDA Runtime:CUDA Runtime及周边生态库,如cudart、cublas、cudnn、cufft、cusparse等
- CUDA User Driver:用户态CUDA Driver,如cuda、nvml等
- CUDA Kernel Driver:内核态CUDA Driver,参考官方开源代码,如nvidia.ko等
- Nvidia GPU HW:GPU硬件
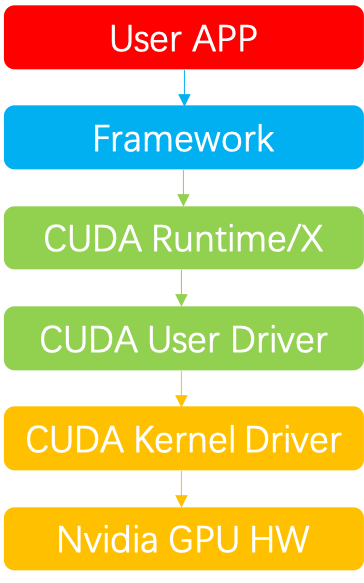
2.1 用户态虚拟化
2.2 内核态虚拟化
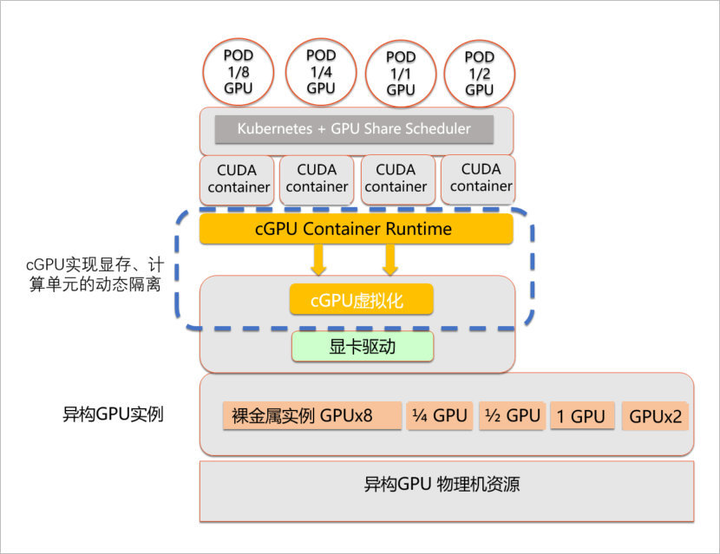
2.3 硬件虚拟化
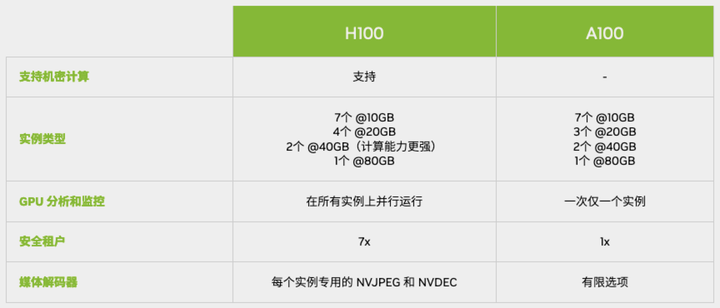
3 其他
3.1 vGPU
3.2 MPS(Multi-Process Service)
Nvidia官方多进程context融合方案,支持将多个进程上的kernel发送到MPS server或者直接发送到GPU上计算,避免了多进程在GPU上context的频繁切换。缺点是故障率较高,特别是故障在进程间扩散一般是不能容忍的。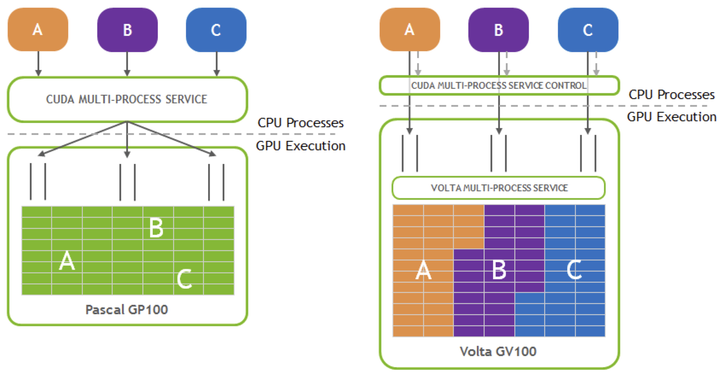
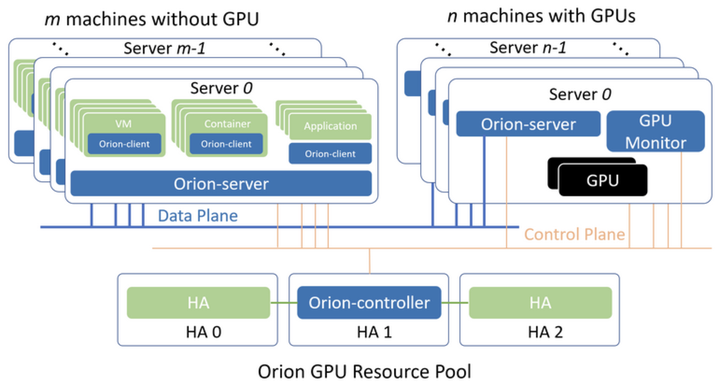
3.3 远程GPU
Nvidia GPU虚拟化的更多相关文章
- HP “云图”GPU虚拟化工作站解决方案
HP PCS ”云图”GPU虚拟化工作站解决方案 ——将图形计算从桌面移到数据中心 惠普云图形GPU虚拟化桌面系统是以用户为中心的私有云服务.除了保留了传统桌面虚拟化方案以集中设备为中心统一管理等优点 ...
- GPU虚拟化技术详解
GPU虚拟化技术详解 GPU英文名称为Graphic Processing Unit,GPU中文全称为计算机图形处理器,1999年由NVIDIA公司提出. 一.GPU概述 GPU这一概念也是相对于计算 ...
- kvmgt-kernel 实现GPU虚拟化
KVMGT-kernel是Intel开源技术01.org推出的一项完整的GPU虚拟化解决方案,在KVM和XEN的基础上实现.本文档对该技术进行相应测试,让大家有个基本参考和了解.KVMGT-kerne ...
- Win10提示“您未连接到nvidia gpu的显示器”的解决方法
显卡有Nvidia 和 ATI两个芯片,我们经常称他们为N卡和A卡,N卡更加注重于性能,而A卡则为颜色艳丽,画面更好.不过,最近一些windows10系统用户在使用N卡过程中,遇到了提示“您当前未使用 ...
- 利用nvidia-smi 管理和监控NVIDIA GPU设备
NVIDIA系统管理界面介绍 原文来源:https://developer.nvidia.com/nvidia-system-management-interface NVIDIA系统管理界面(nvi ...
- NVIDIA GPU Pascal架构简述
NVIDIA GPU Pascal架构简述 本文摘抄自英伟达Pascal架构官方白皮书:https://www.nvidia.com/en-us/data-center/resources/pasca ...
- NVIDIA GPU Volta架构简述
NVIDIA GPU Volta架构简述 本文摘抄自英伟达Volta架构官方白皮书:https://www.nvidia.com/content/dam/en-zz/Solutions/Data-Ce ...
- NVIDIA GPU Turing架构简述
NVIDIA GPU Turing架构简述 本文摘抄自Turing官方白皮书:https://www.nvidia.com/content/dam/en-zz/Solutions/design-vis ...
- NVIDIA GPU自动调度神经网络
NVIDIA GPU自动调度神经网络 对特定设备和工作负载进行自动调整对于获得最佳性能至关重要.这是有关如何使用自动调度器为NVIDIA GPU调整整个神经网络. 为了自动调整神经网络,将网络划分为小 ...
- NVIDIA GPU的快速傅立叶变换
NVIDIA GPU的快速傅立叶变换 cuFFT库提供GPU加速的FFT实现,其执行速度比仅CPU的替代方案快10倍.cuFFT用于构建跨学科的商业和研究应用程序,例如深度学习,计算机视觉,计算物理, ...
随机推荐
- FCC 中级算法题 数组扁平化
Steamroller 对嵌套的数组进行扁平化处理.你必须考虑到不同层级的嵌套. Array.isArray() 思路: (1)遍历arr,如果arr[i]是数组,就重新调用本函数继续循环,然后和新数 ...
- pintia 3-7-5 逆波兰表达式求值 (20 分)
3-7-5 逆波兰表达式求值 (20 分) 逆波兰表示法是一种将运算符(operator)写在操作数(operand)后面 的描述程序(算式)的方法.举个例子,我们平常用中缀表示法描述的算式(1 + ...
- opengl编程天天踩的坑
1. VBO 的 target 是 GL_ARRAY_BUFFER 不是 GL_VERTEX_BUFFER 2. glUniform()用来给uniform传变量 别用成 glProgramUnif ...
- pageTools 一个复用的通知条
<template> <el-card class="page-tools"> <el-row type="flex" align ...
- C/C++ 数据结构顺序栈的基本操作实现
#include <iostream> #include <Windows.h> using namespace std; #define MAXSIZE 6 //顺序栈的实现 ...
- js/css实现图片轮播
实现样式: tplb.css ul, li { padding: 0; margin: 0; list-style: none; } .adver { margin: 0 auto; width: 7 ...
- gdb调试数组访问越界记录
综述 问题来源于力扣的一道域名访问统计题目,我本想以建立首字母索引的方式去统计,但是在申请子域名buffer的地方发现使用malloc(sizeof(char)4)申请出来的buffer每次+1只能增 ...
- react+ant-design-proTable 设置搜索条件中的默认值
需求: 这个规则组ID的 下拉列表是通过向后端请求获取的,如何设置自定义渲染列表,并且默认有值 let groupLists = [] as any, //规则组列表 defaultValue = ' ...
- [jointjs] 自定义shape
前面一篇写了使用jointjs实现自动布局和拖拽缩放,这篇记录一下自定义图形. 首先jointjs内置的图形有很多,文档已经列出来了: 但是有时候这些图形满足不了我们的需求,就需要我们自己去绘制自己想 ...
- pytorch模块介绍:torch.nn
一.简介 nn全称为neural network,意思是神经网络,是torch中构建神经网络的模块. 二.子模块介绍 2.1 nn.functional 该模块包含构建神经网络需要的函数,包括卷积层. ...