
系统架构--分布式计算系统spark学习(三)
通过搭建和运行example,我们初步认识了spark。
大概是这么一个流程
------------------------------ ---------------------- ----------------------
| Application(spark shell) | <=> | Spark Master | <=> | Spark Slavers |
------------------------------ ---------------------- ----------------------
application 发送任务到master,master 接受任务,把上下文分解成一堆task list,把task下发给 Slavers去完成,
slavers完成之后,把结果上报给master,master汇总所有slavers的执行结果,返回给Application。
这里Application,可以是我们自己编写的进程(里面包含要进行分布式计算的数据位置,数据挖掘的算法等)。
但是我们可以看到官方的框架跟我们运行的几个进程好像对不上。
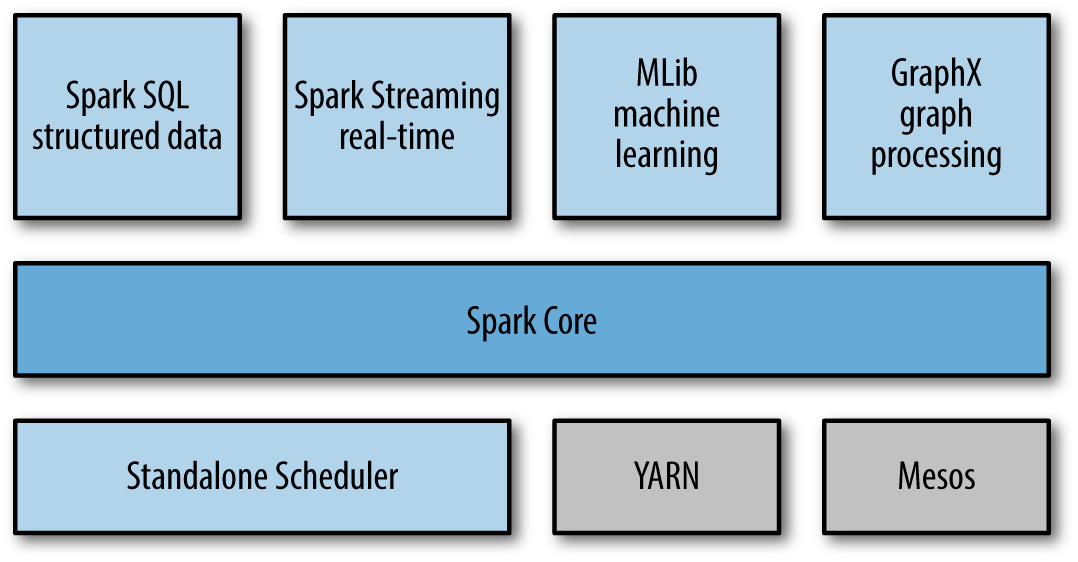
从图里面看到,spark跟mahout一样,更像是一个框架,提供核心功能,然后在核心基础上,又提供很多插件或者说库。
我们之前运行的standalone模式,由Standalone Scheduler来进行集群管理的,这个spark自带的, 看到它使跟Mesos,YARN放在一个层面的,YARN和Mesos怎么管理集群,不清楚,
但清楚的是,spark和它们兼容,可以运行在其之上。
Cluster Managers

Under the hood, Spark is designed to efficiently scale up from one to many thousands of compute nodes. To achieve this while maximizing flexibility, Spark can run over a variety of cluster managers, including Hadoop YARN, Apache Mesos, and a simple cluster manager included in Spark itself called the Standalone Scheduler. If you are just installing Spark on an empty set of machines, the Standalone Scheduler provides an easy way to get started; if you already have a Hadoop YARN or Mesos cluster, however, Spark’s support for these cluster managers allows your applications to also run on them. Chapter 7 explores the different options and how to choose the correct cluster manager.
Spark SQL、Spark Streaming、MLlib等,是在spark core基础上的插件,方便开发者使用sql、支持stream流式数据(疑问:这个跟storm处理是否一样?),机器学习等。
这里最关键的就是spark core了,实现了基本的函数、任务调度、内存管理、容灾等。其中RDDS提供大部分API来跟spark master和其他插件进行交互。
Spark Core

Spark Core contains the basic functionality of Spark, including components for task scheduling, memory management, fault recovery, interacting with storage systems, and more. Spark Core is also home to the API that defines resilient distributed datasets (RDDs), which are Spark’s main programming abstraction. RDDs represent a collection of items distributed across many compute nodes that can be manipulated in parallel. Spark Core provides many APIs for building and manipulating these collections.
回过头来,看看我们启动的几个进程:
//spark shell

root                0.2  6.2    s000  S+    :29下午   :21.81 /usr/bin/java -cp :/private/var/spark/conf:/private/var/spark/lib/spark-assembly-1.3.-hadoop2.4.0.jar:/private/var/spark/lib/datanucleus-api-jdo-3.2..jar:/private/var/spark/lib/datanucleus-core-3.2..jar:/private/var/spark/lib/datanucleus-rdbms-3.2..jar -Dscala.usejavacp=true -Xms1g -Xmx1g org.apache.spark.deploy.SparkSubmit
--class org.apache.spark.repl.Main spark-shell
//spark master and worker

root        0.8 12.7   pts/ Sl   :   : java -cp :/var/spark/sbin/../conf:/var/spark/lib/spark-assembly-1.3.-hadoop2.4.0.jar -XX:MaxPermSize=128m -Dspark.akka.logLifecycleEvents=true -Xms512m -Xmx512m
org.apache.spark.deploy.master.Master --ip qp-zhang --port  --webui-port

root        0.9 11.3   ?      Sl   :   : java -cp :/var/spark/sbin/../conf:/var/spark/lib/spark-assembly-1.3.-hadoop2.4.0.jar -XX:MaxPermSize=128m -Dspark.akka.logLifecycleEvents=true -Xms512m -Xmx512m
org.apache.spark.deploy.worker.Worker spark://qp-zhang:7077
是由不同的class基于spark core 和其他组件实现的。
系统架构--分布式计算系统spark学习(三)的更多相关文章
- Spark Standalone Mode 单机启动Spark -- 分布式计算系统spark学习(一)
spark是个啥? Spark是一个通用的并行计算框架,由UCBerkeley的AMP实验室开发. Spark和Hadoop有什么不同呢? Spark是基于map reduce算法实现的分布式计算,拥 ...
- 提交任务到spark master -- 分布式计算系统spark学习(四)
部署暂时先用默认配置,我们来看看如何提交计算程序到spark上面. 拿官方的Python的测试程序搞一下. qpzhang@qpzhangdeMac-mini:~/project/spark-1.3. ...
- 让spark运行在mesos上 -- 分布式计算系统spark学习(五)
mesos集群部署参见上篇. 运行在mesos上面和 spark standalone模式的区别是: 1)stand alone 需要自己启动spark master 需要自己启动spark slav ...
- Spark Standalone Mode 多机启动 -- 分布式计算系统spark学习(二)(更新一键启动slavers)
捣鼓了一下,先来个手动挡吧.自动挡要设置ssh无密码登陆啥的,后面开搞. 一.手动多台机链接master 手动链接master其实上篇已经用过. 这里有两台机器: 10.60.215.41 启动mas ...
- 2020年大厂Java面试题(基础+框架+系统架构+分布式+实战)
前言 作为一个Java开发者,Java架构师应该是大家的一个职业目标了吧. 要成为Java架构师,首先你要是一个高级Java工程师,熟练使用各种框架,并知道它们实现的原理.jvm虚拟机原理.调优,懂得 ...
- Storm系统架构以及代码结构学习
转自:http://blog.csdn.net/androidlushangderen/article/details/45955833 storm学习系列:http://blog.csdn.net/ ...
- Spark 学习(三) maven 编译spark 源码
spark 源码编译 scala 版本2.11.4 os:ubuntu 14.04 64位 memery 3G spark :1.1.0 下载源码后解压 1 准备环境,安装jdk和scala,具体参考 ...
- 第2-1-1章 FastDFS分布式文件服务背景及系统架构介绍
目录 1 背景 1.1 为什么需要分布式文件服务 1.1.1 单机时代 1.1.2 独立文件服务器 1.1.3 分布式文件系统 1.2 什么是FastDFS 2 系统架构 2.1 Tracker集群 ...
- 浅谈大型web系统架构
动态应用,是相对于网站静态内容而言,是指以c/c++.php.Java.perl..net等服务器端语言开发的网络应用软件,比如论坛.网络相册.交友.BLOG等常见应用.动态应用系统通常与数据库系统. ...
随机推荐
- 对redis深入理解
1.Redis有哪些数据结构? 字符串String.字典Hash.列表List.集合Set.有序集合SortedSet.如果你是Redis中高级用户,还需要加上下面几种数据结构HyperLogLog. ...
- exec系列函数(execl,execlp,execle,execv,execvp)使用
本节目标: exec替换进程映像 exec关联函数组(execl.execlp.execle.execv.execvp) 一,exec替换进程映像 在进程的创建上Unix采用了一个独特的方法,它将进程 ...
- sql server自定义函数
CREATE function [dbo].[f_testFunc]( ) ,) ) ) as begin ); ); ); ); SELECT @str_id = a.id,@str_code = ...
- Tomcat热部署及错误排查
Maven的热部署 第一步:配置Tomcat的登陆的用户名与密码 C:\apache-tomcat-7.0.33\conf\ tomcat-users.xml 从第36行开始配置 <r ...
- 基于Xilinx的Synthesize
所谓综合.就是讲HDL语言.原理图等设计输入翻译成由与.或.非们和RAM.触发器登记本逻辑单元的逻辑连接(即网表).并依据目标和要求(约束条件)优化生成的逻辑连接. ISE-XST XST是Xilin ...
- web服务器优化的一些思路
作为一个新手(并不是菜鸟,而是像我们这样的学生),维护一个网站往往是一个很头疼的问题,尤其是动态网站,更尤其是用java写的网站. 当网站的吞吐量很小的时候你会发现服务器根本不需要维护,因为几乎没有延 ...
- python 图像处理基础操作
Python 读取图片文件为矩阵和保存矩阵为图片 读取图片为矩阵 import matplotlib im = matplotlib.image.imread('0_0.jpg') 保存矩阵为图片 i ...
- 【BZOJ】1628 && 1683: [Usaco2007 Demo]City skyline 城市地平线(单调栈)
http://www.lydsy.com/JudgeOnline/problem.php?id=1628 http://www.lydsy.com/JudgeOnline/problem.php?id ...
- superresolution_v_2.0 Application超分辨率程序文档
SUPERRESOLUTION GRAPHICAL USER INTERFACE DOCUMENTATION Contents 1.- How to use this application. 2.- ...
- python定义函数时的默认返回值
python定义函数时,一般都会有指定返回值,如果没有显式指定返回值,那么python就会默认返回值为None, 即隐式返回语句: return None 执行如下代码 def now(): prin ...