
第三章——供机器读取的数据(XML)
本书使用的文件、代码:https://github.com/huangtao36/data_wrangling
第三章使用的数据文件:
XML数据

XML中有两个位置可以保存数据:
1、两个标签之间:<Display>71</Display>
2、标签的属性:<Dim Category="SEX" Code="BTSX"/>——其中Category的属性值是“SEX”,Code的属性值是"BTSX"。
XML的属性可以保存特定标签的额外信息,这些标签又嵌套在另一个标签中。
实现代码(基于Python3)
from xml.etree import ElementTree as ET

tree = ET.parse('data-text.xml')

root = tree.getroot()   #获取树的根元素

data = root.find('Data')

all_data = []

for observation in data:

    record = {}

    for item in observation:

        lookup_key_List = list(item.attrib.keys())

        lookup_key = lookup_key_List[0]

        if lookup_key == 'Numeric':

            rec_key = 'NUMERIC'

            rec_value = item.attrib['Numeric']

        else:

            rec_key = item.attrib[lookup_key]

            rec_value = item.attrib['Code']

        record[rec_key] = rec_value

    all_data.append(record)

print (all_data)
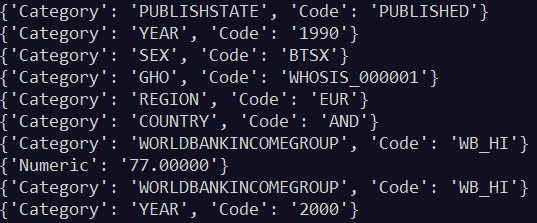
输出(部分):

(输出的是单行数据,为了直观,这里进行了处理。)
代码解释
from xml.etree import ElementTree as ET
本例中使用的是ElementTree、还可以使用lxml、minidom这两种库来解析XML文件,在此不做说明
获取Observation元素中的内容
由上面的样本可知,我们使用的数据是包含在一个<Data>...</Data>中的,这里使用根元素的find方法可以利用标签名来搜索子元素。
from xml.etree import ElementTree as ET

tree = ET.parse('data-text.xml')

root = tree.getroot()   #获取树的根元素

data = root.find('Data')

for observation in data:

    for item in observation:

        print(item.attrib)
输出(部分):
from xml.etree import ElementTree as ET

tree = ET.parse('data-text.xml')

root = tree.getroot()   #获取树的根元素

data = root.find('Data')

all_data = []

for observation in data:

    record = {}

    for item in observation:

        lookup_key_List = list(item.attrib.keys())

        lookup_key = lookup_key_List[0]

        rec_key = item.attrib[lookup_key]

        print(rec_key)
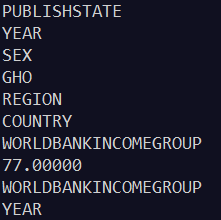
上面代码得到了数据的键,但还没有取得相应的值。
lookup_key_List = list(item.attrib.keys())

lookup_key = lookup_key_List[0]
from xml.etree import ElementTree as ET

tree = ET.parse('data-text.xml')

root = tree.getroot()   #获取树的根元素

data = root.find('Data')

all_data = []

for observation in data:

    record = {}

    for item in observation:

        lookup_key_List = list(item.attrib.keys())

        lookup_key = lookup_key_List[0]

        if lookup_key == 'Numeric':

            rec_key = 'NUMERIC'

            rec_value = item.attrib['Numeric']

        else:

            rec_key = item.attrib[lookup_key]

            rec_value = item.attrib['Code']

        print(rec_key,rec_value)

第三章——供机器读取的数据(XML)的更多相关文章
- 第三章——供机器读取的数据(CSV与JSON)
本书使用的文件.代码:https://github.com/huangtao36/data_wrangling 机器可读(machine readable)文件格式: 1.逗号分隔值(Comma-Se ...
- python数据处理(一)之供机器读取的数据 csv,json,xml
代码与资料 https://github.com/jackiekazil/data-wrangling 1 csv 1.1导入csv数据 1.2将代码保存到文件中并在命令行中运行 2.json 2 导 ...
- 第三章:使用ListView展示数据
一.ImageList:存储图像集合 Images 存储的所有图像 ImageSize 图像的大小 ColorDepth 颜色数 TransparentColor 被视为透明的颜色 先设置ColorD ...
- 数据库-第三章 关系数据库标准语言SQL-3.3 数据查询
数据查询 例: 一.单表查询 1.定义 是指仅涉及一个表的查询 2.选择表中的若干列 查询指定列 例: 查询全部列 例: 查询经过计算的值 例: 3.选择表中的若干元组 消除取值重复的行 例: 查询满 ...
- SQL SERVER 2012 第三章 使用INSERT语句添加数据
INSERT [TOP (<expression>) [PERCENT] [INTO] <tabular object>[(column list)][OUTPUT <o ...
- (第二章第三部分)TensorFlow框架之读取二进制数据
系列博客链接: (第二章第一部分)TensorFlow框架之文件读取流程:https://www.cnblogs.com/kongweisi/p/11050302.html (第二章第二部分)Tens ...
- Laxcus大数据管理系统2.0(5)- 第三章 数据存取
第三章 数据存取 当前的很多大数据处理工作,一次计算产生几十个GB.或者几十个TB的数据已是正常现象,驱动数百.数千.甚至上万个计算机节点并行运行也已经不足为奇.但是在数据处理的后面,对于这种在网络间 ...
- CentOS6安装各种大数据软件 第三章:Linux基础软件的安装
相关文章链接 CentOS6安装各种大数据软件 第一章:各个软件版本介绍 CentOS6安装各种大数据软件 第二章:Linux各个软件启动命令 CentOS6安装各种大数据软件 第三章:Linux基础 ...
- (第二章第二部分)TensorFlow框架之读取图片数据
系列博客链接: (第二章第一部分)TensorFlow框架之文件读取流程:https://www.cnblogs.com/kongweisi/p/11050302.html 本文概述: 目标 说明图片 ...
随机推荐
- 爬取猫眼TOP100
学完正则的一个小例子就是爬取猫眼排行榜TOP100的所有电影信息 看一下网页结构: 可以看出要爬取的信息在<dd>标签和</dd>标签中间 正则表达式如下: pattern ...
- Leecode刷题之旅-C语言/python-121买卖股票的最佳时机
/* * @lc app=leetcode.cn id=121 lang=c * * [121] 买卖股票的最佳时机 * * https://leetcode-cn.com/problems/best ...
- 小程序开发-10-新版Music组件、组件通信与wxss样式复用
加入缓存提升用户体验 思路:先从缓存中寻找数据或者从服务器中获取数据写入缓存中 优点:减少网络访问次数,提升用户体验 解决缓存带来的问题 问题:比如原先是不喜欢的在点击喜欢的时候,跳到下一期刊后返回来 ...
- Apache Tomcat 8.5 安全配置与高并发优化
通常我们在生产环境中,Tomcat的默认配置显然不能满足我们的产品需求,所以很多时候都需要对Tomcat的配置进行调优,以下综合我自己的经验来配置 Tomcat 安全与优化情况,如果你有更好的方案,请 ...
- 杭州优步uber司机第一组奖励政策
-8月9日更新- 优步杭州第一组: 定义为激活时间在2015/6/8之前的车主(以优步后台数据显示为准) 滴滴快车单单2.5倍,注册地址:http://www.udache.com/如何注册Uber司 ...
- rm 删除不掉文件,报错解决 以及 chattr的介绍
rm 强制删除一个文件 居然删除不掉! 出现这个错误: rm: cannot remove ‘default/.user.ini’: Operation not permitted 原来呀: 然后呢 ...
- ORB-SLAM(十二)优化
ORB-SLAM中优化使用g2o库,先复习一下g2o的用法,上类图 其中SparseOptimizer就是我们需要维护的优化求解器,他是一个优化图,也是一个超图(包含若干顶点和一元二元多元边),怎样定 ...
- C#如何使用反射实现通过字符串创建类
在做项目中碰到一个问题,就是如何在知道一个类的名字,如何创建这个类呢.做的一个小测试,直接贴代码了. using System; using System.Collections.Generic; u ...
- ACID、数据库隔离级别
ACID: A(Atomicity):原子性,要么全部执行,要么都不执行 C(consistency):一致性: 特点: 1.一个操作除法级联,这些必须成功,否则全部失败(原子性) 2.所有节点同步更 ...
- UniMelb Comp30022 IT Project (Capstone) - 2.Vuforia in Unity
2 Vuforia in Unity Tutorial: https://www.youtube.com/watch?v=X6djed8e4n0&t=213s Preparation: Dow ...