
Spark在MaxCompute的运行方式
一、Spark系统概述
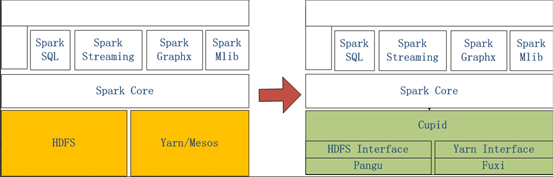
左侧是原生Spark的架构图,右边Spark on MaxCompute运行在阿里云自研的Cupid的平台之上,该平台可以原生支持开源社区Yarn所支持的计算框架,如Spark等。
二、Spark运行在客户端的配置和使用
2.1打开链接下载客户端到本地
2.2将文件上传的ECS上
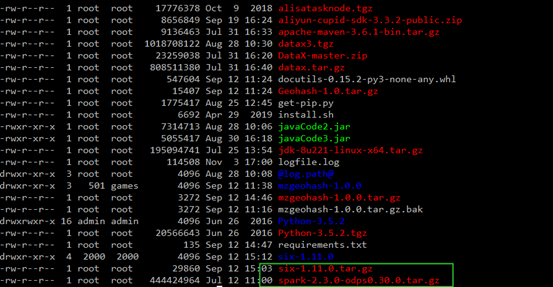
2.3将文件解压
tar -zxvf spark-2.3.0-odps0.30.0.tar.gz

2.4配置Spark-default.conf
# spark-defaults.conf

# 一般来说默认的template只需要再填上MaxCompute相关的账号信息就可以使用Spark

spark.hadoop.odps.project.name =

spark.hadoop.odps.access.id =

spark.hadoop.odps.access.key =

# 其他的配置保持自带值一般就可以了

spark.hadoop.odps.end.point = http://service.cn.maxcompute.aliyun.com/api

spark.hadoop.odps.runtime.end.point = http://service.cn.maxcompute.aliyun-inc.com/api

spark.sql.catalogImplementation=odps

spark.hadoop.odps.task.major.version = cupid_v2

spark.hadoop.odps.cupid.container.image.enable = true

spark.hadoop.odps.cupid.container.vm.engine.type = hyper
2.5在github上下载对应代码
https://github.com/aliyun/MaxCompute-Spark
2.5将代码上传到ECS上进行解压
unzip MaxCompute-Spark-master.zip
2.6将代码打包成jar包(确保安装Maven)
cd MaxCompute-Spark-master/spark-2.x

mvn clean package
2.7查看jar包,并进行运行
bin/spark-submit --master yarn-cluster --class com.aliyun.odps.spark.examples.SparkPi \

MaxCompute-Spark-master/spark-2.x/target/spark-examples_2.11-1.0.0-SNAPSHOT-shaded.jar
三、Spark运行在DataWorks的配置和使用
3.1进入DataWorks控制台界面,点击业务流程
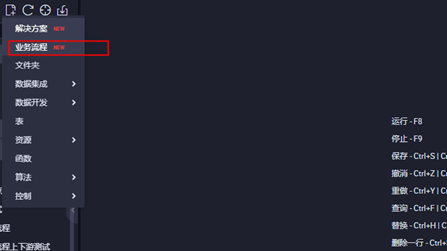
3.2打开业务流程,创建ODPS Spark节点
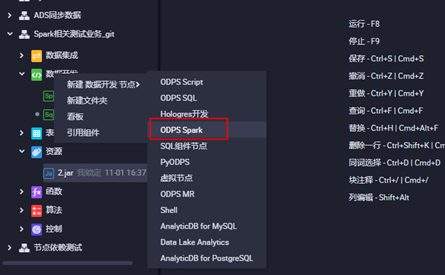
3.3上传jar包资源,点击对应的jar包上传,并提交
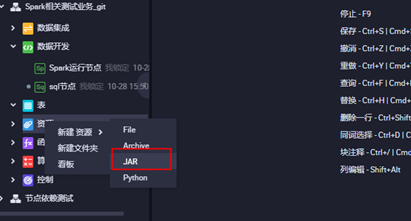
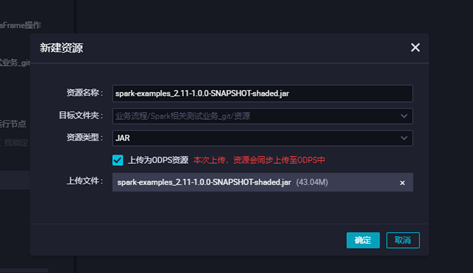
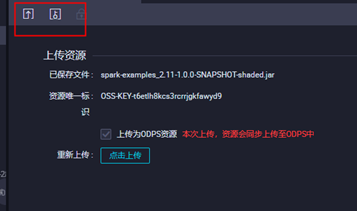
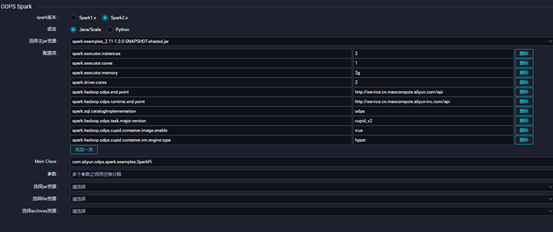
3.4配置对应ODPS Spark的节点配置点击保存并提交,点击运行查看运行状态
四、Spark在本地idea测试环境的使用
4.1下载客户端与模板代码并解压
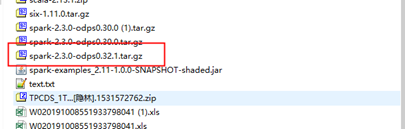
模板代码:
https://github.com/aliyun/MaxCompute-Spark
4.2打开idea,点击Open选择模板代码
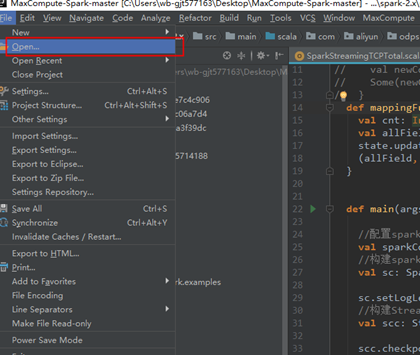
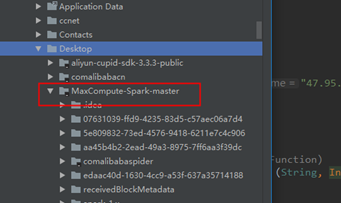
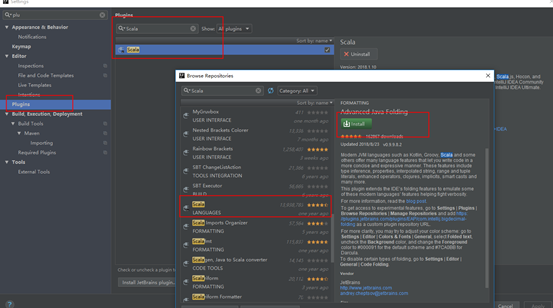
4.2安装Scala插件
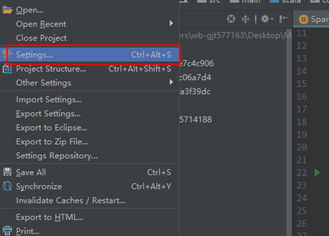
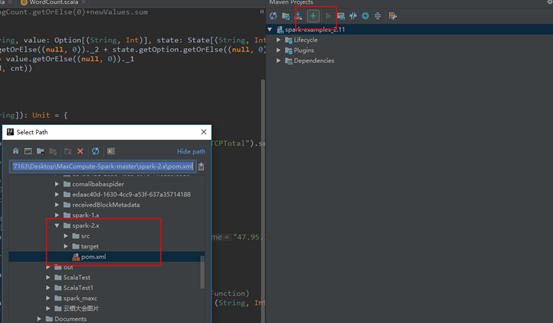
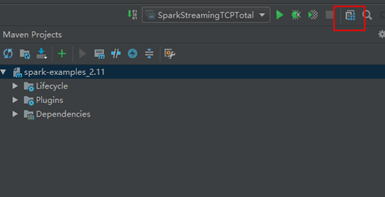
4.3配置maven
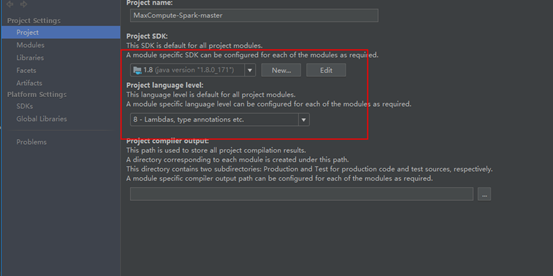
4.4配置JDK和相关依赖
本文作者:耿江涛
本文为云栖社区原创内容,未经允许不得转载。
Spark在MaxCompute的运行方式的更多相关文章
- 「Spark」Spark SQL Thrift Server运行方式
Spark SQL可以使用JDBC/ODBC或命令行接口充当分布式查询引擎.这种模式,用户或者应用程序可以直接与Spark SQL交互,以运行SQL查询,无需编写任何代码. Spark SQL提供两种 ...
- MaxCompute Spark开发指南
0. 概述 本文档面向需要使用MaxCompute Spark进行开发的用户使用.本指南主要适用于具备有Spark开发经验的开发人员. MaxCompute Spark是MaxCompute提供的兼容 ...
- MaxCompute问答整理之7月
本文是基于本人对MaxCompute产品的学习进度,再结合开发者社区里面的一些问题,进而整理成文.希望对大家有所帮助. 问题一.DataWorks V2.0简单模式和标准模式的区别?公司数仓的数据上云 ...
- 阿里云大数据计算服务 - MaxCompute (原名 ODPS)
MaxCompute 是阿里EB级计算平台,经过十年磨砺,它成为阿里巴巴集团数据中台的计算核心和阿里云大数据的基础服务.去年MaxCompute 做了哪些工作,这些工作背后的原因是什么?大数据市场进入 ...
- 一文快速了解MaxCompute
很多刚初次接触MaxCompute的用户,面对繁多的产品文档内容以及社区文章,往往很难快速.全面了解MaxCompute产品全貌.同时,很多拥有大数据开发经验的开发者,也希望能够结合自身的背景知识,将 ...
- spark学习(基础篇)--(第三节)Spark几种运行模式
spark应用执行机制分析 前段时间一直在编写指标代码,一直采用的是--deploy-mode client方式开发测试,因此执行没遇到什么问题,但是放到生产上采用--master yarn-clus ...
- 【互动问答分享】第10期决胜云计算大数据时代Spark亚太研究院公益大讲堂
“决胜云计算大数据时代” Spark亚太研究院100期公益大讲堂 [第10期互动问答分享] Q1:Spark on Yarn的运行方式是什么? Spark on Yarn的运行方式有两种:Client ...
- Hive数据如何同步到MaxCompute之实践讲解
摘要:本次分享主要介绍 Hive数据如何迁移到MaxCompute.MMA(MaxCompute Migration Assist)是一款MaxCompute数据迁移工具,本文将为大家介绍MMA工具的 ...
- MaxCompute新功能发布
2018年Q3 MaxCompute重磅发布了一系列新功能. 本文对主要新功能和增强功能进行了概述. 实时交互式查询:Lightning on MaxCompute 生态兼容:Spark on Max ...
随机推荐
- Idea导入项目详解
1.点击Import Project选择项目所在目录 2.Import Project选项区别: 1)如果选择Create project from existing sources选项, 则你只能导 ...
- 三十四、python中shutil模块的介绍
'''A.shutil:高级的文件 文件夹 压缩包 处理模块''' import shutil '''1.copyfileobj(a1,a2,lenth):将文件内容拷贝到另一个文件中''' shut ...
- 小程序框架MpVue踩坑日记(二)
数据嵌套超过三层或者等于三层的时候 父组件传值给子组件后,如果子组件内的值需要改变 通过this.emit()传值后,父组件的值虽然会改变,但是视图并不会重新渲染 原因就是数据嵌套太多,没有触发ren ...
- tail()函数
与head()函数类似,默认是取dataframe中的最后五行. 函数源码: def tail(self, n=): """ Returns last n rows &q ...
- Week 5 - 529.Minesweeper
529.Minesweeper Let's play the minesweeper game (Wikipedia, online game)! You are given a 2D char ma ...
- android dialog,popupwindow,toast窗口的添加机制
Dialog 窗口添加机制 代码示例 首先举两个例子: 例子1 在Activity中 @OnClick(R.id.but) void onClick() { Log.d("LiaBin&qu ...
- 关于存储过程的一些sql
1.关于事务的回滚Set XACT_ABORT ON; 开启为on时 ,如果事务语句产生运行错误 ,将整个事务终止进行回滚,Off时只回滚产生错误的语句. 2.获取事务语句中上一次插入值的行号@@ID ...
- python+selenium元素定位——8种方法
定位元素,selenium提供了8中元素定位方法: (1)find_element_by_id() :html规定,id在html中必须是唯一的,有点类似于身份证号 (2)find_element_b ...
- C#MessageBox 自动关闭窗口
1:MessageBox弹出的模式窗口会先阻塞掉它的父级线程.所以我们可以考虑在MessageBox前先增加一个用于"杀"掉MessageBox窗口的线程.因为需要在规定时间内&q ...
- hibernate的get方法和load方法区别
读者需注意:Hibernate版本不同,运行机制不太一样,以下是hibernate3.x作为讲解 get方法: Hibernate会确认一下该id对应的数据是否存在,首先在session缓存中查找,然 ...