
python爬取+使用网易卡搭作品数量api
第一步,当然是打开浏览器~
然后打开卡搭~
看着熟悉的界面,是不是有点不知所措?
这就对了,咱找点事情干干。

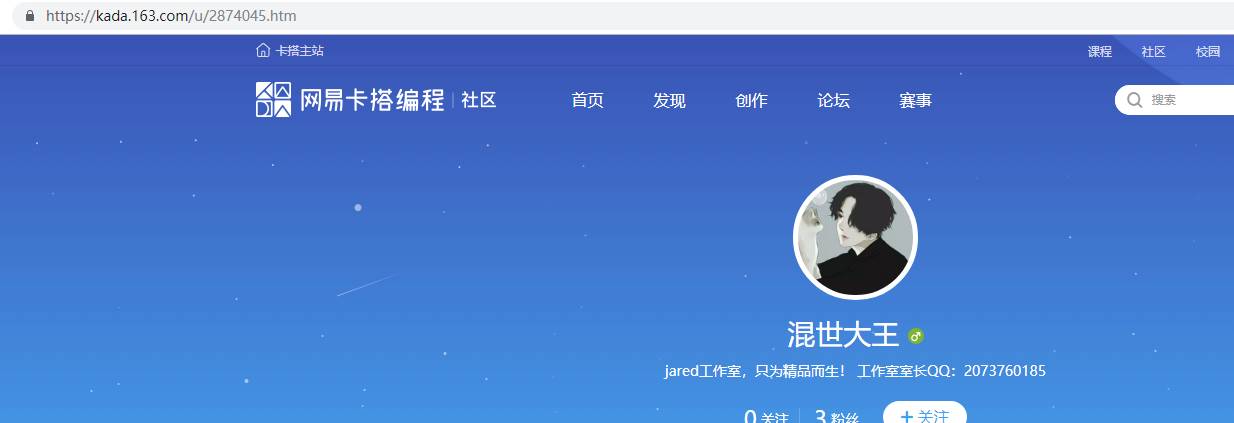
随便找个倒霉蛋,比如这位:“混世大王”,打开他的主页!
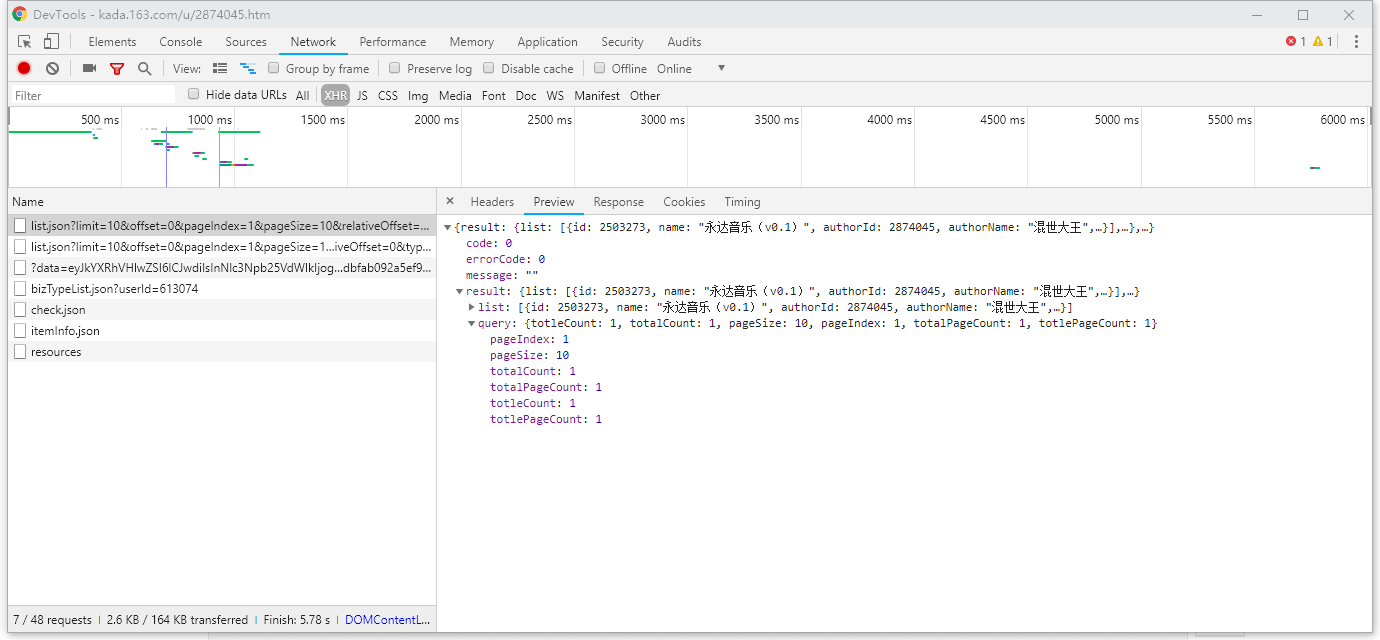
按下f12(我这个是chrome,别的浏览器可能不一样),选进“network",ctrl+r刷新;

在过滤器里选”XHR“,从第一个往下看,如果代码是下图这样的,那就右键在新标签页打开,能看到api返回的数据。
如果不是,就点下一个;
让我们仔细观察一下API返回的数据:
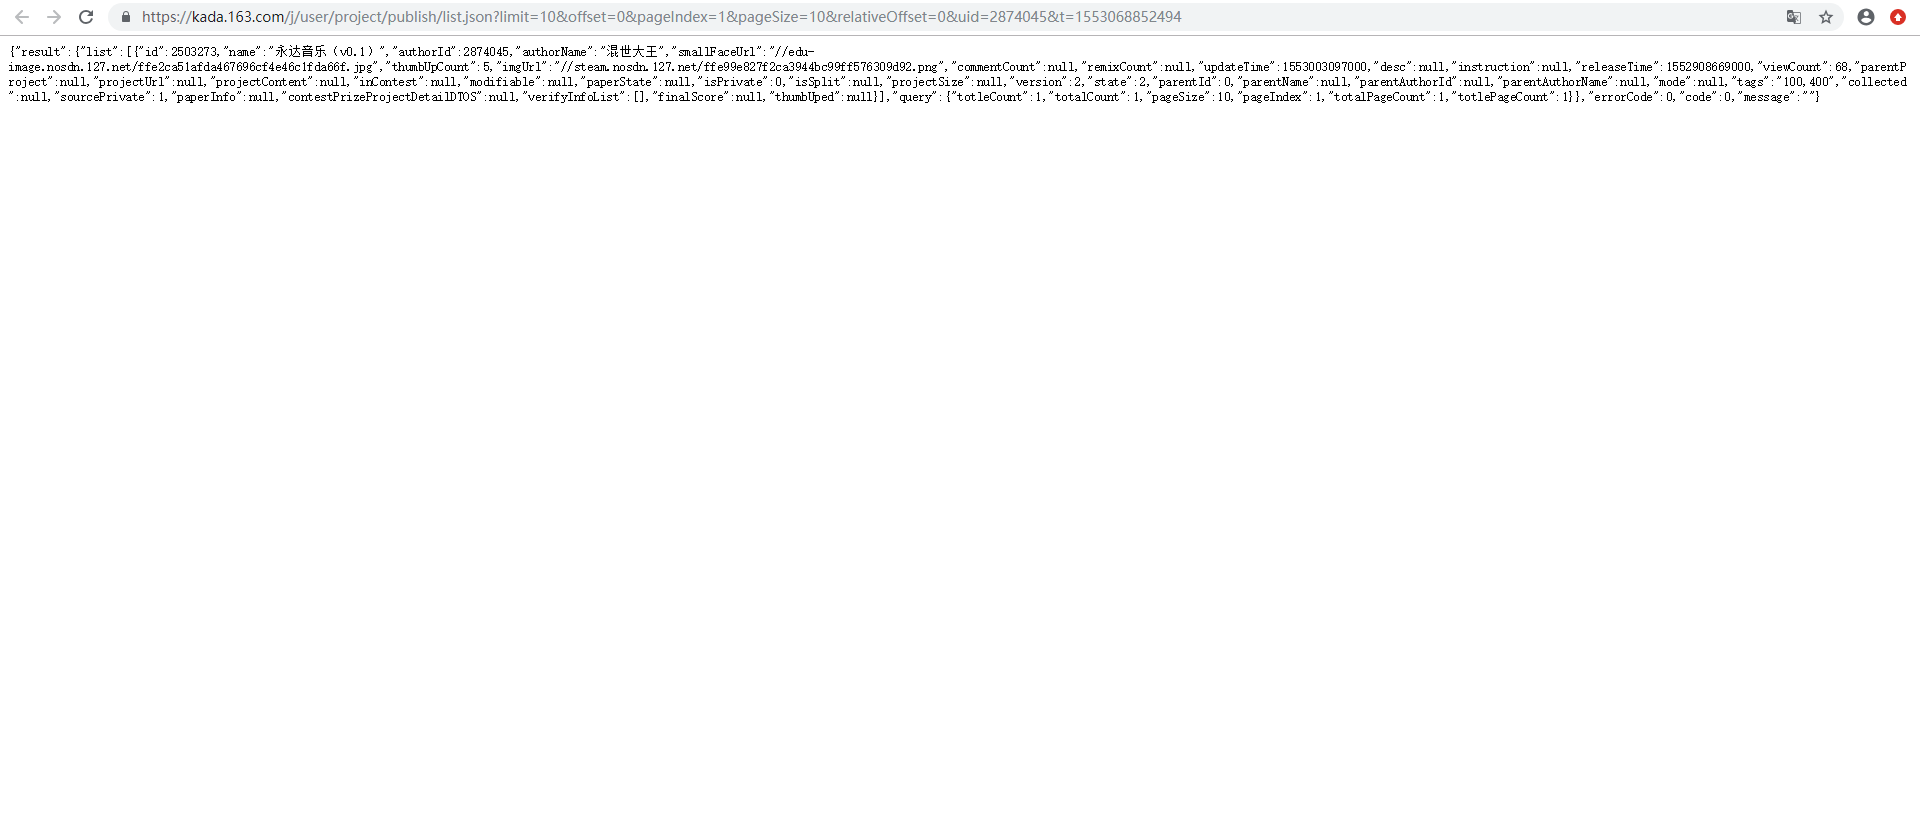
api返回的数据分为很多层,我们要找的就是"totalCount",作品总数。这项数据外面有两层:'result' 'query‘。
api找好了,把地址栏的地址复制下来,根据找到的api写代码吧!
import requests   #笨猫出品,必属精品

def get_api():

# 请求头

    headers = {

        "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,image/webp,image/apng,*/*;q=0.8",

        "Accept-Encoding": "gzip, deflate, br",

        "Accept-Language": "zh-CN,zh;q=0.8,zh-TW;q=0.7,zh-HK;q=0.5,en-US;q=0.3,en;q=0.2",

        "Host": "kada.163.com",

        "Referer": "https://kada.163.com/",

        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/70.0.3538.77 Safari/537.36",

    }

    id = input("请输入id:");    # 输入id

    api_url = "https://kada.163.com/j/user/project/publish/list.json?limit=10&offset=0&pageIndex=1&pageSize=10&relativeOffset=0&uid=" + id

# 开始请求

    res = requests.get(api_url, headers=headers)

    online_dic = res.json()

    print(online_dic)

    print("作品数:%d" % online_dic['result']['query']['totalCount'])   #输出

if __name__ == '__main__':

    get_api()
运行效果:输入uid,输出他的作品数量

python爬取+使用网易卡搭作品数量api的更多相关文章
- Python 爬取所有51VOA网站的Learn a words文本及mp3音频
Python 爬取所有51VOA网站的Learn a words文本及mp3音频 #!/usr/bin/env python # -*- coding: utf-8 -*- #Python 爬取所有5 ...
- python爬取股票最新数据并用excel绘制树状图
大家好,最近大A的白马股们简直 跌妈不认,作为重仓了抱团白马股基金的养鸡少年,每日那是一个以泪洗面啊. 不过从金融界最近一个交易日的大盘云图来看,其实很多中小股还是红色滴,绿的都是白马股们. 以下截图 ...
- Python爬取网易云热歌榜所有音乐及其热评
获取特定歌曲热评: 首先,我们打开网易云网页版,击排行榜,然后点击左侧云音乐热歌榜,如图: 关于如何抓取指定的歌曲的热评,参考这篇文章,很详细,对小白很友好: 手把手教你用Python爬取网易云40万 ...
- python爬取网站数据
开学前接了一个任务,内容是从网上爬取特定属性的数据.正好之前学了python,练练手. 编码问题 因为涉及到中文,所以必然地涉及到了编码的问题,这一次借这个机会算是彻底搞清楚了. 问题要从文字的编码讲 ...
- python爬取某个网页的图片-如百度贴吧
python爬取某个网页的图片-如百度贴吧 作者:vpoet mail:vpoet_sir@163.com 注:随意copy,不用告诉我 #coding:utf-8 import urllib imp ...
- Python:爬取乌云厂商列表,使用BeautifulSoup解析
在SSS论坛看到有人写的Python爬取乌云厂商,想练一下手,就照着重新写了一遍 原帖:http://bbs.sssie.com/thread-965-1-1.html #coding:utf- im ...
- 使用python爬取MedSci上的期刊信息
使用python爬取medsci上的期刊信息,通过设定条件,然后获取相应的期刊的的影响因子排名,期刊名称,英文全称和影响因子.主要过程如下: 首先,通过分析网站http://www.medsci.cn ...
- python爬取免费优质IP归属地查询接口
python爬取免费优质IP归属地查询接口 具体不表,我今天要做的工作就是: 需要将数据库中大量ip查询出起归属地 刚开始感觉好简单啊,毕竟只需要从百度找个免费接口然后来个python脚本跑一晚上就o ...
- Python爬取豆瓣指定书籍的短评
Python爬取豆瓣指定书籍的短评 #!/usr/bin/python # coding=utf-8 import re import sys import time import random im ...
随机推荐
- [干货分享] AXURE-整套高保真UI框架和元件组(暗黑风格)
写在前面 在我们的开发团队里,一般在产品通过策划和需求评审后,在还没开始设计之前,产品经理和美工会一起定一套UI规范. 一方面用于规范整体界面,防止界面开发过程中出现UI不一致性的情况(有时候标准 ...
- 宝塔面板安装的mysql5.5用命令行kill -9后启动不了
1.查看mysql版本方法一:status;方法二:select version(); 2.Mysql启动.停止.重启常用命令a.启动方式1.使用 service 启动:[root@localhost ...
- laravel-mix 热重载404的问题
在项目中,使用npm run hot时,无法加载 http://localhost:8080/js/app.js 以及 http://localhost:8080/css/app.css 版本 Lar ...
- NIO学习之Channel
一.Channel基础 通道是一个对象,通过它可以读取和写入数据,Channel就是通向什么的道路,为数据的流向提供渠道: 在传统IO中,我们要读取一个文件中的内容使用Inputstream,该str ...
- elasticsearch 2.4 windows版jvm内存设置
本文编写目的是因为网上有很多es修改内存配置的文章,方法也各有不同,但在我的情况下(es 2.4 windows版)发现很多方法都是无效的,有效只有以下方法 第一个是xms,第二个是xmx
- LNK2005错误——重复定义错误
编程中经常能遇到LNK2005错误——重复定义错误,其实LNK2005错误并不是一个很难解决的错误.弄清楚它形成的原因,就可以轻松解决它了. 造成LNK2005错误主要有以下几种情况: 1.重复定义全 ...
- ImageLoader常用方法注释
ImageLoader中的常用方法及相关作用注释 ImageLoader 的ImageLoaderConfiguration config 配置 ImageLoaderConfiguration co ...
- 实现strcpy函数
不使用库函数,实现strcpy函数: char *my_strcpy(char *t,char *s){ char *strDest=t; if(t==NULL && s==NULL) ...
- Python中的绝对路径和相对路径
大牛们应该对路径都很了解了,这篇文章主要给像我这样的入门小白普及常识用的,啊哈 下面的路径介绍针对windows,其他平台的暂时不是很了解. 在编写的py文件中打开文件的时候经常见到下面其中路径的表达 ...
- json格式引起的 parse 报错
json格式: {"ID":"4","PICDATAS":"[{"picDevNo": 1},{"p ...