
语音降噪论文“A Hybrid Approach for Speech Enhancement Using MoG Model and Neural Network Phoneme Classifier”的研读
最近认真的研读了这篇关于降噪的论文。它是一种利用混合模型降噪的方法,即既利用了生成模型(MoG高斯模型),也利用了判别模型(神经网络NN模型)。本文根据自己的理解对原理做了梳理。
论文是基于“Speech Enhancement Using a Mixture-Maximum Model”提出的MixMAX模型的。假设噪声是加性噪声,干净语音为x(t),噪声为y(t),则在时域带噪语音z(t)可以表示为z(t) = x(t) + y(t)。对z(t)做短时傅里叶变换(STFT)得到Z(k),再取对数谱(log-spectral)可得到Zk(k表示对数谱的第k维,即对数谱的第k个频段(frequency bin)。若做STFT的样本有L个,则对数谱的维数是 L/2 + 1)。相应的可得到Xk和Yk。MixMAX模型是指加噪后语音的每个频段上的值Zk是对应的Xk和Yk中的大值,即 = MAX(Xk, Yk)。
语音x由音素组成,设定一个音素可用一个高斯表示。假设音素有m个,则干净语音的密度函数f(x)可以表示成下式:

fi(x)表示第i个音素的密度函数。由于x是用多维的对数谱表示的,且各维向量之间相互独立,所以fi(x)可以表示成各维向量的密度函数fi,k(xk)的乘积。各维的密度函数表示如下式:
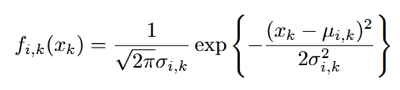
μi,k表示这一维上的均值,δi,k表示这一维上的方差。ci表示这个音素所占的权重,权重的加权和要为1。
噪声y只用一个高斯表示。同语音一样,y也是用多维的对数谱表示的,y的密度函数可以表示如下:
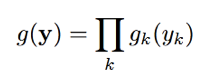
同样gk(yk)表示如下:
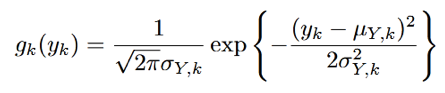
对于y每一维上的密度函数,其概率分布函数Gk(y)为:
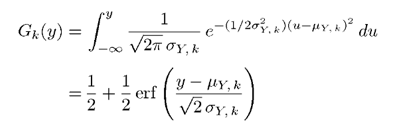
其中erf()为误差函数,表示如下:

同理可求得干净语音中每个音素的每一维上的概率分布函数,如下式:
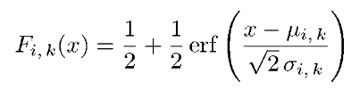
对于带噪语音Z来说,当语音音素给定时(即i给定时)其对数谱的第k维分量Zk的分布函数Hi,k(z)可以通过下式求得:

上式就是求I = i时的条件概率。由于X和Y相互独立,就变成了X和Y的第k维向量上的分布函数的乘积。对Zk的分布函数Hi,k(z)求导,就得到了的密度函数hi,k(z),表示如下:
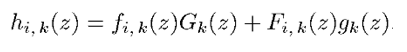
所以z的密度函数h(z)通过下式求得:
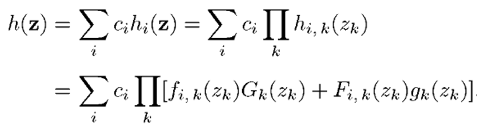
带噪语音Z已知,我们的目标是要根据带噪语音估计出干净语音X,即求出Z已知条件下的X的条件期望。基于MMSE估计,X的条件期望/估计表示如下:
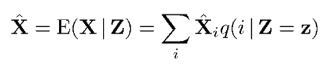
上式中X的条件期望又转换成了每个音素条件期望的加权和。条件概率q(i | Z = z)可根据全概率公式得到,如下:
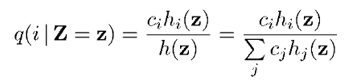
对于每个音素的条件期望,表示如下: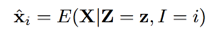 。对于每个音素的对数谱的每一维的条件期望,表示如下:
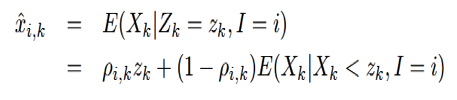
其中:

定义  ,可以推得x的对数谱的每一维上的估计如下式:

可以把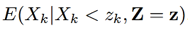 用基于谱减的
 替代,其中β表示消噪程度。ρk可以看成是干净语音的概率。所以
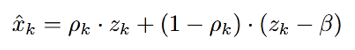
抵消掉正负项,可得:
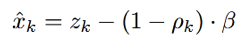
上式就是求消噪后的语音的对数谱的每维向量的数学表达式。zk可根据带噪语音求得,β要tuning,知道ρk后xk的估计就可得到了。对得到的每维向量做反变换,可得到消噪后的时域的值。
上文已给出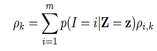 ,其中p(I = i | Z = z)表示在Z已知下是每个音素可能的概率,或者说一帧带噪语音是每个音素的可能的概率,用pi表示。pi可以通过全概率公式求出,即
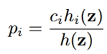 。但对每种语言来说,总的音素的个数是已知的(比如英语中有39个音素),这样求每帧是某个音素的概率是一个典型的分类问题。神经网络(NN)处理分类问题是优于传统方法的,所以可以用NN来训练一个模型,处理时用这个模型来计算每帧属于各个音素的概率,即算出pi,再和ρi,k做乘累加(ρi,k用基于MOG模型的方法求出),就可得到ρk了(
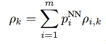 )。有了ρk,xk的估计就可求出了。可以看出NN模型的作用是替换计算pi的传统方法,使计算pi更准确。
干净语音的高斯模型并不是用常规的EM算法训练得到的,而是基于一个已做好音素标注的语料库得到的,论文作者用的是TIMIT库。每帧跟一个音素一一对应,把属于一个音素的所有帧归为一类,算对数谱的各个向量的值,最后求均值和方差,得到这个向量的密度函数表达式,均值和方差的计算如下式:
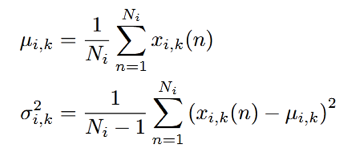
其中Ni表示属于某一音素的帧的个数。一个音素的所有向量的密度表达式相乘,就得到了这个音素的密度函数表达式。再通过属于这个音素的帧数占所有帧数的比例得到权重
(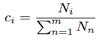 ), 这样干净语音的高斯模型就建立好了。
对于非稳态噪声来说,噪声参数(μY,k和δY,k)最好能自适应。噪声参数的初始值可以通过每句话的前250毫秒求得(基于前250毫秒都是噪声的假设),求法同上面的干净语音的高斯模型,数学表达式如下:

噪声参数的更新基于以下算式:

其中α为平滑系数,0 < α < 1,也需要tuning。噪声参数(μY,k和δY,k)更新了,Gk(y)和gk(yk)就更新了,hi,k(z)也就更新了,从而ρi,k也更新了。
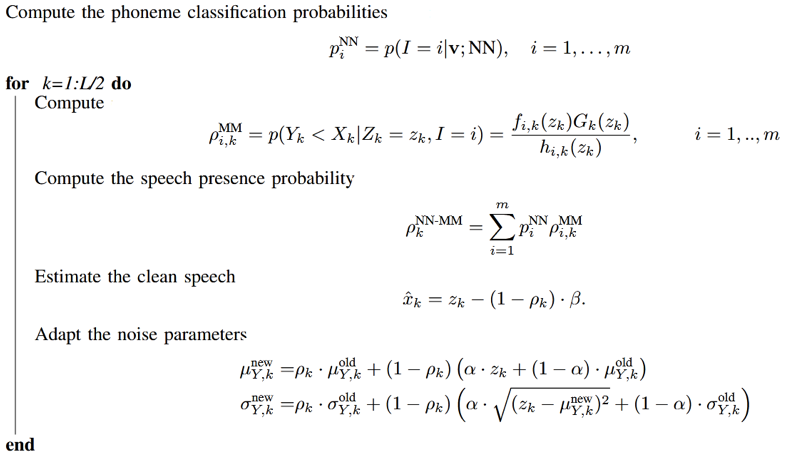
综上, 基于生成-判别混合模型的降噪算法如下:
1) 训练阶段
输入:
根据已标注好音素的语料库,得到对数谱向量z1,…zn(用于算MOG),MFCC向量v1,…,vn(用于NN训练)和每帧相对应的音素标签i1,…,in。
MoG 模型训练:
根据对数谱向量z1,…,zn算干净语音的MOG
NN模型训练:
根据(v1,i1),…(vn,…,in)训练一个基于音素的多分类模型
2) 推理阶段
输入:
带噪语音的对数谱向量以及MFCC向量
输出:
消噪后的语音
计算步骤:
语音降噪论文“A Hybrid Approach for Speech Enhancement Using MoG Model and Neural Network Phoneme Classifier”的研读的更多相关文章
- 论文阅读(Xiang Bai——【PAMI2017】An End-to-End Trainable Neural Network for Image-based Sequence Recognition and Its Application to Scene Text Recognition)
白翔的CRNN论文阅读 1. 论文题目 Xiang Bai--[PAMI2017]An End-to-End Trainable Neural Network for Image-based Seq ...
- 论文笔记:(2019)GAPNet: Graph Attention based Point Neural Network for Exploiting Local Feature of Point Cloud
目录 摘要 一.引言 二.相关工作 基于体素网格的特征学习 直接从非结构化点云中学习特征 从多视图模型中学习特征 几何深度学习的学习特征 三.GAPNet架构 3.1 GAPLayer 局部结构表示 ...
- Speech Enhancement via Deep Spectrum Image Translation Network
文中提出了一种深度网络来解决单通道语音增强问题. 链接:https://arxiv.org/abs/1911.01902 简介 因为背景噪声和混响的存在,录音通常会被扭曲,会对后端的语音识别等技术产生 ...
- VoIP语音处理流程和知识点梳理
做音频软件开发10+年,包括语音通信.语音识别.音乐播放等,大部分时间在做语音通信.做语音通信中又大部分时间在做VoIP语音处理.语音通信是全双工的,既要把自己的语音发送出去让对方听到,又要接收对方的 ...
- 论文翻译:2020_A Recursive Network with Dynamic Attention for Monaural Speech Enhancement
论文地址:基于动态注意的递归网络单耳语音增强 论文代码:https://github.com/Andong-Li-speech/DARCN 引用格式:Li, A., Zheng, C., Fan, C ...
- 论文翻译:2022_PACDNN: A phase-aware composite deep neural network for speech enhancement
论文地址:PACDNN:一种用于语音增强的相位感知复合深度神经网络 引用格式:Hasannezhad M,Yu H,Zhu W P,et al. PACDNN: A phase-aware compo ...
- 论文翻译:Fullsubnet: A Full-Band And Sub-Band Fusion Model For Real-Time Single-Channel Speech Enhancement
论文作者:Xiang Hao, Xiangdong Su, Radu Horaud, and Xiaofei Li 翻译作者:凌逆战 论文地址:Fullsubnet:实时单通道语音增强的全频带和子频带 ...
- 论文翻译:2020_WaveCRN: An efficient convolutional recurrent neural network for end-to-end speech enhancement
论文地址:用于端到端语音增强的卷积递归神经网络 论文代码:https://github.com/aleXiehta/WaveCRN 引用格式:Hsieh T A, Wang H M, Lu X, et ...
- 论文翻译:2019_Deep Neural Network Based Regression Approach for A coustic Echo Cancellation
论文地址:https://dl.acm.org/doi/abs/10.1145/3330393.3330399 基于深度神经网络的回声消除回归方法 摘要 声学回声消除器(AEC)的目的是消除近端传声器 ...
随机推荐
- 2018年11月16日SQL Server实验内容(触发器实验)
--注意:先把studentmanager数据库中的所有表用select into命令复制一份, --然后用复制后新表完成下面的实验,同时,对每个触发器都要进行验证. select *into dep ...
- P1308_统计单词数(JAVA语言)
题目描述 一般的文本编辑器都有查找单词的功能,该功能可以快速定位特定单词在文章中的位置,有的还能统计出特定单词在文章中出现的次数. 现在,请你编程实现这一功能,具体要求是:给定一个单词,请你输出它在给 ...
- 8、Spring教程之静态代理/动态代理
为什么要学习代理模式,因为AOP的底层机制就是动态代理! 代理模式: 静态代理 动态代理 学习aop之前 , 我们要先了解一下代理模式! 静态代理 静态代理角色分析 抽象角色 : 一般使用接口或者抽象 ...
- python基础之流程控制(1)
一.分支结构:if 判断 1.什么要有if 判断语句? 让计算机可以像人一样根据条件进行判断,并根据判断结果执行相应的流程. 2.基本结构 单分支结构 # 单分支 if 条件1: 代码1 代码2 代码 ...
- NetCore的缓存使用详例
关于我 作者博客|文章首发 缓存基础知识 缓存可以减少生成内容所需的工作,从而显著提高应用程序的性能和可伸缩性. 缓存最适用于不经常更改的 数据,生成 成本很高. 通过缓存,可以比从数据源返回的数据的 ...
- 前端 | vxe-table 翻页保留复选框状态
0 前言 在前端开发过程中时常会遇到表格相关的显示与处理.组件库通常都会提供表格组件,对于展示.简单操作这些常用功能通常也够用:但如果需要更多的定制或进行比较复杂的操作,组件库自带的组件可能会捉襟见肘 ...
- redhat 7.6 部署禅道 yum [Errno 14] curl#37 - "Couldn't open file /mnt/repodata/repomd.
记个流水账 redhat 7.6 上部署 禅道. 禅道官网下载 http://dl.cnezsoft.com/zentao/9.8.3/ZenTaoPMS.9.8.3.zbox_64.tar.gz ...
- 曾侯乙编钟引发的遐想之Java设计模式:状态模式
目录 示例 简单例子 改进代码 状态模式 定义 意图 主要解决问题 何时使用 优缺点 曾侯乙编钟 状态模式-命令模式-策略模式 示例 一个类对外提供了多个行为,同时该类对象有多种状态,不同状态下对外的 ...
- 如何使用natapp来实现内网穿透及案例
1. 业务场景 当我们的项目是部署在本地的时候,如何让其他用户(不在同一个局域网之下)来进行调用呢?这时我们就可以使用内网穿透将自己的IP通过映射成相应的地址,然后再通过映射后的地址来进行访问本地的项 ...
- postgresql高级应用之行转列&汇总求和
postgresql高级应用之行转列&汇总求和 轉載請注名出處 https://www.cnblogs.com/funnyzpc/p/14732165.html 前言 节前公司业务方需要做一個 ...