
mysql使用自增Id为什么存储比较快
转自:https://blog.csdn.net/bigtree_3721/article/details/73151028
InnoDB引擎表的特点
1、InnoDB引擎表是基于B+树的索引组织表(IOT)
关于B+树
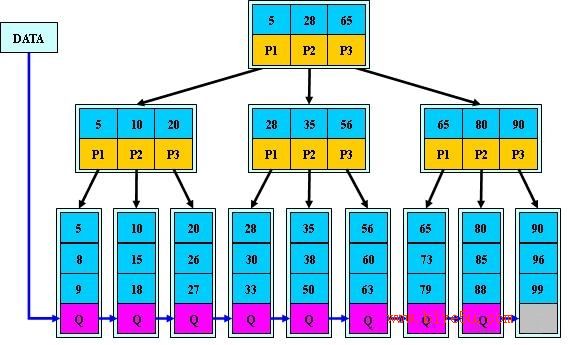
(图片来源于网上)
B+ 树的特点:
(1)所有关键字都出现在叶子结点的链表中(稠密索引),且链表中的关键字恰好是有序的;
(2)不可能在非叶子结点命中;
(3)非叶子结点相当于是叶子结点的索引(稀疏索引),叶子结点相当于是存储(关键字)数据的数据层;
2、如果我们定义了主键(PRIMARY KEY),那么InnoDB会选择主键作为聚集索引、如果没有显式定义主键,则InnoDB会选择第一个不包含有NULL值的唯一索引作为主键索引、如果也没有这样的唯一索引,则InnoDB会选择内置6字节长的ROWID作为隐含的聚集索引(ROWID随着行记录的写入而主键递增,这个ROWID不像ORACLE的ROWID那样可引用,是隐含的)。
3、数据记录本身被存于主索引(一颗B+Tree)的叶子节点上。这就要求同一个叶子节点内(大小为一个内存页或磁盘页)的各条数据记录按主键顺序存放,因此每当有一条新的记录插入时,MySQL会根据其主键将其插入适当的节点和位置,如果页面达到装载因子(InnoDB默认为15/16),则开辟一个新的页(节点)
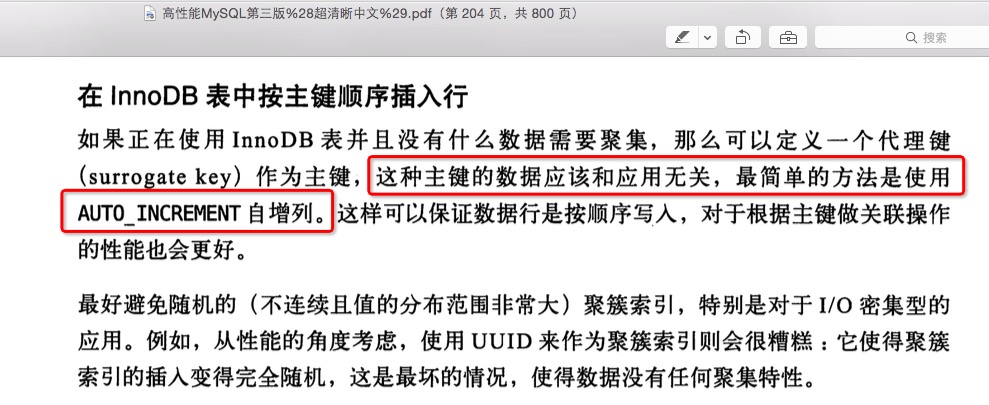
4、如果表使用自增主键,那么每次插入新的记录,记录就会顺序添加到当前索引节点的后续位置,当一页写满,就会自动开辟一个新的页
5、如果使用非自增主键(如果身份证号或学号等),由于每次插入主键的值近似于随机,因此每次新纪录都要被插到现有索引页得中间某个位置,此时MySQL不得不为了将新记录插到合适位置而移动数据,甚至目标页面可能已经被回写到磁盘上而从缓存中清掉,此时又要从磁盘上读回来,这增加了很多开销,同时频繁的移动、分页操作造成了大量的碎片,得到了不够紧凑的索引结构,后续不得不通过OPTIMIZE TABLE来重建表并优化填充页面。
综上总结,如果InnoDB表的数据写入顺序能和B+树索引的叶子节点顺序一致的话,这时候存取效率是最高的,也就是下面这几种情况的存取效率最高:
1、使用自增列(INT/BIGINT类型)做主键,这时候写入顺序是自增的,和B+数叶子节点分裂顺序一致;
2、该表不指定自增列做主键,同时也没有可以被选为主键的唯一索引(上面的条件),这时候InnoDB会选择内置的ROWID作为主键,写入顺序和ROWID增长顺序一致;
除此以外,如果一个InnoDB表又没有显示主键,又有可以被选择为主键的唯一索引,但该唯一索引可能不是递增关系时(例如字符串、UUID、多字段联合唯一索引的情况),该表的存取效率就会比较差。
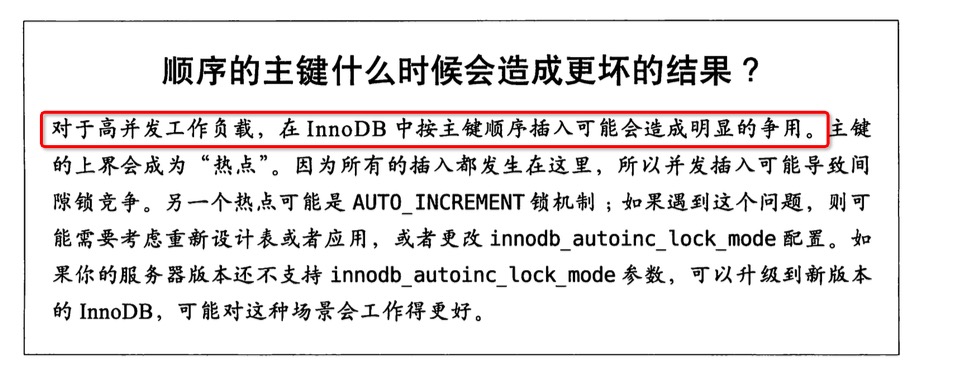
《高性能MySQL》中的原话
欢迎关注
mysql使用自增Id为什么存储比较快的更多相关文章
- mysql 数据库自增id 的总结
有一个表StuInfo,里面只有两列 StuID,StuName其中StuID是int型,主键,自增列.现在我要插入数据,让他自动的向上增长,insert into StuInfo(StuID,Stu ...
- MySQL 使用自增ID主键和UUID 作为主键的优劣比较详细过程(从百万到千万表记录测试)
测试缘由 一个开发同事做了一个框架,里面主键是uuid,我跟他建议说mysql不要用uuid用自增主键,自增主键效率高,他说不一定高,我说innodb的索引特性导致了自增id做主键是效率最好的,为了拿 ...
- MYSQL获取自增ID的四种方法
MYSQL获取自增ID的四种方法 1. select max(id) from tablename 2.SELECT LAST_INSERT_ID() 函数 LAST_INSERT_ID 是与tabl ...
- mysql数据库自增id重新从1排序的两种方法
mysql默认自增ID是从1开始了,但当我们如果有插入表或使用delete删除id之后ID就会不会从1开始了哦. 使用mysql时,通常表中会有一个自增的id字段,但当我们想将表中的数据清空重新添 ...
- DBS-MySQL:MYSQL获取自增ID的四种方法
ylbtech-DBS-MySQL:MYSQL获取自增ID的四种方法 1.返回顶部 1. 1. select max(id) from tablename 2.SELECT LAST_INSERT_I ...
- mysql数据库表自增ID批量清零 AUTO_INCREMENT = 0
mysql数据库表自增ID批量清零 AUTO_INCREMENT = 0 #将数据库表自增ID批量清零 SELECT CONCAT( 'ALTER TABLE ', TABLE_NAME, ' AUT ...
- mysql 返回自增id
String dateNow= DateTime.Now.ToString("yyyyMMddhhmmss"+ new Random().Next(1, 99)); //随机数 ...
- MySQL 使用自增ID主键和UUID 作为主键的优劣比較具体过程(从百万到千万表记录測试)
主键类型 SQL语句 运行时间 (秒) (1)模糊范围查询1000条数据,自增ID性能要好于UUID 自增ID SELECT SQL_NO_CACHE t.* FROM test.`UC_US ...
- MySQL中自增ID起始值修改方法
在实际测试工作过程中,有时因为生产环境已有历史数据原因,需要测试环境数据id从某个值开始递增,此时,我们需要修改数据库中自增ID起始值,下面以MySQL为例: 表名:users; 建表时添加: ); ...
随机推荐
- Yolov3实战 基于darknet window版
特此声明:训练过程预先认为你对yolov3神经网络有一定了解的基础上进行. 目录 一.先备齐下面的工具(预先善其事,必先利其器) 二.接下里使用我们的工具编译我们的环境 三. 训练自己的数据集 1. ...
- BZOJ.5461.[PKUWC2018]Minimax(DP 线段树合并)
BZOJ LOJ 令\(f[i][j]\)表示以\(i\)为根的子树,权值\(j\)作为根节点的概率. 设\(i\)的两棵子树分别为\(x,y\),记\(p_a\)表示\(f[x][a]\),\(p_ ...
- 基于CC2530/CC2430 的光强采集系统--ADC实验
使用光敏电阻,程序通用所有模拟量传感器 参见论坛中实例视频讲解http://bphero.com.cn/forum.php?mod=viewthread&tid=15&extra=pa ...
- 将分支推送到远程存储库时遇到错误: rejected Updates were rejected because the remote contains work that you do not have locally
在仓库目录下执行 git pull origin master --allow-unrelated-histories 之后就可以成功的pull,push了
- Yii2 查询构建器 QueryBuilder
查询构造器 QueryBuilder 1.什么是查询构建器 查询构建器也是建立在 DAO 基础之上,可让你创建程序化的.DBMS 无关的 sql 语句,并且这样创建的 sql 语句比原生的 sql 语 ...
- UIAlertController简单使用
UIAlertView 在iOS2 的时候开始使用,在iOS9 的时候被摒弃 NS_CLASS_DEPRECATED_IOS(2_0, 9_0, "UIAlertView is depr ...
- .NET项目引用黄色小三角以及找不到依赖的解决方法
上图,问题描述: 经过查证,这个是引用的项目框架版本和本项目框架版本不一致的症状. 解决办法: 点击项目右键属性,调整版本使两个项目的版本一致 问题解决.good! ----------------- ...
- 优先队列重载<运算符
https://vjudge.net/problem/POJ-3190 #include<iostream> #include<cstdio> #include<queu ...
- 如何给webbrowser指定IE版本
void Button1Click(object sender, EventArgs e) { RegistryKey rk = Registry.LocalMachine; ...
- jitwatch查看JIT后的汇编码
1.下载Apache Maven 3.5.3 http://maven.apache.org/download.cgi apache-maven-3.5.3-bin.zip 解压为C:\maven3 ...