
Lucene创建索引流程

1.创建索引流程
原始文档:互联网上的网页(爬虫或蜘蛛)、数据库中的数据、磁盘上的文件
创建文档对象(非结构化数据)
文档对象中的属性不叫属性现在成为域。
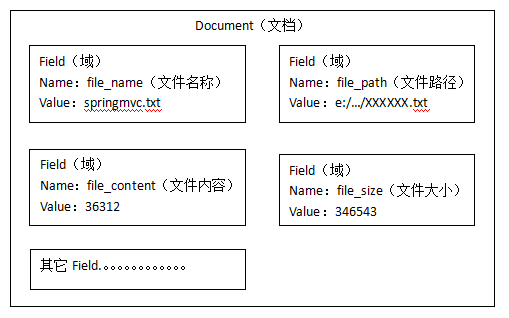
每个 Document 可以有多个 Field ,不同的 Document 可以有不同的 Field,同一个 Document 可以有相同的 Field(域名和域值都相同)。
每个文档都有一个唯一的编号,就是文档id
分析文档
将原始内容包含域的文档,需要再对域中的内容进行分析,分析的过程是经过对原始文档提取单词、将字母转为小写、去除标点符号、去除停用词等过程生成最终的词汇单元,可以将词汇单元理解为一个个单词。
原文档内容:
Luncene is a Java full-text search engine.
分析后得到的语汇单元:
lucene、java、full、search、engine…
每个单词叫做一个 Term,不同的域中拆分出来相同的单词是不同的 Term。Term中包含两部分一部分是文档的域名,另一部分是单词的内容。 Term K 域(文件名称) V spring Term K 域(文件内容) V spring 刚才两个Tream不是一个
创建索引
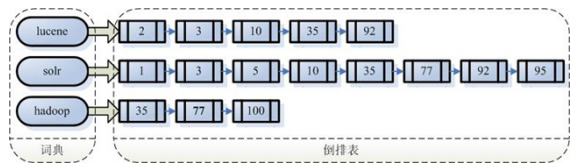
对所有文档分析得出的语汇单元进行创建索引,创建索引的目地是为了搜索,最终要实现只搜索被搜索的语汇单元从而找到 Document(文档)
注意:创建索引是对语汇索引,通过词语找文档,这种索引的结构叫倒排索引结构。包括索引和文档两部分,索引即词汇表,它的规模较小,而文档集合较大。
传统方式是根据文件找到该文件的内容,在文件内容中匹配搜索关键字,这种方法是顺序扫描法,数据量大、搜索慢
// 创建索引

    @Test

    public void testIndex() throws Exception {

        // 第一步创建一个indexwriter对象

        Directory directory = FSDirectory.open(new File("D:\\temp\\index"));

        // Directory directory2 = new RAMDirectory();//保存索引到内存中(内存索引库)

        //Analyzer analyzer = new StandardAnalyzer();// 官方推荐

         Analyzer analyzer = new IKAnalyzer();

        IndexWriterConfig config = new IndexWriterConfig(Version.LUCENE_4_10_3, analyzer);

        IndexWriter indexWriter = new IndexWriter(directory, config);

        // 第三步创建Filed域,将field添加到document对象中

        File f = new File("D:\\Lucent&solr\\searchsoure");

        File[] listFiles = f.listFiles();

        for (File file : listFiles) {

            // 第二步创建Document对象

            Document document = new Document();

            // 文件名称

            String file_name = file.getName();

            Field fileNameField = new TextField("fileName", file_name, Store.YES);

            // 文件大小

            long file_size = FileUtils.sizeOf(file);

            Field fileSizeField = new LongField("fileSize", file_size, Store.YES);

            // 文件路径

            String file_path = file.getPath();

            Field filePathField = new StoredField("filePath", file_path);

            // 文件内容

            String file_content = FileUtils.readFileToString(file);

            Field fileContentField = new TextField("fileContent", file_content, Store.NO);

            document.add(fileNameField);

            document.add(fileSizeField);

            document.add(filePathField);

            document.add(fileContentField);

            // 第四步:使用indexwriter对象将document对象写入索引库,此过程进行索引创建。并将索引和document对象写入索引库

            indexWriter.addDocument(document);

        }

        // 第五步:关闭IndexWriter对象

        indexWriter.close();

    }

    // 查询索引

    @Test

    public void testSearch() throws Exception {

        // 第一步:创建一个Directory对象,也就是索引库存放的位置。

        Directory directory = FSDirectory.open(new File("D:\\temp\\index"));// 磁盘硬盘库

        // 第二步:创建一个indexReader对象,需要指定Directory对象。

        IndexReader indexReader = DirectoryReader.open(directory);// 流

        // 第三步:创建一个indexsearcher对象,需要指定IndexReader对象

        IndexSearcher indexSearcher = new IndexSearcher(indexReader);

        // 第四步:创建一个TermQuery对象,指定查询的域和查询的关键词。

        Query query = new TermQuery(new Term("fileName", "java"));

        // 第五步:执行查询。

        TopDocs topDocs = indexSearcher.search(query, 2);

        // 第六步:返回查询结果。遍历查询结果并输出。

        ScoreDoc[] scoreDocs = topDocs.scoreDocs;// 文档id

        for (ScoreDoc scoreDoc : scoreDocs) {

            int doc = scoreDoc.doc;

            Document document = indexSearcher.doc(doc);

            // 文件名称

            String fileName = document.get("fileName");

            System.out.println(fileName);

            // 文件内容

            String fileContent = document.get("fileContent");

            System.out.println(fileContent);

            // 文件大小

            String fileSize = document.get("fileSize");

            System.out.println(fileSize);

            // 文件路径

            String filePath = document.get("filePath");

            System.out.println(filePath);

            System.out.println("-----------------");

        }

        // 第七步:关闭IndexReader对象

        indexReader.close();

    }
Lucene创建索引流程的更多相关文章
- lucene创建索引简单示例
利用空闲时间写了一个使用lucene创建索引简单示例, 1.使用maven创建的项目 2.需要用到的jar如下: 废话不多说,直接贴代码如下: 1.创建索引的类(HelloLucene): packa ...
- Lucene创建索引和索引的基本检索(Lucene 之 Hello World)
Author: 百知教育 gaozhy 注:演示代码所使用jar包版本为 lucene-xxx-5.2.0.jar 一.lucene索引操作 1.创建索引代码 try { // 1. 指定索引文件存 ...
- lucene创建索引
创建索引. 1.lucene下载. 下载地址:http://archive.apache.org/dist/lucene/java/. lucene不同版本之间有不小的差别,这里下载的是lucene ...
- lucene创建索引的几种方式(一)
什么是索引: 根据你输入的值去找,这个值就是索引 第一种创建索引的方式: 根据文件来生成索引,如后缀为.txt等的文件 步骤: 第一步:FSDirectory.open(Paths.get(url)) ...
- 搜索引擎学习(二)Lucene创建索引
PS:需要用到的jar包: 代码实现 1.工程结构 2.设置工程依赖的jar包 3.代码实现 /** * Lucene入门 * 创建索引 */ public class CreateIndex { / ...
- 第五步:Lucene创建索引
package cn.lucene; import java.io.IOException; import java.nio.file.Paths; import java.util.Date; im ...
- Apache Lucene(全文检索引擎)—创建索引
目录 返回目录:http://www.cnblogs.com/hanyinglong/p/5464604.html 本项目Demo已上传GitHub,欢迎大家fork下载学习:https://gith ...
- Lucene 4.7 --创建索引
Lucene的最新版本和以前的语法或者类名,类规定都相差甚远 0.准备工作: 1). Lucene官方API http://lucene.apache.org/core/4_7_0/index.htm ...
- Lucene.net 从创建索引到搜索的代码范例
关于Lucene.Net的介绍网上已经很多了在这里就不多介绍Lucene.Net主要分为建立索引,维护索引和搜索索引Field.Store的作用是通过全文检查就能返回对应的内容,而不必再通过id去DB ...
随机推荐
- Python网络编程-IO阻塞与非阻塞及多路复用
前言 问题:普通套接字实现的服务端的缺陷 一次只能服务一个客户端! accept阻塞! 在没有新的套接字来之前,不能处理已经建立连接的套接字的请求 re ...
- python多进程没有锁队列范例
假设有一些任务要完成.为了完成这项任务,将使用几个过程.所以,将保持两个队列.一个包含任务,另一个包含已完成任务的日志. 然后实例化流程来完成任务.请注意,python队列类已经同步. 这意味着,我们 ...
- Xamarin.Android 获取手机IP地址
命名空间: using System.Net; 代码: IPAddress[] address = Dns.GetHostAddresses(Dns.GetHostName()); ] != null ...
- Linux内核源码分析之调度、内核线程模型 And Centos7.2's Kernel Resource Analysis
本文分为概述.历史.el7.2代码架构图解三部分. 解决的问题: a.Kernel调度发展过程: b.以架构图的方式,详解el7.2具体调度实现.内核线程模型.调度时间片计算,以及探究整个Kernel ...
- 从零开始学 Web 之 CSS3(五)transform
大家好,这里是「 从零开始学 Web 系列教程 」,并在下列地址同步更新...... github:https://github.com/Daotin/Web 微信公众号:Web前端之巅 博客园:ht ...
- Centos7安装Mysql8(官方整合包)
1. 下载整合包 [root@master ~]# wget https://dev.mysql.com/get/Downloads/MySQL-8.0/mysql-8.0.12-1.el7.x86_ ...
- Spring Framework简介
作者关于此主题早期文章 Spring框架快速入门 起源 要谈Spring的历史,就要先谈J2EE.J2EE应用程序的广泛实现是在1999年和2000年开始的,它的出现带来了诸如事务管理之类的核心中间层 ...
- 西门子PLC SCL语言开发学习笔记(二)
今天来讲下scl两个关键的点 一.按键事件 比如地址I0.0是某个按钮的状态,他只有True和False两个状态,所以我们要获得按下事件需要我们自己模拟. #KeyPress := "Btn ...
- 单机多实例mysq 8.0l部署安装
单机多实例mysql部署安装 目的需求 在单台虚拟机部署部署多实例mysql,用于配置mysql replication,MHA等. 思路 多实例安装mysql可以参考<源编译MySQL8.0的 ...
- soapui 自动化教程
本教程主要讲述对接口的自动化测试,略过压力测试.安全测试. 最终目标是通过groovy脚本执行一个文件,发送多个任务请求.验证返回值是否符合期望. 教程从soapui入门到groovy实现回传参数.生 ...