
ELK 经典用法—企业自定义日志手机切割和mysql模块
本文收录在Linux运维企业架构实战系列
一、收集切割公司自定义的日志
很多公司的日志并不是和服务默认的日志格式一致,因此,就需要我们来进行切割了。
1、需切割的日志示例
2018-02-24 11:19:23,532 [143] DEBUG performanceTrace 1145 http://api.114995.com:8082/api/Carpool/QueryMatchRoutes 183.205.134.240 null 972533 310000 TITTL00 HUAWEI 860485038452951 3.1.146 HUAWEI 5.1 113.552344 33.332737 发送响应完成 Exception:(null)
2、切割的配置
在logstash 上,使用fifter 的grok 插件进行切割
input {

        beats {

                port => ""

        }

}

filter {

    grok {

        match => {

            "message" => "%{TIMESTAMP_ISO8601:timestamp} \[%{NUMBER:thread:int}\] %{DATA:level} (?<logger>[a-zA-Z]+) %{NUMBER:executeTime:int} %{URI:url} %{IP:clientip} %{USERNAME:UserName} %{NUMBER:userid:int} %{NUMBER:AreaCode:int} (?<Board>[0-9a-zA-Z]+[-]?[0-9a-zA-Z]+) (?<Brand>[0-9a-zA-Z]+[-]?[0-9a-zA-Z]+) %{NUMBER:DeviceId:int} (?<TerminalSourceVersion>[0-9a-z\.]+) %{NUMBER:Sdk:float} %{NUMBER:Lng:float} %{NUMBER:Lat:float} (?<Exception>.*)"

        }

        remove_field => "message"

    }

    date {

                   match => ["timestamp","dd/MMM/YYYY:H:m:s Z"]

        remove_field => "timestamp"

           }

    geoip {

        source => "clientip"

        target => "geoip"

        database => "/etc/logstash/maxmind/GeoLite2-City.mmdb"

    }

}

output {

    elasticsearch {

        hosts => ["http://192.168.10.101:9200/"]

        index => "logstash-%{+YYYY.MM.dd}"

        document_type => "apache_logs"

    }

}
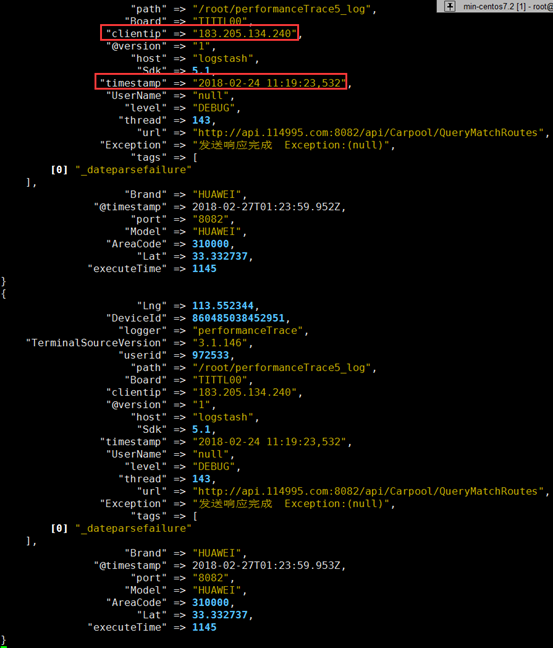
3、切割解析后效果
4、最终kibana 展示效果
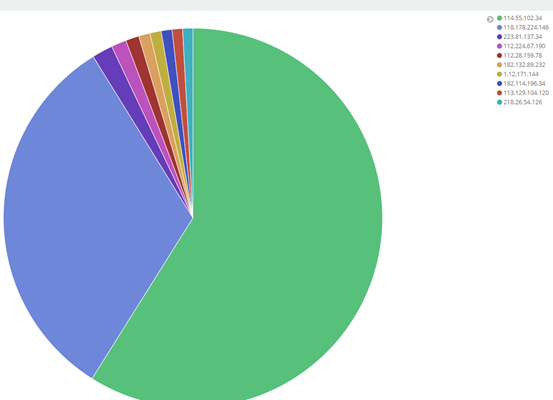
① top10 clientip
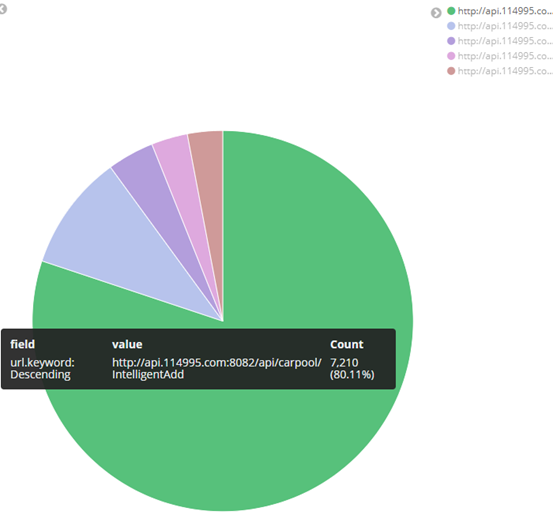
② top5 url
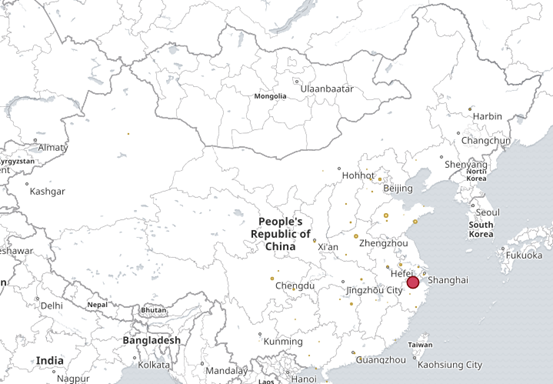
③ 根据ip 显示地理位置
⑤ top10 executeTime
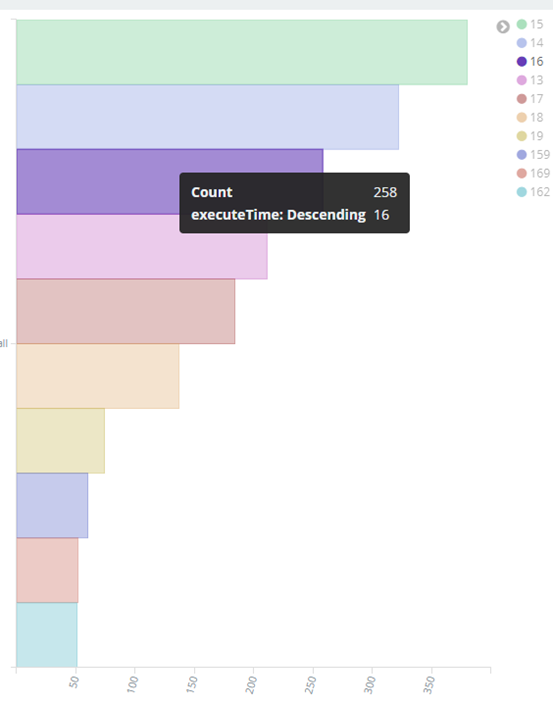
⑥ 其他字段都可进行设置,多种图案,也可将多个图形放在一起展示
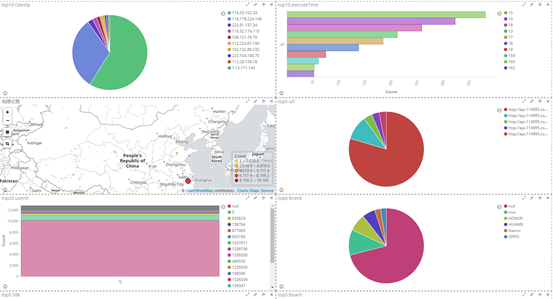
二、grok 用法详解
1、简介
Grok是迄今为止使蹩脚的、无结构的日志结构化和可查询的最好方式。Grok在解析 syslog logs、apache and other webserver logs、mysql logs等任意格式的文件上表现完美。
Grok内置了120多种的正则表达式库,地址:https://github.com/logstash-plugins/logstash-patterns-core/tree/master/patterns。
2、入门例子
① 示例
55.3.244.1 GET /index.html 15824 0.043
② 分析
这条日志可切分为5个部分,IP(55.3.244.1)、方法(GET)、请求文件路径(/index.html)、字节数(15824)、访问时长(0.043),对这条日志的解析模式(正则表达式匹配)如下:
%{IP:client} %{WORD:method} %{URIPATHPARAM:request} %{NUMBER:bytes} %{NUMBER:duration}
③ 写到filter中
filter { grok { match => { "message" => "%{IP:client} %{WORD:method} %{URIPATHPARAM:request} %{NUMBER:bytes} %{NUMBER:duration}"} } }
④ 解析后效果
client: 55.3.244.1

method: GET

request: /index.html

bytes:

duration: 0.043
3、解析任意格式日志
(1)解析任意格式日志的步骤:
① 先确定日志的切分原则,也就是一条日志切分成几个部分。
② 对每一块进行分析,如果Grok中正则满足需求,直接拿来用。如果Grok中没用现成的,采用自定义模式。
③ 学会在Grok Debugger中调试。
(2)grok 的分类
- 满足自带的grok 正则 grok_pattern
① 可以查询
# less /usr/share/logstash/vendor/bundle/jruby/1.9/gems/logstash-patterns-core-4.1.1/patterns/grok-patterns
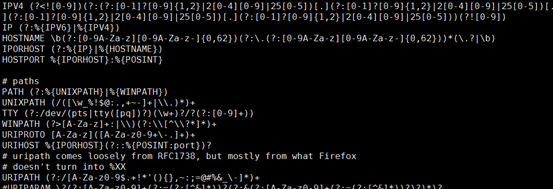
② 使用格式
grok_pattern 由零个或多个 %{SYNTAX:SEMANTIC}组成
例: %{IP:clientip}
其中SYNTAX 是表达式的名字,是由grok提供的:例如数字表达式的名字是NUMBER,IP地址表达式的名字是IP
SEMANTIC 表示解析出来的这个字符的名字,由自己定义,例如IP字段的名字可以是 client
- 自定义SYNTAX
使用格式:(?<field_name>the pattern here)
例:(?<Board>[0-9a-zA-Z]+[-]?[0-9a-zA-Z]+)
(3)正则解析容易出错,强烈建议使用Grok Debugger调试,姿势如下(我打开这个网页不能用)
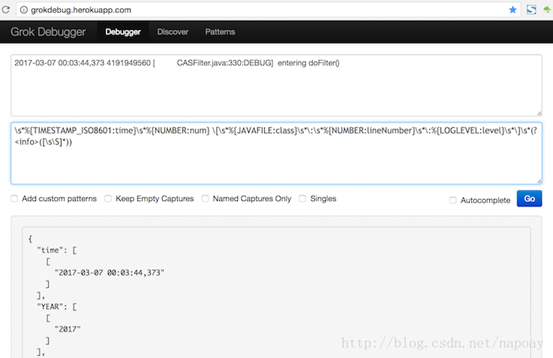
三、使用mysql 模块,收集mysql 日志
1、官方文档使用介绍
https://www.elastic.co/guide/en/beats/filebeat/current/filebeat-module-mysql.html
2、配置filebeat ,使用mysql 模块收集mysql 的慢查询
# vim filebeat.yml
#=========================== Filebeat prospectors =============================

filebeat.modules:

- module: mysql

  error:

    enabled: true

    var.paths: ["/var/log/mariadb/mariadb.log"]

  slowlog:

    enabled: true

    var.paths: ["/var/log/mariadb/mysql-slow.log"]

#----------------------------- Redis output --------------------------------

output.redis:

  hosts: ["192.168.10.102"]

  password: "ilinux.io"

  key: "httpdlogs"

  datatype: "list"

  db: 0

  timeout: 5
3、elk—logstash 切割mysql 的慢查询日志
① 切割配置
# vim mysqllogs.conf
input {

        redis {

                host => "192.168.10.102"

                port => ""

                password => "ilinux.io"

                data_type => "list"

                key => "httpdlogs"

                threads => 2

        }

}
filter {
if [fields][type] == "pachongmysql" {
grok {
match => {
"message" => "^#\ Time:\ (?<Time>.*)"
}
match => {
"message" => "^#\ User\@Host:\ (?<User>.*)\[exiuapp\]\ \@\ \ \[%{IP:hostip}\]\ \ Id:\ \ \ \ %{NUMBER:Id:int}"
}
match => {
"message" => "^#\ Query_time:\ %{NUMBER:Query_time:float}\ \ Lock_time:\ %{NUMBER:Lock_time:float}\ Rows_sent:\ %{NUMBER:Rows_sent:int}\ \ Rows_examined:\ %{NUMBER:Rows_examined:int}"
}
match => {
"message" => "^use\ (?<database>.*)"
}
match => {
"message" => "^SET\ timestamp=%{NUMBER:timestamp:int}\;"
}
match => {
"message" => "(?<sql>.*);"
}
remove_field => "message"
}
}
}
output {
        elasticsearch {

                hosts => ["http://192.168.10.101:9200/"]

                index => "logstash-%{+YYYY.MM.dd}"

                document_type => "mysql_logs"

        }

}
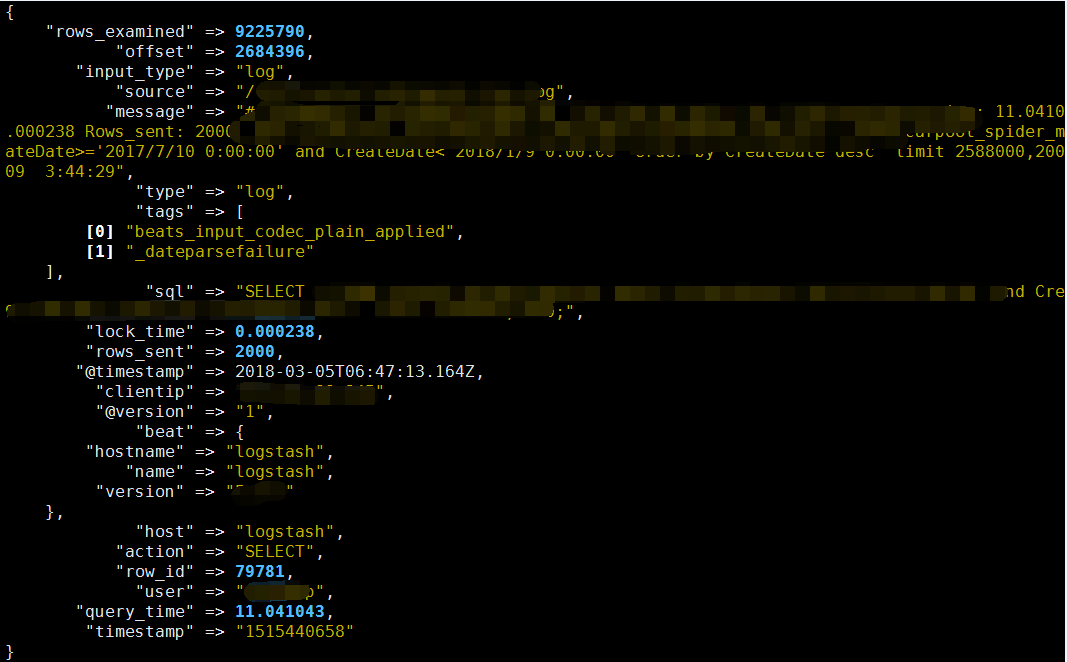
② 切割后显示结果
4、kibana 最终显示效果
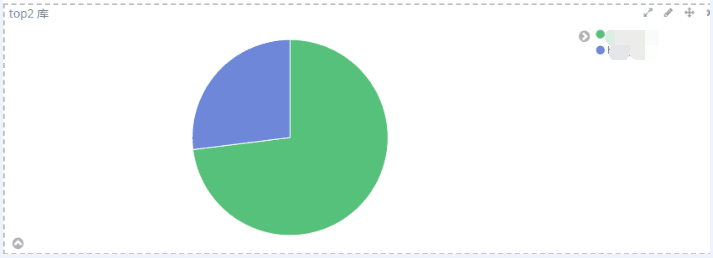
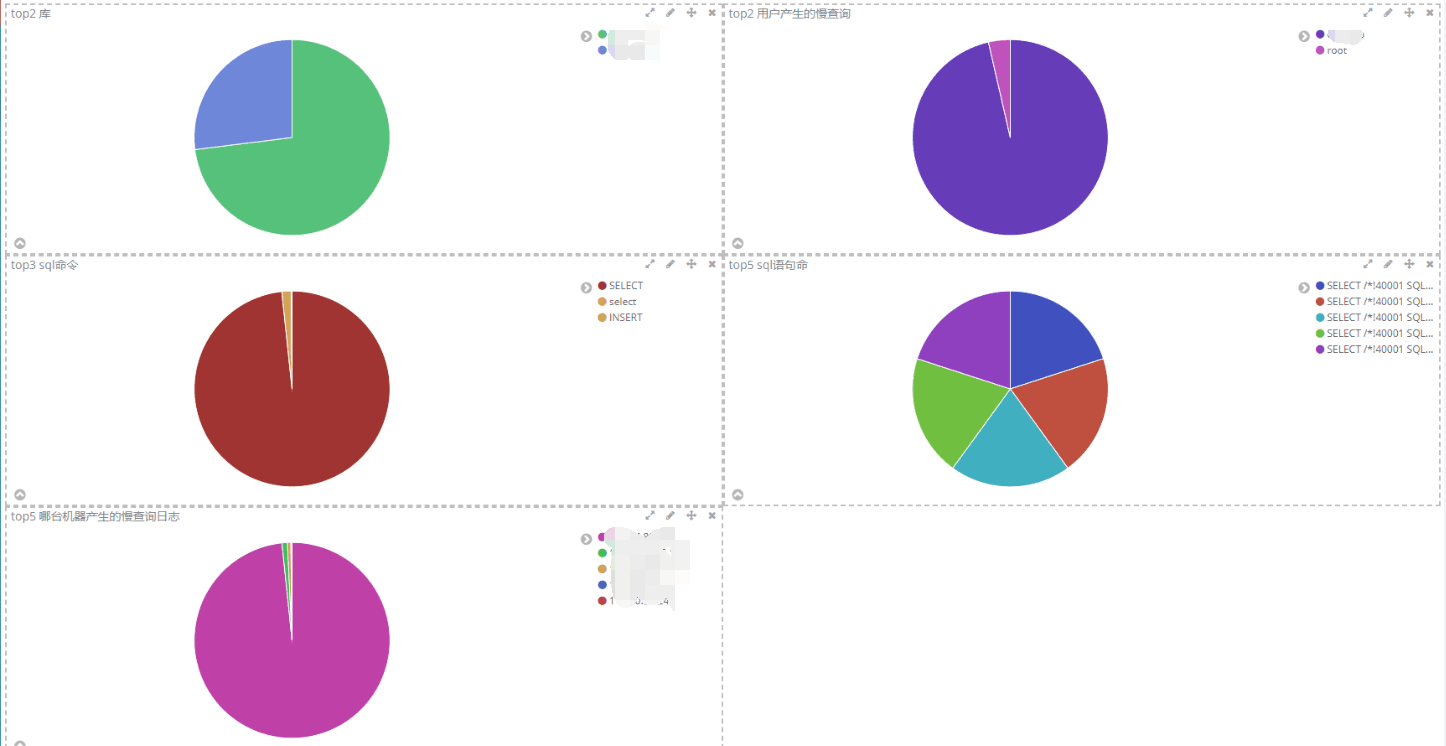
① 哪几个的数据库最多,例:top2 库
表无法显示,因为有些语句不涉及表,切割不出来
② 哪几个sql语句出现的最多,例:top5 sql语句
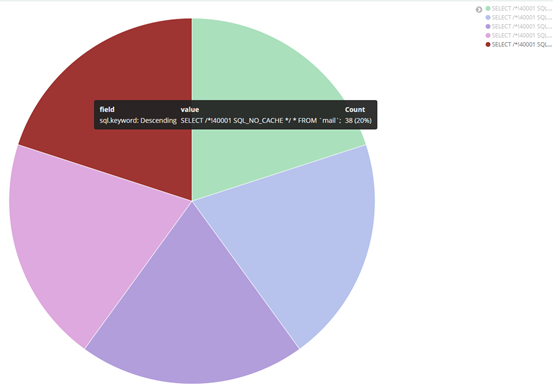
③ 哪几个sql语句出现的最多,例:top5 sql语句
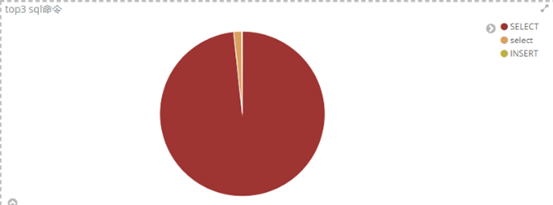
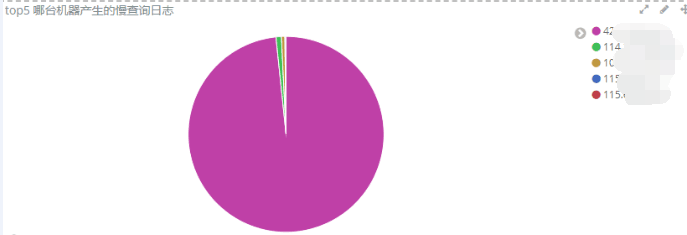
④ 哪几台服务器慢查询日志生成的最多,例:top5 服务器
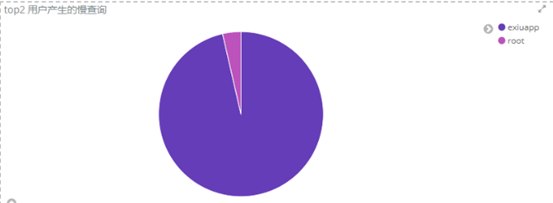
⑤ 哪几个用户慢查询日志生成的最多,例:top2 用户
可以合并显示
5、使用mysql 模块收集mysql 的慢查询
(1)filebeat 配置和上边一样
(2)elk—logstash 切割mysql 的错误日志
# vim mysqllogs.conf
filter {

        grok {

                match => { "message" => "(?<timestamp>\d{4}-\d{2}-\d{2}\s+\d{2}:\d{2}:\d{2}) %{NUMBER:pid:int} \[%{DATA:level}\] (?<content>.*)" }

        }

        date {

                match => ["timestamp","dd/MMM/YYYY:H:m:s Z"]

                remove_field => "timestamp"

        }

}
(3)就不在展示结果了
四、ELK 收集多实例日志
很多情况下,公司资金不足,不会一对一收集日志;因此,一台logstash 使用多实例收集处理多台agent 的日志很有必要。
1、filebeat 的配置
主要是output 的配置,只需不同agent 指向不同的端口即可
① agent 1 配置指向5044 端口
#----------------------------- Logstash output --------------------------------

output.logstash:

  # The Logstash hosts

  hosts: ["192.168.10.107:5044"]
② agent 2 配置指向5045 端口
#----------------------------- Logstash output --------------------------------

output.logstash:

  # The Logstash hosts

  hosts: ["192.168.10.107:5045"]
2、logstash 的配置
针对不同的agent ,input 指定对应的端口
① agent 1
input {

        beats {

                port => ""

        }

}

output {   #可以在output 加以区分

        elasticsearch {

                hosts => ["http://192.168.10.107:9200/"]

                index => "logstash-apache1-%{+YYYY.MM.dd}"

                document_type => "apache1_logs"

        }

}
② agent 1
input {

        beats {

                port => ""

        }

}

output {   #可以在output 加以区分

        elasticsearch {

                hosts => ["http://192.168.10.107:9200/"]

                index => "logstash-apache2-%{+YYYY.MM.dd}"

                document_type => "apache2_logs"

        }

}
开启对应的服务就ok 了。
ELK 经典用法—企业自定义日志手机切割和mysql模块的更多相关文章
- ELK 经典用法—企业自定义日志收集切割和mysql模块
本文收录在Linux运维企业架构实战系列 一.收集切割公司自定义的日志 很多公司的日志并不是和服务默认的日志格式一致,因此,就需要我们来进行切割了. 1.需切割的日志示例 2018-02-24 11: ...
- 14.2-ELK 经典用法—企业自定义日志收集切割和mysql模块
本文收录在Linux运维企业架构实战系列 一.收集切割公司自定义的日志 很多公司的日志并不是和服务默认的日志格式一致,因此,就需要我们来进行切割了. 1.需切割的日志示例 2018-02-24 11: ...
- 项目实战14—ELK 企业内部日志分析系统
一.els.elk 的介绍 1.els,elk els:ElasticSearch,Logstash,Kibana,Beats elk:ElasticSearch,Logstash,Kibana ① ...
- 项目实战14.1—ELK 企业内部日志分析系统
本文收录在Linux运维企业架构实战系列 一.els.elk 的介绍 1.els,elk els:ElasticSearch,Logstash,Kibana,Beats elk:ElasticSear ...
- ELK收集Nginx自定义日志格式输出
1.ELK收集日志的有两种常用的方式: 1.1:不修改源日志格式,简单的说就是在logstash中转通过 grok方式进行过滤处理,将原始无规则的日志转换为规则日志(Logstash自定义日志格式) ...
- 《Spring 5官方文档》 Spring AOP的经典用法
原文链接 在本附录中,我们会讨论一些初级的Spring AOP接口,以及在Spring 1.2应用中所使用的AOP支持. 对于新的应用,我们推荐使用 Spring AOP 2.0来支持,在AOP章节有 ...
- ELK 6安装配置 nginx日志收集 kabana汉化
#ELK 6安装配置 nginx日志收集 kabana汉化 #环境 centos 7.4 ,ELK 6 ,单节点 #服务端 Logstash 收集,过滤 Elasticsearch 存储,索引日志 K ...
- perl的Sys::Syslog模块(openlog,syslog,closelog函数,setlogsock)-自定义日志
perl的Sys::Syslog模块(openlog,syslog,closelog函数,setlogsock)-自定义日志 http://blog.chinaunix.net/xmlrpc.php? ...
- ELK:收集k8s容器日志最佳实践
简介 关于日志收集这个主题,这已经是第三篇了,为什么一再研究这个课题,因为这个课题实在太重要,而当今优秀的开源解决方案还不是很明朗: 就docker微服务化而言,研发有需求标准输出,也有需求文件输出, ...
随机推荐
- Eclipse启动报错[ out of memory error has occurred ]或[ An internal error occurred while showing an internal error ]
自我总结,有什么需要纠正或更好的方案,请告知,谢谢! 最近上来看到好多同学都遇到了这个问题,之前我也好几次碰到这个问题,很是恼火,什么没干,eclipse一开电脑就卡死了,后来发现不管是新打开ecli ...
- 服务器开发之CGI后门
1.html代码 <form id = "form" name="form" method="post" action=". ...
- C语言的格式符
转至:http://blog.csdn.net/zhanzheng520/article/details/10434791 一.格式符含义 1.d格式符:按十进制格式输出. %d ...
- 理解SSL/TLS协议
理解SSL/TLS协议 背景 早期我们在访问web时使用HTTP协议,该协议在传输数据时使用明文传输,明文传输带来了以下风险: 1.信息窃听风险,第三方可以获取通信内容 2.信息篡改风险,第三方可以篡 ...
- chrome disable-web-security 关闭安全策略 解决跨域
Chrome 跨域访问线上接口 时间:2016-04-21 作者:zhongxia 前后端分离之后,联调的时候就会出现问题,那就是Ajax跨域问题. 跨域问题的解决方案有很多种比如常规的 后端使用CR ...
- Django REST framework反向生成url
Django REST framework是一个基于Django的框架,REST framework又是怎么反向生成url的呢?? 在前面的例子中,知道在REST framework中有6种版本控制的 ...
- JUnit5 技术前瞻
更多原创测试技术文章同步更新到微信公众号 :三国测,敬请扫码关注个人的微信号,感谢! 原文链接:http://www.cnblogs.com/zishi/p/6868495.html JUnit ...
- CentOS7安装MySQL的方法之RPM包方式
CentOS7安装MySQL的方法之RPM包方式
- HTTP/1.1与HTTP/1.0的区别[转]
原文链接:http://blog.csdn.net/forgotaboutgirl/article/details/6936982 下面主要从几个不同的方面介绍HTTP/1.0与HTTP/1.1之间的 ...
- C++ 关于字符串总结(持续更新)
1.find_first_of size_type find_first_of( const basic_string &str, size_type index = 0 ); size_ty ...