
掌握Spark机器学习库-09.3-kmeans算法实现分类
数据集
iris.data
数据集概览
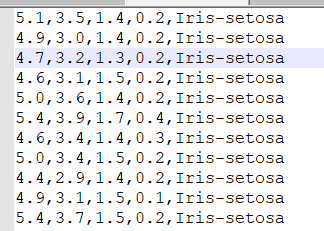
代码
package org.apache.spark.examples.hust.hml.examplesforml

import org.apache.spark.ml.clustering.{KMeans, LDA}

import org.apache.spark.SparkConf

import org.apache.spark.ml.feature.VectorAssembler

import org.apache.spark.sql.SparkSession

import scala.util.Random

object kmeans1 {

  def main(args: Array[String]): Unit = {

    val conf = new SparkConf().setMaster("local").setAppName("iris")

    val spark = SparkSession.builder().config(conf).getOrCreate()

    val file = spark.read.format("csv").load("D:\\9-1kmeans\\iris.data")

    file.show()

    import spark.implicits._

    val random = new Random()

    val data = file.map(row => {

      val label = row.getString(4) match {

        case "Iris-setosa" => 0

        case "Iris-versicolor" => 1

        case "Iris-virginica" => 2

      }

      (row.getString(0).toDouble,

        row.getString(1).toDouble,

        row.getString(2).toDouble,

        row.getString(3).toDouble,

        label,

        random.nextDouble())

    }).toDF("_c0", "_c1", "_c2", "_c3", "label", "rand").sort("rand")

    val assembler = new VectorAssembler()

      .setInputCols(Array("_c0", "_c1", "_c2", "_c3"))

      .setOutputCol("features")

    val dataset = assembler.transform(data)

    val Array(train, test) = dataset.randomSplit(Array(0.8, 0.2))

    train.show()

    val kmeans = new KMeans().setFeaturesCol("features").setK(3).setMaxIter(20)

    val model = kmeans.fit(train)

    model.transform(train).show()

  }

}
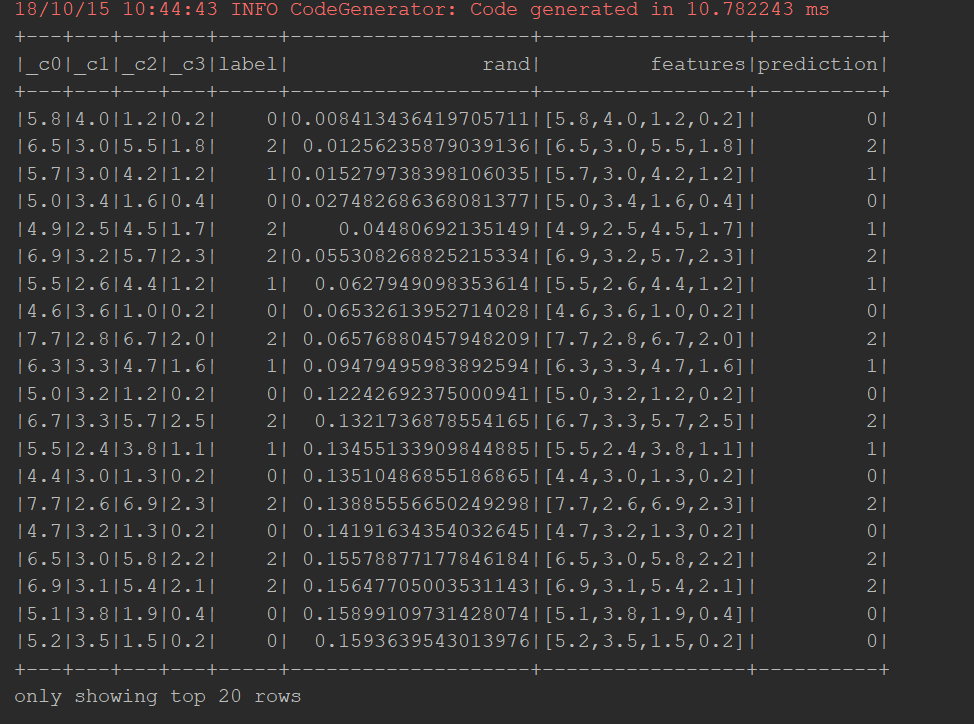
输出结果
掌握Spark机器学习库-09.3-kmeans算法实现分类的更多相关文章
- 掌握Spark机器学习库-09.6-LDA算法
数据集 iris.data 数据集概览 代码 package org.apache.spark.examples.examplesforml import org.apache.spark.ml.cl ...
- 掌握Spark机器学习库-07-线性回归算法概述
1)简介 自变量,因变量,线性关系,相关系数,一元线性关系,多元线性关系(平面,超平面) 2)使用线性回归算法的前提 3)应用例子 沸点与气压 浮力与表面积
- 掌握Spark机器学习库-08.7-决策树算法实现分类
数据集 iris.data 数据集概览 代码 package org.apache.spark.examples.examplesforml import org.apache.spark.Spark ...
- 掌握Spark机器学习库(课程目录)
第1章 初识机器学习 在本章中将带领大家概要了解什么是机器学习.机器学习在当前有哪些典型应用.机器学习的核心思想.常用的框架有哪些,该如何进行选型等相关问题. 1-1 导学 1-2 机器学习概述 1- ...
- UCI机器学习库和一些相关算法(转载)
UCI机器学习库和一些相关算法 各种机器学习任务的顶级结果(论文)汇总 https://github.com//RedditSota/state-of-the-art-result-for-machi ...
- Stanford机器学习笔记-9. 聚类(K-means算法)
9. Clustering Content 9. Clustering 9.1 Supervised Learning and Unsupervised Learning 9.2 K-means al ...
- 掌握Spark机器学习库-07.14-保序回归算法实现房价预测
数据集 house.csv 数据集概览 代码 package org.apache.spark.examples.examplesforml import org.apache.spark.ml.cl ...
- 掌握Spark机器学习库-08.2-朴素贝叶斯算法
数据集 iris.data 数据集概览 代码 import org.apache.spark.SparkConf import org.apache.spark.ml.classification.{ ...
- 掌握Spark机器学习库-07-回归算法原理
1)机器学习模型理解 统计学习,神经网络 2)预测结果的衡量 代价函数(cost function).损失函数(loss function) 3)线性回归是监督学习
随机推荐
- 授权QQ登录的qq端前端页面变迁
ac_type = 'qq' if ac_type == 'qq': myid, mypwd = qq_key xp = '/html/body/div/div/div[2]/div/div/div/ ...
- 每天进步一点点—mysql-mysqldump
一. 简单介绍 mysqldump是client用来备份数据库或者在不通数据库之间进行数据迁移的工具,备份内容包括创建表或者装载表的SQL语句 二. 命令格式 备份单个数 ...
- 在Android用ZXing.jar识别二维码的精简版(简化了配置和代码)
近期公司做了一款OTP令牌激活的产品,因为之前激活手机令牌须要输入非常多的激活信息才干进行激活. 经过一段使用后,发现易用性不是非常强,考虑假设添加二维码的的扫码功能岂不是大大添加了易 ...
- jetty与tomcat
相同点: 1.tomcat与jetty都是一种servlet引擎,他们都支持标准的servlet规范和javaEE规范 不同点: 1.架构比较 jetty相比tomcat更为简单 jetty架构是基于 ...
- 有关 enum的重新理解
有关enum 的再次理解: 所有的枚举都继承自java.lang.Enum类. 说到底enum也只是一个java类,只不过他有几个特殊的点. 1.enum中的各个实例,就是enum的static实 ...
- Ubuntu+anaconda环境里安装opencv
在Ubuntu的Anaconda环境下安装OpenCV比较方便,直接在终端中输入以下命令: conda install --channel https://conda.anaconda.org/men ...
- 【TJOI 2014】 上升子序列
[题目链接] 点击打开链接 [算法] 先考虑50分的做法 : f[i]表示以i结尾的本质不同的上升子序列的个数 则f[i] = sigma(f[j]) (j < i,a[j] < a[i] ...
- linq to EF分组查询 group by 的使用
第一种:查询表达式语法: IQueryable<EnrollmentDateGroup> data = from student in db.Students group student ...
- JSON与JSONP(转载)
JSON是一种数据交换格式,JSONP是非官方跨域数据交互协议.一个是描述信息的格式,一个是信息传递双方约定的方法. 一.JSON是一种基于文本的数据交换方式,或者叫做数据描述格式. ...
- IE浏览器下错误,不能执行已释放script的代码
错误提示: 错误原因: 我使用layui打开子页面,用到了父页面中的一个全局变量(我用的数组),子页面关闭后,使用该数组方法(如:arr.join(",")),便提示此错误 我的解 ...