
[Flink]Flink1.6三种运行模式安装部署以及实现WordCount
前言
Flink三种运行方式:Local、Standalone、On Yarn。成功部署后分别用Scala和Java实现wordcount
环境
版本:Flink 1.6.2
集群环境:Hadoop2.6
开发工具: IntelliJ IDEA
一.Local模式
解压:tar -zxvf flink-1.6.2-bin-hadoop26-scala_2.11.tgz
cd flink-1.6.2
启动:./bin/start-cluster.sh
停止:./bin/stop-cluster.sh
可以通过master:8081监控集群状态
二.Standalone模式
集群安装
1:修改conf/flink-conf.yaml
jobmanager.rpc.address: hadoop100
2:修改conf/slaves
hadoop101
hadoop102
3:拷贝到其他节点
scp -rq /usr/local/flink-1.6.2 hadoop101:/usr/local
scp -rq /usr/local/flink-1.6.2 hadoop102:/usr/local
4:在hadoop100(master)节点启动
bin/start-cluster.sh
5:访问http://hadoop100:8081
三.Flink On Yarn模式
On Yarn实现逻辑
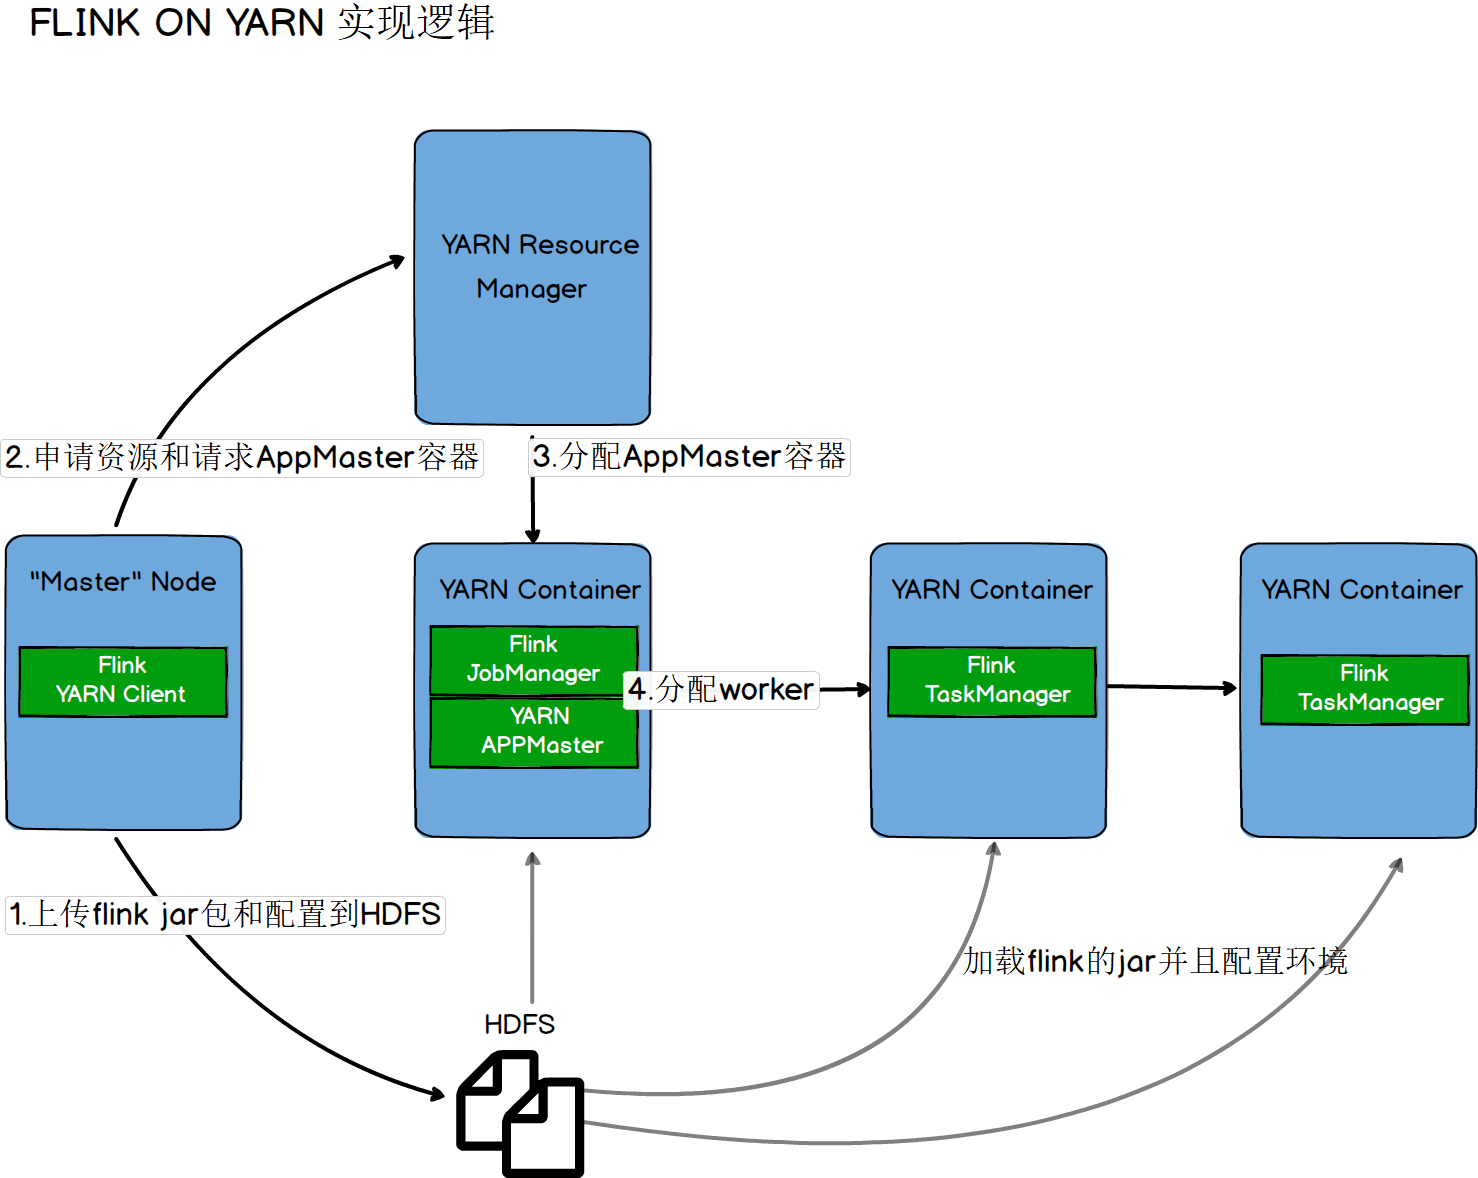
##### 第一种【yarn-session.sh(开辟资源)+flink run(提交任务)】
启动一个一直运行的flink集群
./bin/yarn-session.sh -n 2 -jm 1024 -tm 1024 [-d]
附着到一个已存在的flink yarn session
./bin/yarn-session.sh -id application_1463870264508_0029
执行任务
./bin/flink run ./examples/batch/WordCount.jar -input hdfs://hadoop100:9000/LICENSE -output hdfs://hadoop100:9000/wordcount-result.txt
停止任务 【web界面或者命令行执行cancel命令】
##### 第二种【flink run -m yarn-cluster(开辟资源+提交任务)】
启动集群,执行任务
./bin/flink run -m yarn-cluster -yn 2 -yjm 1024 -ytm 1024 ./examples/batch/WordCount.jar
注意:client端必须要设置YARN_CONF_DIR或者HADOOP_CONF_DIR或者HADOOP_HOME环境变量,通过这个环境变量来读取YARN和HDFS的配置信息,否则启动会失败
四.WordCount
代码
Scala实现代码
package com.skyell

import org.apache.flink.api.java.utils.ParameterTool

import org.apache.flink.streaming.api.scala.StreamExecutionEnvironment

import org.apache.flink.streaming.api.windowing.time.Time

/**

  * 滑动窗口计算

  *

  * 每隔1秒统计最近2秒数据,打印到控制台

  */

object SocketWindowWordCountScala {

  def main(args: Array[String]): Unit = {

    // 获取socket端口号

    val port: Int = try{

      ParameterTool.fromArgs(args).getInt("port")

    }catch {

      case e: Exception => {

        System.err.println("No port set use default port 9002--scala")

      }

        9002

    }

    // 获取运行环境

    val env: StreamExecutionEnvironment = StreamExecutionEnvironment.getExecutionEnvironment

    // 连接socket获取数据

    val text = env.socketTextStream("master", port, '\n')

    //添加隐式转换,否则会报错

    import org.apache.flink.api.scala._

    // 解析数据(把数据打平),分组,窗口计算,并且聚合求sum

    val windowCount = text.flatMap(line => line.split("\\s"))

      .map(w => WordWithCount(w, 1))

      .keyBy("word") // 针对相同word进行分组

      .timeWindow(Time.seconds(2), Time.seconds(1))// 窗口时间函数

      .sum("count")

    windowCount.print().setParallelism(1)  // 设置并行度为1

    env.execute("Socket window count")

  }

  // case 定义的类可以直接调用,不用new

  case class WordWithCount(word:String,count: Long)

}
Java实现代码
package com.skyell;

import org.apache.flink.api.common.functions.FlatMapFunction;

import org.apache.flink.api.java.DataSet;

import org.apache.flink.api.java.ExecutionEnvironment;

import org.apache.flink.api.java.operators.DataSource;

import org.apache.flink.api.java.tuple.Tuple2;

import org.apache.flink.util.Collector;

public class BatchWordCountJava {

    public static void main(String[] args) throws Exception{

        String inputPath = "D:\\DATA\\file";

        String outPath = "D:\\DATA\\result";

        // 获取运行环境

        ExecutionEnvironment env = ExecutionEnvironment.getExecutionEnvironment();

        // 读取本地文件中内容

        DataSource<String> text = env.readTextFile(inputPath);

        // groupBy(0):从0聚合  sum(1):以第二个字段加和计算

        DataSet<Tuple2<String, Integer>> counts = text.flatMap(new Tokenizer()).groupBy(0).sum(1);

        counts.writeAsCsv(outPath, "\n", " ").setParallelism(1);

        env.execute("batch word count");

    }

    public static class Tokenizer implements FlatMapFunction<String, Tuple2<String,Integer>>{

        public void flatMap(String value, Collector<Tuple2<String, Integer>> out) throws Exception {

            String[] tokens = value.toLowerCase().split("\\W+");

            for (String token: tokens

                 ) {

                if(token.length()>0){

                    out.collect(new Tuple2<String, Integer>(token, 1));

                }

            }

        }

    }

}
pom依赖配置
    <dependency>

            <groupId>org.apache.flink</groupId>

            <artifactId>flink-java</artifactId>

            <version>1.6.2</version>

            <scope>provided</scope>

        </dependency>

        <dependency>

            <groupId>org.apache.flink</groupId>

            <artifactId>flink-streaming-java_2.11</artifactId>

            <version>1.6.2</version>

            <scope>provided</scope>

        </dependency>

        <dependency>

            <groupId>org.apache.flink</groupId>

            <artifactId>flink-scala_2.11</artifactId>

            <version>1.6.2</version>

            <scope>provided</scope>

        </dependency>

        <dependency>

            <groupId>org.apache.flink</groupId>

            <artifactId>flink-streaming-scala_2.11</artifactId>

            <version>1.6.2</version>

            <scope>provided</scope>

        </dependency>
[Flink]Flink1.6三种运行模式安装部署以及实现WordCount的更多相关文章
- hadoop记录-[Flink]Flink三种运行模式安装部署以及实现WordCount(转载)
[Flink]Flink三种运行模式安装部署以及实现WordCount 前言 Flink三种运行方式:Local.Standalone.On Yarn.成功部署后分别用Scala和Java实现word ...
- ubuntu上Hadoop三种运行模式的部署
Hadoop集群支持三种运行模式:单机模式.伪分布式模式,全分布式模式,下面介绍下在Ubuntu下的部署 (1)单机模式 默认情况下,Hadoop被配置成一个以非分布式模式运行的独立JAVA进程,适合 ...
- Tomcat Connector的三种运行模式
详情参考: http://tomcat.apache.org/tomcat-7.0-doc/apr.html http://www.365mini.com/page/tomcat-connector- ...
- 【Tomcat】Tomcat Connector的三种运行模式【bio、nio、apr】
Tomcat Connector(Tomcat连接器)有bio.nio.apr三种运行模式 bio bio(blocking I/O,阻塞式I/O操作),表示Tomcat使用的是传统的Java I/O ...
- PHP语言学习之php-fpm 三种运行模式
本文主要向大家介绍了PHP语言学习之php-fpm 三种运行模式,通过具体的内容向大家展示,希望对大家学习php语言有所帮助. php-fpm配置 配置文件:php-fpm.conf 开启慢日志功能的 ...
- Tomcat Connector三种运行模式(BIO, NIO, APR)的比较和优化
Tomcat Connector的三种不同的运行模式性能相差很大,有人测试过的结果如下: 这三种模式的不同之处如下: BIO: 一个线程处理一个请求.缺点:并发量高时,线程数较多,浪费资源. Tomc ...
- Tomcat Connector(BIO, NIO, APR)三种运行模式(转)
Tomcat支持三种接收请求的处理方式:BIO.NIO.APR . BIO 阻塞式I/O操作即使用的是传统 I/O操作,Tomcat7以下版本默认情况下是以BIO模式运行的,由于每个请求都要创建一个线 ...
- php-fpm 三种运行模式
php-fpm配置 配置文件:php-fpm.conf 开启慢日志功能的: slowlog = /usr/local/var/log/php-fpm.log.slowrequest_slowlog_t ...
- python编程(python开发的三种运行模式)【转】
转自:http://blog.csdn.net/feixiaoxing/article/details/53980886 版权声明:本文为博主原创文章,未经博主允许不得转载. 目录(?)[-] 单循环 ...
随机推荐
- spring源码分析系列3:BeanFactory核心容器的研究
目录 @(spring源码分析系列3:核心容器的研究) 在讲容器之前,再明确一下知识点. BeanDefinition是Bean在容器的描述.BeanDefinition与Bean不是一个东西. Be ...
- 移动端适配 rem 设置
refresh(); window.onresize = function(){ setTimeout(function(){ refresh(); },10) ...
- Thread线程类
设置线程名 查看线程名是很简单的,调用Thread.currentThread().getName()即可. public class MyThreadDemo { public static voi ...
- Java 学习笔记之 线程脏读
线程脏读: 发生脏读的情况是在读取实例变量时,值已经被其他线程更改过了. public class DirtyReadVar { public String username = "A&qu ...
- Django默认权限机制介绍及实践
演示Django版本为当前最新版本v2.2 当Django配置文件中的INSTALL_APPS包含了django.contrib.auth时,就默认启用了一个简单的权限系统,提供了为用户或组分配权限的 ...
- package.json详解
1.概念 Node.js项目遵循模块化的架构,当我们创建了一个Node.js项目,意味着创建了一个模块,这个模块的描述文件,被称为package.json 亦即:模块的描述文件 = package.j ...
- 简单cookie入侵
在当前网站,按下F12键进入开发者模式,在console控制台输入:document.cookie获取cookie值如: 复制你得到cookie值,你或通过每种方式获取Cookie,例如:当别人点击你 ...
- 客户端 SOCKET 编程
建立客户端的 Socket: 客户端应用程序首先也是调用 WSAStartup() 函数来初始化 Winsock 的动态连接库,然后同样 调用 socket() 来建立一个 TCP 或 UDP Soc ...
- Node.js新手必须知道的4个JavaScript概念
如果只需要知道一种编程语言就可以构建一个全栈的应用程序,是不是特别了不起?Ryan Dahl为了把这个想法成为现实,创造了node.js.Node.js是建立在Chrome强劲的V8 JavaScri ...
- Oracle基于布尔的盲注总结
0x01 decode 函数布尔盲注 decode(字段或字段的运算,值1,值2,值3) 这个函数运行的结果是,当字段或字段的运算的值等于值1时,该函数返回值2,否则返回3 当然值1,值2,值3也可以 ...