
dplyr 数据操作 统计描述(summarise)
在R中,summary()是一个基础包中的重要统计描述函数,同样的在dplyr中summarise()函数也可以对数据进行统计描述。
不同的是summarise()更加的灵活多变,下面来看下summarise这个函数
summarise(.data, ...)
其灵活性和其他dplyr函数一样,主要在于条件的使用上
下面看些具体的例子
library(dplyr)

x<-data.frame(id=1:6,

              name=c("wang","zhang","li","chen","zhao","song"),

              shuxue=c(89,85,68,79,96,53),

              yuwen=c(77,68,86,87,92,63))

x

summarise(x,sum(shuxue))

可以很好的配合聚合函数一起使用
summarise(group_by(x,name),sum(shuxue))

这里由于每个name对应的shuxue只有一个参数,所以sum的结果没变化。
summarise(group_by(x,name),sum(shuxue,yuwen))

可以看出shuxue和yuwen求和后的数据。
arrange(summarise(group_by(x,name),qiuhe=sum(shuxue,yuwen)),desc(qiuhe))

配合上前面的函数,就可以对求和后的数据进行排序,当然上面数据的可读性较低。
把他分为两个步骤,理解起来可能会相对比较容易。
y<-summarise(group_by(x,name),qiuhe=sum(shuxue,yuwen)) 求和过程
arrange(y,desc(qiuhe)) 排序过程
summarise(x,mean(shuxue),sd(shuxue))

求均值和方差
summarise(group_by(x,name),a=n(),b=a+2)

配合你n()可以对每个因子的出现次数进行统计。
summarise_all(group_by(x,name),mean)

对所有列按照name分组后求平均值
summarise_if(x,is.numeric,mean)
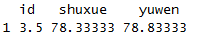
对所有是数值的列求平均值
summarise_at(x,c(3,4),mean)
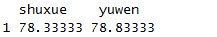
对特定的列求平均值
类似结果的表达方式有:
summarise_at(x,vars(shuxue,yuwen),mean)
summarise_at(x,c("shuxue","yuwen"),mean)
summarise_all(select(x,c(1,3,4)),funs(min,max,mean,sum,sd))
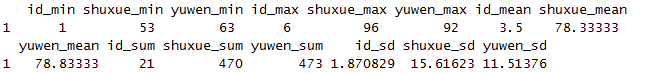
使用funs,对数据进行多重聚合统计。
summarise_each(x[c(1,3,4)],funs(mean,sum))
summarise_each也可以达到类似的效果。
dplyr 数据操作 统计描述(summarise)的更多相关文章
- SQL大数据操作统计
SQL大数据操作统计 1:select count(*) from table的区别SELECT object_name(id) as TableName,indid,rows,rowcnt FROM ...
- dplyr 数据操作 常用函数(5)
继续来了解dplyr中的其他有用函数 1.sample() 目的是可以从一个数据框中,随机抽取一些行,然后组成新的数据框. sample_n(tbl, size, replace = FALSE, w ...
- dplyr 数据操作 常用函数(3)
接下了我们继续了解dplyr中有用的函数 1.if_else() if_else主要用于在数据做判断用 x<-data.frame(id=1:6, name=c("wang" ...
- dplyr 数据操作 常用函数(1)
上面介绍完dplyr中,几个主要的操作函数后,我们再进一步了解dplyr中那些函数可能我们会经常要用到. 这里主要根据dplyr包作者的书籍目录来把它列出来. 1.add_rownames 添加行名称 ...
- dplyr 数据操作 列操作(select / mutate)
在R中,我们通常需要对数据列进行各种各样的操作,比如选取某一列.重命名某一列等. dplyr中的select函数子在数据列的操作上也同样表现了它的简洁性,而且各种操作眼花缭乱. select(.dat ...
- dplyr 数据操作 数据过滤 (filter)
在R的使用过程中我们几乎都绕不开Hadley Wickham 开发的几个包,前面说过的ggplot2.reshape2以及即将要讲的dplyr 因为这几个包可以非常轻易的使我们从复杂的数据操作中逃离, ...
- dplyr 数据操作 常用函数(4)
接下来我们继续了解一些dplyr中的常用函数. 1.ranking 以下各个函数可以实现对数据进行不同的排序 row_number(x) ntile(x, n) min_rank(x) dense_r ...
- dplyr 数据操作 常用函数(2)
继上一节常用函数,继续了解其他函数 1.desc() 这个函数和SQL中的排序用法是一样的,表示对数据进行倒序排序. 接下来我们看些例子. a=sample(20,50,rep=T)a desc(a) ...
- dplyr 数据操作 数据排序 (arrange)
在R中,我们在整理数据时,经常需要对数据排序,以便数据增强数据的可读性. 下面我们来看下dplyr中的,arrange函数 arrange(.data, ...) 跟filter()类似,arrang ...
随机推荐
- Android学习笔记(三)Android开发环境的搭建
一.配置JAVA环境 二.配置Android开发环境 可以安装adt-bundle-windows,该压缩包一般自带Eclipse.或者安装Android Studio,要注意SDK的版本是否符合要求 ...
- git commit
使用 git add 命令将想要快照的内容写入缓存区, 而执行 git commit 将缓存区内容添加到仓库中. Git 为你的每一个提交都记录你的名字与电子邮箱地址,所以第一步需要配置用户名和邮箱地 ...
- CentOS 手动增加、删除swap区
SWAP是Linux中的虚拟内存,用于扩充物理内存不足而用来存储临时数据存在的.它类似于Windows中的虚拟内存.在Windows中,只可以使用文件来当作虚拟内存.而linux可以文件或者分区来当作 ...
- 在二叉搜索树(BST)中查找第K个大的结点之非递归实现
一个被广泛使用的面试题: 给定一个二叉搜索树,请找出其中的第K个大的结点. PS:我第一次在面试的时候被问到这个问题而且让我直接在白纸上写的时候,直接蒙圈了,因为没有刷题准备,所以就会有伤害.(面完的 ...
- table中td内容过长 省略号显示
首先设置 css样式: table { table-layout: fixed;} HTML中的table代码: <tr> <th class="col-md-1" ...
- ubuntu_虚拟机和SD卡链接失败,可能的原因
这个问题很简单吧,但是自己解决却用了很长时间,说一下方法吧! 1.有的虚拟机不兼容USB3.0的接口,所以在接SD卡(读卡器)时,请将读卡器拔出,插入笔记本USB2.0的接口上(当时自己没注意到这点, ...
- ZendStudio9之SVN项目代码提示丢失解决
前几天转移服务器,SVN 也重建了个,但用着重建的项目发现代码提示丢失了...好郁闷..搞了半天终于找到解决的方法了! 如果你还保留有以前的 SVN 项目本地完整备份,可以直接拷贝以下三个文件到新项目 ...
- git换行符之autoCRLF配置的意义
关于git换行符处理的问题,我查了一查,自己的设置中,global-config中设了autocrlf=false,systemwide中将autocrlf设成了true. 关于配置的作用域,syst ...
- hdu 3507 Print Article(斜率优化DP)
题目链接:hdu 3507 Print Article 题意: 每个字有一个值,现在让你分成k段打印,每段打印需要消耗的值用那个公式计算,现在让你求最小值 题解: 设dp[i]表示前i个字符需要消耗的 ...
- eclipse 安卓运行一直跳转到调试模式
最直接的办法,换手机试试,如果在其他手机上能run,那就重启手机即可 感觉写这么一点点似乎不足以发表一篇博客,给个链接吧:http://www.itnose.net/detail/6103213.ht ...