
KNN算法的实现(R语言)
一 . K-近邻算法(KNN)概述
最简单最初级的分类器是将全部的训练数据所对应的类别都记录下来,当测试对象的属性和某个训练对象的属性完全匹配时,便可以对其进行分类。但是怎么可能所有测试对象都会找到与之完全匹配的训练对象呢,其次就是存在一个测试对象同时与多个训练对象匹配,导致一个训练对象被分到了多个类的问题,基于这些问题呢,就产生了KNN。
KNN是通过测量不同特征值之间的距离进行分类。它的思路是:如果一个样本在特征空间中的k个最相似(即特征空间中最邻近)的样本中的大多数属于某一个类别,则该样本也属于这个类别,其中K通常是不大于20的整数。KNN算法中,所选择的邻居都是已经正确分类的对象。该方法在定类决策上只依据最邻近的一个或者几个样本的类别来决定待分样本所属的类别。
下面通过一个简单的例子说明一下:如下图,绿色圆要被决定赋予哪个类,是红色三角形还是蓝色四方形?如果K=3,由于红色三角形所占比例为2/3,绿色圆将被赋予红色三角形那个类,如果K=5,由于蓝色四方形比例为3/5,因此绿色圆被赋予蓝色四方形类。由此也说明了KNN算法的结果很大程度取决于K的选择。
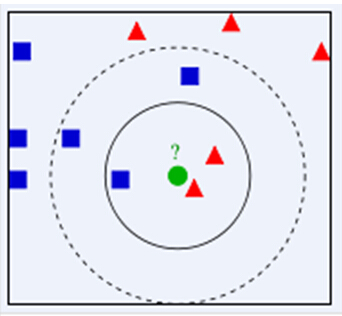
在KNN中,通过计算对象间距离来作为各个对象之间的非相似性指标,避免了对象之间的匹配问题,在这里距离一般使用欧氏距离或曼哈顿距离。同时,KNN通过依据k个对象中占优的类别进行决策,而不是单一的对象类别决策。这两点就是KNN算法的优势。
接下来对KNN算法的思想总结一下:就是在训练集中数据和标签已知的情况下,输入测试数据,将测试数据的特征与训练集中对应的特征进行相互比较,找到训练集中与之最为相似的前K个数据,则该测试数据对应的类别就是K个数据中出现次数最多的那个分类,其算法的描述为:
1)计算测试数据与各个训练数据之间的距离;
2)按照距离的递增关系进行排序;
3)选取距离最小的K个点;
4)确定前K个点所在类别的出现频率;
5)返回前K个点中出现频率最高的类别作为测试数据的预测分类。
代码实现:
# KNN Regression function

knn <- function(train.data, train.label, test.data, K=3, distance = 'euclidean'){

    ## count number of train samples

    train.len <- nrow(train.data)

    ## count number of test samples

    test.len <- nrow(test.data)

    ## New List for hold the test label (the length is the same with the length of test data)

    test.label <- rep(0,test.len)

    ## calculate distances between samples

    dist <- as.matrix(dist(rbind(test.data, train.data), method= distance))[1:test.len, (test.len+1):(test.len+train.len)]

    ## for each test sample

    for (i in 1:test.len){

        ### find its K nearest neighbours from training sampels...

        nn <- as.data.frame(sort(dist[i,], index.return = TRUE))[1:K,2]

        ### and calculate the predicted labels according to the average of the neighbors’ values

        test.label[i]<-mean(train.label[nn])

    }

    ## return the predict values

    return (test.label)

}

## Load Library

library(ggplot2)

library(reshape2)

## Load Dataset

Task1A_train <- read.csv("Task1A_train.csv")

Task1A_test <- read.csv("Task1A_test.csv")
这里,我们计算error function,直接就是求MSE
距离的话 我们直接用几何距离
## Create train and test data

train.data <- as.matrix(Task1A_train[,1])

train.label <- as.matrix(Task1A_train[,-1])

test.data <- as.matrix(Task1A_test[,1])

test.label <- as.matrix(Task1A_test[,-1])

# KNN Regression function

knn <- function(train.data, train.label, test.data, K=3, distance = 'euclidean'){

    ## count number of train samples

    train.len <- nrow(train.data)

    ## count number of test samples

    test.len <- nrow(test.data)

    ## New List for hold the test label (the length is the same with the length of test data)

    test.label <- rep(0,test.len)

    ## calculate distances between samples

    dist <- as.matrix(dist(rbind(test.data, train.data), method= distance))[1:test.len, (test.len+1):(test.len+train.len)]

    ## for each test sample

    for (i in 1:test.len){

        ### find its K nearest neighbours from training sampels...

        nn <- as.data.frame(sort(dist[i,], index.return = TRUE))[1:K,2]

        ### and calculate the predicted labels according to the average of the neighbors’ values

        test.label[i]<-mean(train.label[nn])

    }

    ## return the predict values

    return (test.label)

}

# calculate the regression error for K in 1:20

# Here we use Mean Square Error (MSE)

miss <- data.frame('K'=1:20, 'train'=rep(0,20), 'test'=rep(0,20)) # New data frame to store the error value

for (k in 1:20){

    miss[k,'train'] <- sum((knn(train.data, train.label, train.data, K=k) - train.label) ^ 2)/nrow(train.data)

    miss[k,'test'] <-  sum((knn(train.data, train.label, test.data, K=k)  - test.label) ^ 2)/nrow(test.data)

}
我们这里采用的是K 从1 到20
那门我们把产生的error给plot出来,大概判断下,哪个K是最小的
## Plot the training and the testing errors versus 1/K for K=1,..,20

miss.m <- melt(miss, id='K') # reshape for visualization

names(miss.m) <- c('K', 'type', 'error')

ggplot(data=miss.m, aes(x=log(1/K), y=error, color=type)) + geom_line() +

       geom_point() +

       scale_color_discrete(guide = guide_legend(title = NULL)) + theme_minimal() +

       ggtitle("KNN Regression Error")
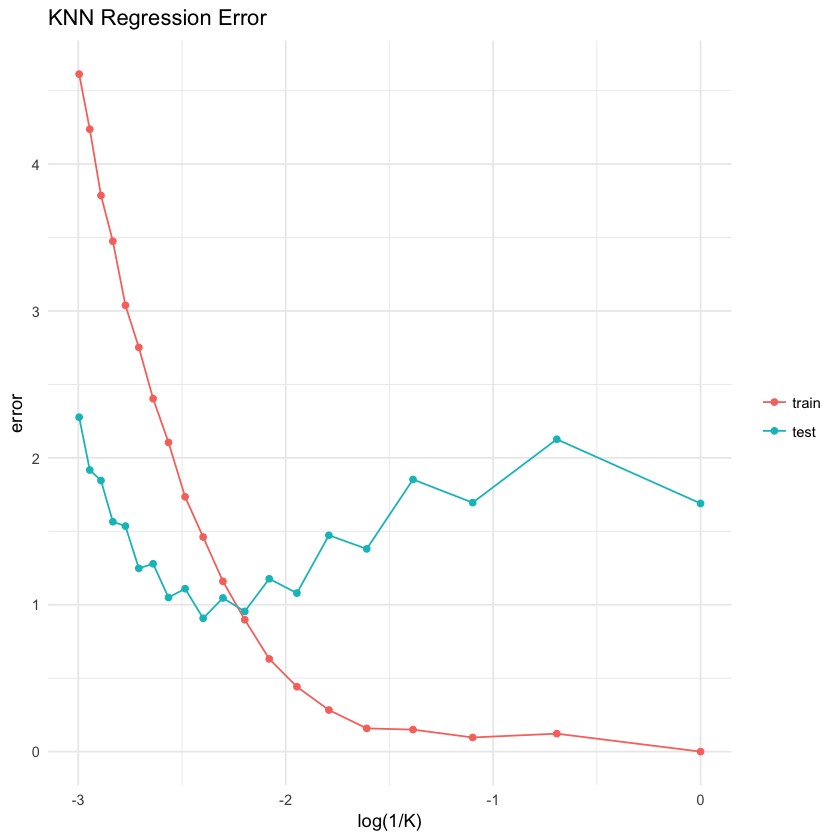
这里我们可以发现 在K= 11的时候,此时针对这个数据集,KNN的在error处理上效果更好。
KNN算法的实现(R语言)的更多相关文章
- KNN算法的R语言实现
近邻分类 简言之,就是将未标记的案例归类为与它们最近相似的.带有标记的案例所在的类. 应用领域: 1.计算机视觉:包含字符和面部识别等 2.推荐系统:推荐受众喜欢电影.美食和娱乐等 3.基因工程:识别 ...
- KNN算法的实现
K近邻(KNN)算法简介 KNN是通过测量不同特征值之间的距离进行分类.它的思路是:如果一个样本在特征空间中的k个最相似(即特征空间中最邻近)的样本中的大多数属于某一个类别,则该样本也属于这个类别,其 ...
- KMP算法的实现(Java语言描述)
标签:it KMP算法是模式匹配专用算法. 它是在已知模式串的next或nextval数组的基础上执行的.如果不知道它们二者之一,就没法使用KMP算法,因此我们需要计算它们. KMP算法由两部分组成: ...
- 机器学习与R语言:kNN
#---------------------------------------- # 功能描述:演示kNN建模过程 # 数据集:威斯康星乳腺癌诊断 # #---------------------- ...
- 【机器学*与R语言】2-懒惰学*K*邻(kNN)
目录 1.理解使用KNN进行分类 KNN特点 KNN步骤 1)计算距离 2)选择合适的K 3)数据准备 2.用KNN诊断乳腺癌 1)收集数据 2)探索和准备数据 3)训练模型 4)评估模型的性能 5) ...
- 数据分析与R语言
数据结构 创建向量和矩阵 函数c(), length(), mode(), rbind(), cbind() 求平均值,和,连乘,最值,方差,标准差 函数mean(), sum(), min(), m ...
- 数据分析,R语言
数据结构 创建向量和矩阵 1 函数c(), length(), mode(), rbind(), cbind() 求平均值,和,连乘,最值,方差,标准差 1 函数mean(), sum(), min( ...
- R 语言机器学习同步推进~
教材就是传说中的机器学习和R语言--中文版,大家可以去图书馆借来看看~~~,例子都是来自书上的 首先介绍一下KNN算法,KNN还好吧,说白了就是一个算距离的公式然后以统计的方式呈现出来,以二维平面为例 ...
- R语言书籍的学习路线图
现在对R感兴趣的人越来越多,很多人都想快速的掌握R语言,然而,由于目前大部分高校都没有开设R语言课程,这就导致很多人不知道如何着手学习R语言. 对于初学R语言的人,最常见的方式是:遇到不会的地方,就跑 ...
随机推荐
- windows常用的cmd网络命令
一.ping 它是用来检查网络是否通畅或者网络连接速度的命令.作为一个生活在网络上的管理员或者黑客来说,ping命令是第一个必须掌握的DOS命令,它所利用的原理是这样的:网络上的机器都有唯一确定的IP ...
- MacOs安装mysql与修改root密码
1.下载安装包 http://www.mysql.com/downloads/ 找到如下内容下载 mysql-5.7.21-1-macos10.13-x86_64.dmg下载地址是 https://c ...
- 面向对象设计模式纵横谈:Builder 生成器模式(笔记记录)
Builder模式的缘起 假设创建游戏中的一个房屋House设施,该房屋的构建由几个部分组成,且各个部分要富于变化. 如果使用最直观的设计方法,每一个房屋部分的变化,都将导致房屋构建的重新修正…… 动 ...
- 【附案例】UI交互设计不会做?设计大神带你开启动效灵感之路
随着网络技术的创新发展,如今UI交互设计应用越来越广泛,显然已经成为设计的主流及流行的必然趋势.UI界面交互设计中的动效包括移动,滑块,悬停效果,GIF动画等.UI界面交互设计为何越来越受到青睐?它有 ...
- vue的过滤器
Vue.Js 提供了强大的过滤器API,能够对数据进行各种过滤处理,返回需要的结果 vue的过滤器一般在JavaScript 表达式的尾部,由“|”符号指示: 过滤器可以让我们的代码更加优美,一般可以 ...
- filter 死循环(tomcat 启动完成 ,自动执行filter.dofilter,导致tomcat 启动超时) , tomcat 启动和 servers 启动 不同
package com.diancai.interceptor; import java.io.IOException; import javax.servlet.Filter; import jav ...
- 100 floors 2 eggs
https://github.com/Premiumlab/Python-for-Algorithms--Data-Structures--and-Interviews/blob/master/Moc ...
- [转]Go与C语言的互操作
Go有强烈的C背景,除了语法具有继承性外,其设计者以及其设计目标都与C语言有着千丝万缕的联系.在Go与C语言互操作(Interoperability)方面,Go更是提供了强大的支持.尤其是在Go中使用 ...
- Python 正斜杠/与反斜杠\
首先,"/"左倾斜是正斜杠,"\"右倾斜是反斜杠,可以记为:除号是正斜杠一般来说对于目录分隔符,Unix和Web用正斜杠/,Windows用反斜杠,但是现在Wi ...
- svn错误:Can't convert string from 'UTF-8' to native encoding
如果文件名包含了中文,当执行"svn up ."遇到如下错误时: svn: Can't convert string from 'UTF-8' to native encoding ...