
MySQL 索引分析
MySQL复合唯一索引分析
关于复合唯一索引(unique key 或 unique index),网上搜索不少人说:”这种索引起到的关键作用是约束,查询时性能上没有得到提高或者查询时根本没有走索引列“。也有人说:“查询时使用到了索引和普通索引一样“。那么问题到底是怎样的呢?
测试准备工作
准备建表语句,插入数据等工作:
-- 建表(注:a,b是复合唯一索引)

create table test0(id bigint not null primary key auto_increment, a varchar(10) not null, b varchar(10) not null, unique index(a, b))engine=innodb charset=utf8 auto_increment=1;

-- 插入数据

insert into test0(a, b)values('china', 'chinese');

insert into test0(a, b)values('japan', 'japanese');

insert into test0(a, b)values('germany', 'german');

insert into test0(a, b)values('korea', 'korea');

insert into test0(a, b)values('france', 'frence');

insert into test0(a, b)values('australia', 'australia');

insert into test0(a, b)values('america', 'american');

insert into test0(a, b)values('brazil', 'brazil');

-- 执行计划一(查询存在纪录)

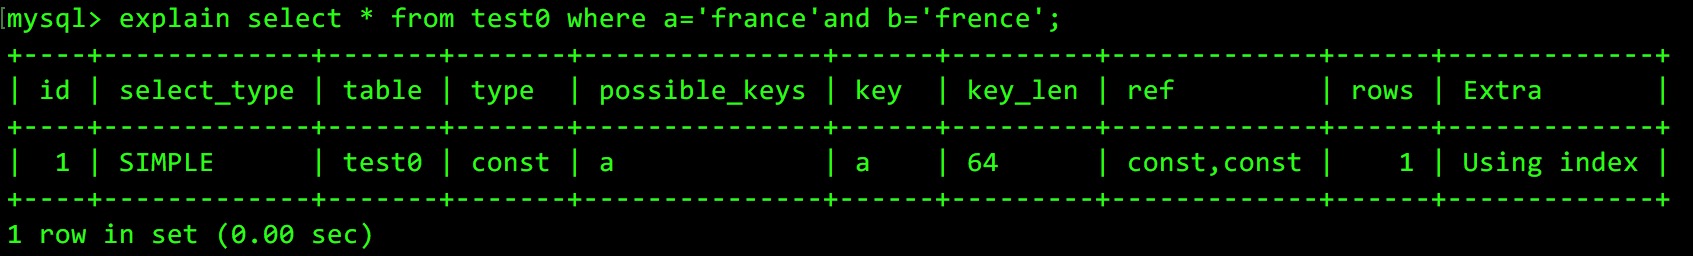
explain select * from test0 where a='france' and b='frence';

-- 执行计划二(查询不存在纪录)

explain select * from test0 where a='france' and b='america';
执行计划一:
执行计划二:
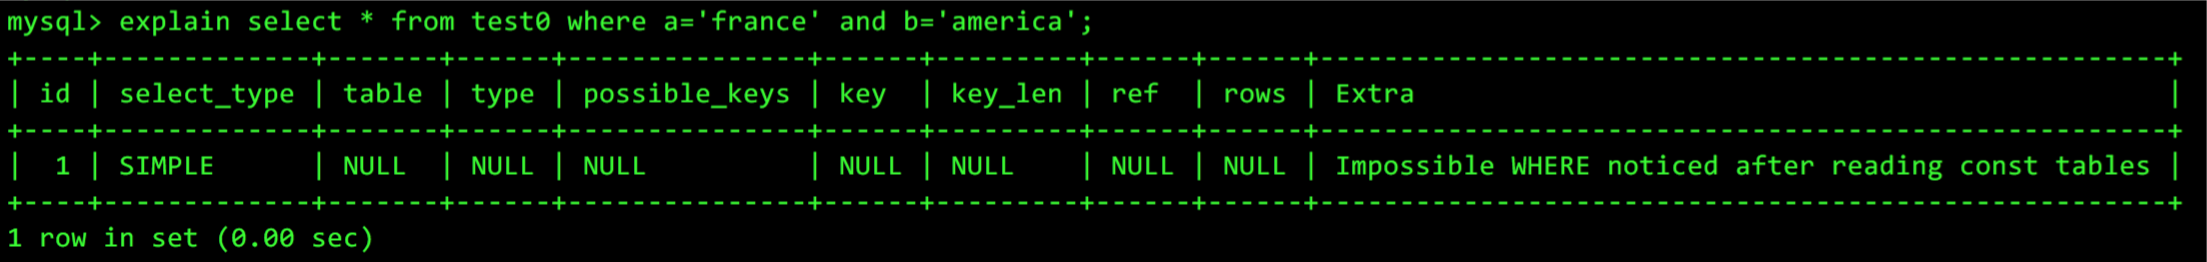
综上可以看出:
执行计划一,查询条件匹配时命中所有的索引;
执行计划二,查询条件不匹配时没有命中索引,并返回一条Extra”Impossible WHERE noticed after reading const tables”
那么到底这两次查询有什么不同呢?
MySQL关于这种索引的执行计划以及优化方案是什么?
我不得不把官方的Doc阅读一遍,关键点总结如下:
Explain join types 执行计划”type”列表,从执行性能最好到最坏:
1. system
表中只有一行数据(=system table)。这是常数连接类型的特例。
2. const
在查询开始时读取表时仅有一行可以匹配的数据。因为仅匹配到一行数据,所以值列可以被认为是常数级优化。常数表查询非常快因为它们只读取一次就能命中。
常数类型仅仅在匹配”PRIMARY KEY”或者”UNIQUE INDEX”所有的列值时才会被使用。
下面的查询,表被当成常数表执行:
    -- query 1

    SELECT * FROM tbl_name WHERE primary_key=1;

    SELECT * FROM tbl_name

WHERE primary_key_part1=1 AND primary_key_part2=2;- ref
所有带索引值匹配的行都从这张表读取各种组合的行从之前的表读取。如果连接使用key的只是最左前缀,或者key不是PRIMARY KEY和UNIQUE index使用ref(换句话说,如果连接跟进key值没有查询单行数据)。如果这个key值使用时匹配了仅仅少数的行,这就是一个比较好的类型。
ref 可以用在索引列,条件匹配时使用”=” 或者 “<=>”操作。下面的示例,MySQL 能够使用ref连接处理 ref_table:
    SELECT * FROM ref_table WHERE key_column=expr;

    SELECT * FROM ref_table,other_table

      WHERE ref_table.key_column=other_table.column;

    SELECT * FROM ref_table,other_table

      WHERE ref_table.key_column_part1=other_table.column

AND ref_table.key_column_part2=1;- ref_or_null
这种连接有点类似于ref, 但是查询行包含NULL值时,MySQL会作额外的查询。这种连接类型的优化最经常在解决子查询的时候使用。下面的例子,MySQL会使用ref_or_nulll连接处理ref_table:
SELECT * FROM ref_table

      WHERE key_column=expr OR key_column IS NULL;
参见 8.2.1.6, “IS NULL 优化”.
index_merge
这种连接类型说明已经启用索引合并优化。这种场景下,输出行中的key列包含用于索引的列表,并且key_len显示索引使用的最长key parts。更多信息参见“索引合并优化”。- range
只有当行根据给定范围检索到时,使用一个索引查询这些行。输出行的key列表明使用哪个索引。key_len列显示使用最长的key part。这种连接ref列为NULL。
当key列和一个常量使用”=”, “<>”, “>”, “>=”, “<”, “<=”, IS NULL, “<=>”, BETWEEN, 或者IN()比较时使用range连接:
- range
    SELECT * FROM tbl_name WHERE key_column = 10;

    SELECT * FROM tbl_name WHERE key_column BETWEEN 10 and 20;

    SELECT * FROM tbl_name WHERE key_column IN (10,20,30);

    SELECT * FROM tbl_name WHERE key_part1 = 10

    AND key_part2 IN (10,20,30);
index
索引连接类型和ALL一样,除了扫描索引树。两种执行方式:
如果索引在查询里是一个覆盖性的索引,并且能够查询表中所有满足的数据,只有索引树被扫描。这种场景下,Extra列会显示”Using index”。通常只走索引扫描比全表扫描要快很多,因为索引的数量通常比表中的数据量要少很多。全表扫描优化方案是通过读取索引并按照索引顺序检索数据。使用索引不会在Etra列显示。列使用单一索引时,MySQL使用这种连接类型。- ALL
全表扫描。通常,应该通过添加索引避免全表扫描。
- ALL
EXPLAIN Extra Information
The Extra column of EXPLAIN output contains additional information about how MySQL resolves the query. The following list explains the values that can appear in this column. If you want to make your queries as fast as possible, look out for Extra values of Using filesort and Using temporary.
1. Child of 'table' pushed join@1

This table is referenced as the child of table in a join that can be pushed down to the NDB kernel. Applies only in MySQL Cluster NDB 7.2 and later, when pushed-down joins are enabled. See the description of the ndb_join_pushdown server system variable for more information and examples.

2. const row not found

For a query such as SELECT ... FROM tbl_name, the table was empty.

3. Distinct

MySQL is looking for distinct values, so it stops searching for more rows for the current row combination after it has found the first matching row.

4. Full scan on NULL key

This occurs for subquery optimization as a fallback strategy when the optimizer cannot use an index-lookup access method.

5. Impossible HAVING

The HAVING clause is always false and cannot select any rows.

6. Impossible WHERE

The WHERE clause is always false and cannot select any rows.

Impossible WHERE noticed after reading const tables

MySQL has read all const (and system) tables and notice that the WHERE clause is always false.
MySQL 索引分析的更多相关文章
- B+Tree和MySQL索引分析
首先区分两组概念: 稠密索引,稀疏索引: 聚簇索引,非聚簇索引: btree和mysql的分析: 参见 http://blog.csdn.net/hguisu/article/details/7786 ...
- Mysql索引分析:适合建索引?不适合建索引?【转】
数据库建立索引常用的规则如下: 1.表的主键.外键必须有索引: 2.数据量超过300的表应该有索引: 3.经常与其他表进行连接的表,在连接字段上应该建立索引: 4.经常出现在Where子句中的字段,特 ...
- MySQL索引分析
索引的出现解决数据量上升导致查询越来越慢的问题,优化数据的查询,提高查询的速度. 索引 定义: 通过各种数据结构实现的值到行位置的映射.快速定位与访问特定的数据. 作用: 提高访问速度 实现主键.唯一 ...
- MySQL索引分析与优化
1.MySQL能够在name的索引中查找“Mike”值,然后直接转到数据文件中相应的行,准确地返回该行的 peopleid(999).在这个过程中,MySQL只需处理一个行就可以返回结果.如果没有“n ...
- MySql索引分析及查询优化
B-Tree 核心特点: 多路,非二叉树 每个节点既保存索引,又保存数据 搜索时相当于二分查找 B+Tree 核心特点 多路非二叉 只有叶子节点保存数据 搜索时相当于二分查找 增加了相邻接点的指向指针 ...
- MySQL索引分析及使用
一.索引介绍 1.1.什么是索引? 一般的应用系统,读写比例在10:1左右,而且插入操作和一般的更新操作很少出现性能问题,在生产环境中,我们遇到最多的,也是最容易出问题的,还是一些复杂的查询操作,因此 ...
- MySQL索引 专题
什么是索引 索引是存储引擎用于快速找到记录的一种数据结构,索引类似一本书的目录,我们可以快速的根据目录查找到我们想要的内容的所在页码,索引的优化应该是对查询性能优化最有效的手段了. 因此,首先你要明白 ...
- MYSQL索引结构原理、性能分析与优化
[转]MYSQL索引结构原理.性能分析与优化 第一部分:基础知识 索引 官方介绍索引是帮助MySQL高效获取数据的数据结构.笔者理解索引相当于一本书的目录,通过目录就知道要的资料在哪里, 不用一页一页 ...
- 深入浅出分析MySQL索引设计背后的数据结构
在我们公司的DB规范中,明确规定: 1.建表语句必须明确指定主键 2.无特殊情况,主键必须单调递增 对于这项规定,很多研发小伙伴不理解.本文就来深入简出地分析MySQL索引设计背后的数据结构和算法,从 ...
随机推荐
- vim copy termi
用vim写代码时,经常遇到这样的场景,复制多行,然后粘贴. 这样做:1. 将光标移动到要复制的文本开始的地方,按v进入可视模式.2. 将光标移动到要复制的文本的结束的地方,按y复制.此时vim会自动将 ...
- SuperSocket内置的命令行协议的解析
SuperSocket\SocketBase\Protocol\TerminatorReceiveFilter.cs /// <summary> /// Filters received ...
- servlet中的中文乱码问题
老师总会说道:学完这个知识点,我们来谈谈中文乱码问题. 乱码的问题总是无处不在,处理不好会给用户带极差的用户体验. 那么我们来记录一下servlet中的乱码问题吧! 1.服务器向客户端响应时出现的乱码 ...
- 在Twitter信息流中大规模应用深度学习——推文的相关度计算使用了深度学习
我们如何对信息流进行排序? 在引入排序算法之前,信息流的组成非常简单:收集所有由你的关注对象在你最后一次登录Twitter之后发送的推文,再将它们按照时间倒序显示出来.这个看起来很简单,但要为数以亿计 ...
- 假脱机服务(SPOOLing service)
1. 基本含义 SPOOLing 是 Simultaneous Peripheral(外设) Operation On-Line(联机) 的缩写,是关于慢速字符设备(慢速外设,比如打印机)如何与计算机 ...
- bzoj4977 跳伞求生——贪心
题目:https://www.lydsy.com/JudgeOnline/problem.php?id=4977 今天讲的贪心题,真神奇啊: 首先,要得到尽量多选队友的解: 把队友按 a[i] 从小到 ...
- openStack 主机流量计运行状态 随笔记录
root@ruiy-controller:~# ifconfigeth0 Link encap:Ethernet HWaddr 0c:c4:7a:0d:97:2c ine ...
- openSTack manual 整合调优
- angular的directive指令的link方法
比如 指令标签 <mylink myLoad="try()"></mylink> link:function(scope,element,attr){ el ...
- springboot 的一般配置
import javax.servlet.Filter; import org.springframework.boot.SpringApplication; import org.springfra ...