
Python全栈-magedu-2018-笔记11
第三章 - Python 内置数据结构
简单选择排序
- 简单选择排序
- 属于选择排序
- 两两比较大小,找出极值(极大值或极小值)被放置在固定的位置,这个固定位置一般指的是某一端
- 结果分为升序和降序排列
- 降序
- n个数从左至右,索引从0开始到n-1,两两依次比较,记录大值索引,此轮所有数比较完毕,将大数和索引0数交换,如果大数就是索引1,不交换。第二轮,从1开始比较,找到最大值,将它和索引1位置交换,如果它就在索引1位置则不交换。依次类推,每次左边都会固定下一个大数。
- 升序
- 和降序相反
简单选择排序
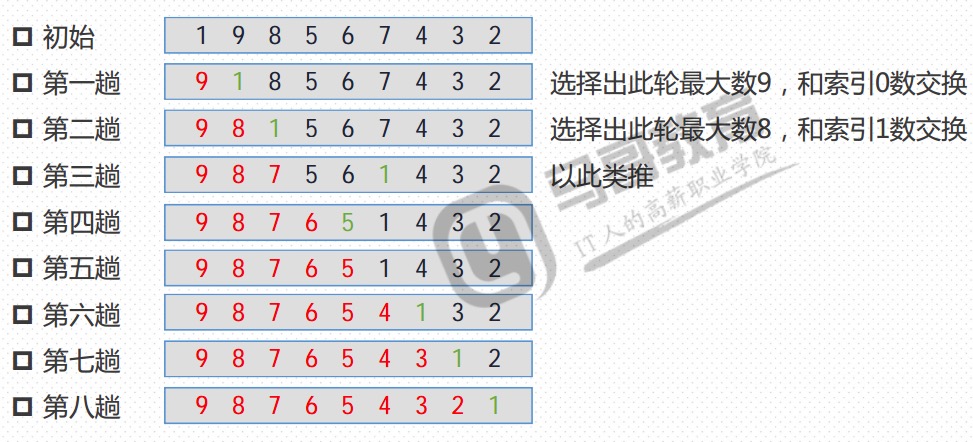
简单选择排序代码实现(一)*
m_list = [
    [1, 9, 8, 5, 6, 7, 4, 3, 2],
    [1, 2, 3, 4, 5, 6, 7, 8, 9],
    [9, 8, 7, 6, 5, 4, 3, 2, 1]
]
nums = m_list[1]
length = len(nums)
print(nums)

count_swap = 0
count_iter = 0

for i in range(length):
    maxindex = i
    for j in range(i + 1, length):
        count_iter += 1
        if nums[maxindex] < nums[j]:
            maxindex = j

    if i != maxindex:
        tmp = nums[i]
        nums[i] = nums[maxindex]
        nums[maxindex] = tmp
        count_swap += 1

print(nums, count_swap, count_iter)
简单选择排序代码实现(二)
- 优化实现
二元选择排序
同时固定左边最大值和右边最小值
优点:
减少迭代元素的次数
1、length//2 整除,通过几次运算就可以发现规律
2、由于使用了负索引,所以条件中要增加
i == length + minindex
还有没有优化的可能?
count_swap = 0
count_iter = 0

# 二元选择排序
for i in range(length // 2):
    maxindex = i
    minindex = -i - 1
    minorigin = minindex
    for j in range(i + 1, length - i): # 每次左右都要少比较一个
    count_iter += 1
    if nums[maxindex] < nums[j]:
        maxindex = j
    if nums[minindex] > nums[-j - 1]:
        minindex = -j - 1
        # print(maxindex, minindex)

    if i != maxindex:
        tmp = nums[i]
        nums[i] = nums[maxindex]
        nums[maxindex] = tmp
        count_swap += 1
        # 如果最小值被交换过,要更新索引
        if i == minindex or i == length + minindex:
            minindex = maxindex
    if minorigin != minindex:
        tmp = nums[minorigin]
        nums[minorigin] = nums[minindex]
        nums[minindex] = tmp
        count_swap += 1

print(nums, count_swap, count_iter)
简单选择排序代码实现(二)
- 改进实现
如果一轮比较后,极大值、极小值的值相等,说明比较的序列元素全部相等
m_list = [
    [1, 9, 8, 5, 6, 7, 4, 3, 2],
    [1, 2, 3, 4, 5, 6, 7, 8, 9],
    [9, 8, 7, 6, 5, 4, 3, 2, 1],
    [1, 1, 1, 1, 1, 1, 1, 1, 1]
]

nums = m_list[3]
length = len(nums)
print(nums)
count_swap = 0
count_iter = 0
# 二元选择排序
for i in range(length // 2):
    maxindex = i
    minindex = -i - 1
    minorigin = minindex
    for j in range(i + 1, length - i): # 每次左右都要少比较一个
    count_iter += 1
    if nums[maxindex] < nums[j]:
        maxindex = j
    if nums[minindex] > nums[-j - 1]:
        minindex = -j - 1
# print(maxindex, minindex)
if nums[maxindex] == nums[minindex]: # 元素全相同
    break
if i != maxindex:
    tmp = nums[i]
    nums[i] = nums[maxindex]
    nums[maxindex] = tmp
    count_swap += 1
    # 如果最小值被交换过,要更新索引
    if i == minindex or i == length + minindex:
        minindex = maxindex
if minorigin != minindex:
    tmp = nums[minorigin]
    nums[minorigin] = nums[minindex]
    nums[minindex] = tmp
    count_swap += 1
print(nums, count_swap, count_iter)
简单选择排序代码实现(二)
- 改进实现
[1, 1, 1, 1, 1, 1, 1, 1, 2] 这种情况,找到的最小值索引是-2,最大值索引8,上面的代码会交换2次,最小值两个1交换是无用功,所以,增加一个判断
m_list = [
    [1, 9, 8, 5, 6, 7, 4, 3, 2],
    [1, 2, 3, 4, 5, 6, 7, 8, 9],
    [9, 8, 7, 6, 5, 4, 3, 2, 1],
    [1, 1, 1, 1, 1, 1, 1, 1, 1],
    [1, 1, 1, 1, 1, 1, 1, 1, 2]
]

nums = m_list[4]
length = len(nums)
print(nums)
count_swap = 0
count_iter = 0
# 二元选择排序
for i in range(length // 2):
    maxindex = i
    minindex = -i - 1
    minorigin = minindex
    for j in range(i + 1, length - i): # 每次左右都要少比较一个
        count_iter += 1
        if nums[maxindex] < nums[j]:
            maxindex = j
        if nums[minindex] > nums[-j - 1]:
            minindex = -j - 1

    print(maxindex, minindex)
    if nums[maxindex] == nums[minindex]: # 元素相同
        break
    if i != maxindex:
        tmp = nums[i]
        nums[i] = nums[maxindex]
        nums[maxindex] = tmp
        count_swap += 1
        # 如果最小值被交换过,要更新索引

        if i == minindex or i == length + minindex:
            minindex = maxindex
    # 最小值索引不同,但值相同就没有必要交换了
    if minorigin != minindex and nums[minorigin] != nums[minindex]:
        tmp = nums[minorigin]
        nums[minorigin] = nums[minindex]
        nums[minindex] = tmp
        count_swap += 1

print(nums, count_swap, count_iter)
简单选择排序总结
- 简单选择排序需要数据一轮轮比较,并在每一轮中发现极值
- 没有办法知道当前轮是否已经达到排序要求,但是可以知道极值是否在目标索引位置上
- 遍历次数1,...,n-1之和n(n-1)/2
- 时间复杂度O(n2)
- 减少了交换次数,提高了效率,性能略好于冒泡法
最后
本文的另外链接是:https://herodanny.github.io/python-magedu-2018-notes11.html
Python全栈-magedu-2018-笔记11的更多相关文章
- 自学Python全栈开发第一次笔记
我已经跟着视频自学好几天Python全栈开发了,今天决定听老师的,开始写blog,听说大神都回来写blog来记录自己的成长. 我特别认真的跟着这个视频来学习,(他们开课前的保证书,我也写 ...
- Python全栈之jQuery笔记
jQuery runnoob网址: http://www.runoob.com/jquery/jquery-tutorial.html jQuery API手册: http://www.runoob. ...
- python全栈开发之OS模块的总结
OS模块 1. os.name() 获取当前的系统 2.os.getcwd #获取当前的工作目录 import os cwd=os.getcwd() # dir=os.listdi ...
- python全栈开发中级班全程笔记(第二模块、第四章(三、re 正则表达式))
python全栈开发笔记第二模块 第四章 :常用模块(第三部分) 一.正则表达式的作用与方法 正则表达式是什么呢?一个问题带来正则表达式的重要性和作用 有一个需求 : 从文件中读取所有联 ...
- 老男孩Python全栈第2期+课件笔记【高清完整92天整套视频教程】
点击了解更多Python课程>>> 老男孩Python全栈第2期+课件笔记[高清完整92天整套视频教程] 课程目录 ├─day01-python 全栈开发-基础篇 │ 01 pyth ...
- python全栈开发中级班全程笔记(第二模块、第四章)(常用模块导入)
python全栈开发笔记第二模块 第四章 :常用模块(第二部分) 一.os 模块的 详解 1.os.getcwd() :得到当前工作目录,即当前python解释器所在目录路径 impor ...
- python全栈开发中级班全程笔记(第二模块、第三章)(员工信息增删改查作业讲解)
python全栈开发中级班全程笔记 第三章:员工信息增删改查作业代码 作业要求: 员工增删改查表用代码实现一个简单的员工信息增删改查表需求: 1.支持模糊查询,(1.find name ,age fo ...
- python 全栈开发,Day43(python全栈11期月考题)
python全栈11期月考题 1.常用字符串格式化有哪些?并说明他们的区别 2.请手写一个单例模式(面试题) 3.利用 python 打印前一天的本地时间,格式为‘2018-01-30’(面试题) 4 ...
- 学习笔记之Python全栈开发/人工智能公开课_腾讯课堂
Python全栈开发/人工智能公开课_腾讯课堂 https://ke.qq.com/course/190378 https://github.com/haoran119/ke.qq.com.pytho ...
- 老男孩最新Python全栈开发视频教程(92天全)重点内容梳理笔记 看完就是全栈开发工程师
为什么要写这个系列博客呢? 说来讽刺,91年生人的我,同龄人大多有一份事业,或者有一个家庭了.而我,念了次985大学,年少轻狂,在大学期间迷信创业,觉得大学里的许多课程如同吃翔一样学了几乎一辈子都用不 ...
随机推荐
- android应用私有存储文件的写入与读取-openFileInput 和 openFileOutput
一:第一种方式就是像Java平台下的实现方式一样通过构造器直接创建,如果需要向打开的文件末尾写入数据,可以通过使用构造器FileOutputStream(File file, boolean appe ...
- Oracle---number数据类型
NUMBER ( precision, scale) precision表示数字中的有效位;如果没有指定precision的话,Oracle将使用38作为精度. 如果scale大于零,表示数字精确 ...
- Odoo 8 Graph 视图 之 雷达图 (Radar\Spider)
据说7.0是有Radar图的,但是8以后被阉割掉了.自己动手 ,丰衣足食. 经过一天的努力,雷达图现已成功加入群共享套餐.
- vuex的理解
首先需要了解vuex的基本概念和使用方式,vue的官网也有很详细的说明或者浏览:https://zhuanlan.zhihu.com/p/24357762. vue是单页应用所以当页面刷新时vuex的 ...
- IDEA - 使用总结
查找 Search Everywhere : Double Shift 本文件查找:Ctrl + f 本项目查找:Ctrl + Shift + f 打开类或方法:Ctrl + B 查找类:Ctrl + ...
- (笔记)Linux内核学习(二)之进程
一 进程与线程 进程就是处于执行期的程序,包含了独立地址空间,多个执行线程等资源. 线程是进程中活动的对象,每个线程都拥有独立的程序计数器.进程栈和一组进程寄存器. 内核调度的对象是线程而不是进程.对 ...
- Swift 中函数使用指南
关于Swift中的各种函数的使用的总结 前言 时间久了,好多东西我们就会慢慢忘记,在这里总结一下Swift中函数的使用原则,把大部分的函数使用技巧用代码示例来做了演示,但是如果想提高,还是要多多思考才 ...
- Spark学习笔记——Spark Streaming
许多应用需要即时处理收到的数据,例如用来实时追踪页面访问统计的应用.训练机器学习模型的应用, 还有自动检测异常的应用.Spark Streaming 是 Spark 为这些应用而设计的模型.它允许用户 ...
- OpenWRT AR9331 mjpg-streamer 网络安装和离线ipk安装
OpenWRT AR9331 固件 我的摄像头ID为: root@Off-1CD0:/# lsusb Bus 001 Device 002: ID 1871:0101 OpenWRT支持的UVV摄像 ...
- mysqldump导出数据时,某些表不导出,排除某些表,不导出某些表
需求说明: 今天一同事问,在通过mysqldump导出数据库的时候,能不能把某些表不导出,或者叫做排除在外呢, 记得应该是可以实现,就搜索了下,通过mysqldump的--ignore-table参数 ...