
【Hive学习之五】Hive 参数&动态分区&分桶
环境
虚拟机:VMware 10
Linux版本:CentOS-6.5-x86_64
客户端:Xshell4
FTP:Xftp4
jdk8
hadoop-3.1.1
apache-hive-3.1.1
一、Hive 参数
1、Hive 参数类型
hive当中的参数、变量,都是以命名空间开头;
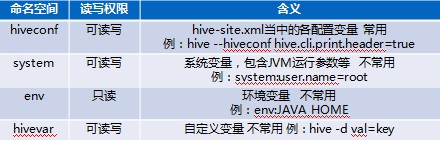
通过${}方式进行引用,其中system、env下的变量必须以前缀开头;
在Hive CLI查看参数
#显示所有参数

hive>set;

#查看单个参数

hive> set hive.cli.print.header;

hive.cli.print.header=false
2、Hive参数设置方式
(1)、修改配置文件 ${HIVE_HOME}/conf/hive-site.xml 这会使所有客户端都生效
(2)、启动hive cli时,通过--hiveconf key=value的方式进行设置 这只会在当前客户端生效
例:
[root@PCS102 ~]# hive --hiveconf hive.cli.print.header=true

hive> set hive.cli.print.header;

hive.cli.print.header=true

hive>
(3)、进入cli之后,通过使用set命令设置 这只会在当前客户端生效
hive> set hive.cli.print.header;

hive.cli.print.header=false

hive> select * from wc;

OK

hadoop

hbase

hello

name

world

zookeeper

Time taken: 2.289 seconds, Fetched:  row(s)

hive> set hive.cli.print.header=true;

hive> set hive.cli.print.header;

hive.cli.print.header=true

hive> select * from wc;

OK

wc.word    wc.totalword

hadoop

hbase

hello

name

world

zookeeper

Time taken: 2.309 seconds, Fetched:  row(s)

hive>
(4)使用.hiverc文件设置
当前用户家目录(例:root用户:家目录是/root)下的.hiverc文件
如果没有,可直接创建该文件,将需要设置的参数写到该文件中,hive启动运行时,会加载改文件中的配置。
[root@PCS102 ~]# vi ~/.hiverc

set hive.cli.print.header=true

:wq
[root@PCS102 ~]# ll -a|grep hive

-rw-r--r--.  root root  Feb  : .hivehistory

-rw-r--r--.  root root  Feb  : .hiverc
另外:
.hivehistory 文件记录hive历史操作命令集
#重新登录 可以发现配置生效了 影响当前linux用户登录的客户端
[root@PCS102 ~]# hive

hive> set hive.cli.print.header;

hive.cli.print.header=true

hive>
二、动态分区
参数设置:
开启支持动态分区
set hive.exec.dynamic.partition=true;
set hive.exec.dynamic.partition.mode=nostrict;
默认:strict(至少有一个分区列是静态分区)
其他参数
set hive.exec.max.dynamic.partitions.pernode;
每一个执行mr节点上,允许创建的动态分区的最大数量(100)
set hive.exec.max.dynamic.partitions;
所有执行mr节点上,允许创建的所有动态分区的最大数量(1000)
set hive.exec.max.created.files;
所有的mr job允许创建的文件的最大数量(100000)
数据 /root/data:
,小明1,,boy,lol-book-movie,beijing:shangxuetang-shanghai:pudong

,小明2,,man,lol-book-movie,beijing:shangxuetang-shanghai:pudong

,小明3,,boy,lol-book-movie,beijing:shangxuetang-shanghai:pudong

,小明4,,man,lol-book-movie,beijing:shangxuetang-shanghai:pudong

,小明5,,boy,lol-book-movie,beijing:shangxuetang-shanghai:pudong

,小明6,,man,lol-book-movie,beijing:shangxuetang-shanghai:pudong
1、原始表
hive> CREATE TABLE psn21(

> id INT,

> name STRING,

> age INT,

> sex string,

> likes ARRAY<STRING>,

> address MAP<STRING,STRING>

> )

> ROW FORMAT DELIMITED

> FIELDS TERMINATED BY ','

> COLLECTION ITEMS TERMINATED BY '-'

> MAP KEYS TERMINATED BY ':'

> LINES TERMINATED BY '\n';

OK

Time taken: 0.183 seconds

hive> LOAD DATA LOCAL INPATH '/root/data' INTO TABLE psn21;

Loading data to table default.psn21

OK

Time taken: 0.248 seconds

hive> select * from psn21;

OK

psn21.id    psn21.name    psn21.age    psn21.sex    psn21.likes    psn21.address

    小明1        boy    ["lol","book","movie"]    {"beijing":"shangxuetang","shanghai":"pudong"}

    小明2        man    ["lol","book","movie"]    {"beijing":"shangxuetang","shanghai":"pudong"}

    小明3        boy    ["lol","book","movie"]    {"beijing":"shangxuetang","shanghai":"pudong"}

    小明4        man    ["lol","book","movie"]    {"beijing":"shangxuetang","shanghai":"pudong"}

    小明5        boy    ["lol","book","movie"]    {"beijing":"shangxuetang","shanghai":"pudong"}

    小明6        man    ["lol","book","movie"]    {"beijing":"shangxuetang","shanghai":"pudong"}

Time taken: 0.113 seconds, Fetched:  row(s)

hive>
2、分区表
hive> CREATE TABLE psn22(

    > id INT,

    > name STRING,

    > likes ARRAY<STRING>,

    > address MAP<STRING,STRING>

    > )

    > partitioned by (age int,sex string)

    > ROW FORMAT DELIMITED

    > FIELDS TERMINATED BY ','

    > COLLECTION ITEMS TERMINATED BY '-'

    > MAP KEYS TERMINATED BY ':'

    > LINES TERMINATED BY '\n';

OK

Time taken: 0.045 seconds
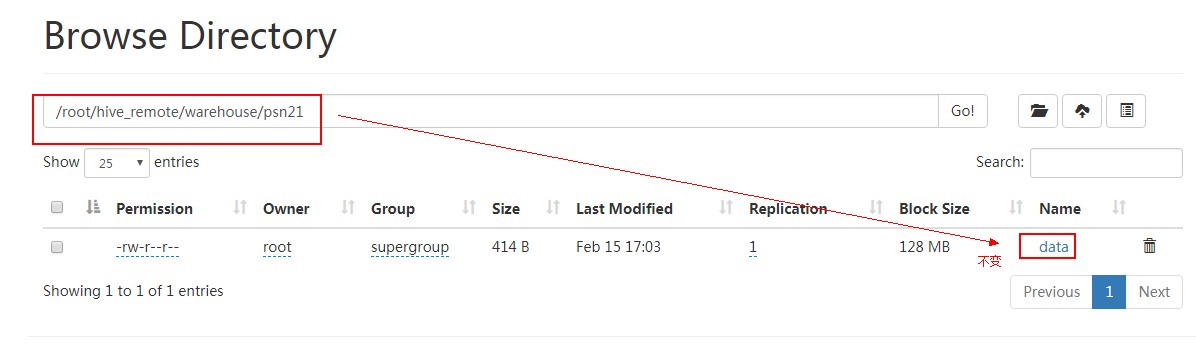
3、原始表数据导入分区表(注意psn21下数据不变)
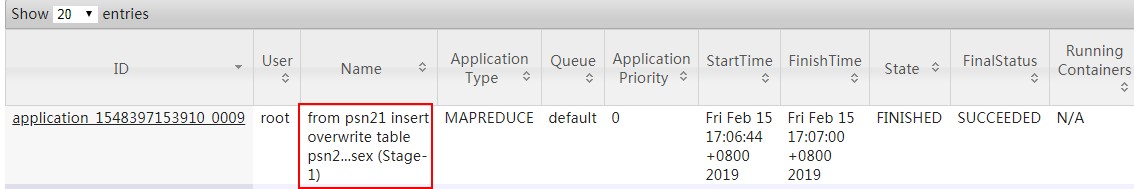
hive> from psn21

    > insert overwrite table psn22 partition(age, sex)

    > select id, name,likes, address,age, sex distribute by age, sex;

Query ID = root_20190215170643_7aeb9dae-62d5-49fe-ab37-022446f6a004

Total jobs =

Launching Job  out of

Number of reduce tasks not specified. Estimated from input data size:

In order to change the average load for a reducer (in bytes):

  set hive.exec.reducers.bytes.per.reducer=<number>

In order to limit the maximum number of reducers:

  set hive.exec.reducers.max=<number>

In order to set a constant number of reducers:

  set mapreduce.job.reduces=<number>

Starting Job = job_1548397153910_0009, Tracking URL = http://PCS102:8088/proxy/application_1548397153910_0009/

Kill Command = /usr/local/hadoop-3.1./bin/mapred job  -kill job_1548397153910_0009

Hadoop job information for Stage-: number of mappers: ; number of reducers:

-- ::, Stage- map = %,  reduce = %

-- ::, Stage- map = %,  reduce = %, Cumulative CPU 2.86 sec

-- ::, Stage- map = %,  reduce = %, Cumulative CPU 6.26 sec

MapReduce Total cumulative CPU time:  seconds  msec

Ended Job = job_1548397153910_0009

Loading data to table default.psn22 partition (age=null, sex=null)

     Time taken to load dynamic partitions: 0.482 seconds

     Time taken for adding to write entity : 0.001 seconds

MapReduce Jobs Launched:

Stage-Stage-: Map:   Reduce:    Cumulative CPU: 6.26 sec   HDFS Read:  HDFS Write:  SUCCESS

Total MapReduce CPU Time Spent:  seconds  msec

OK

id    name    likes    address    age    sex

Time taken: 18.572 seconds

hive>
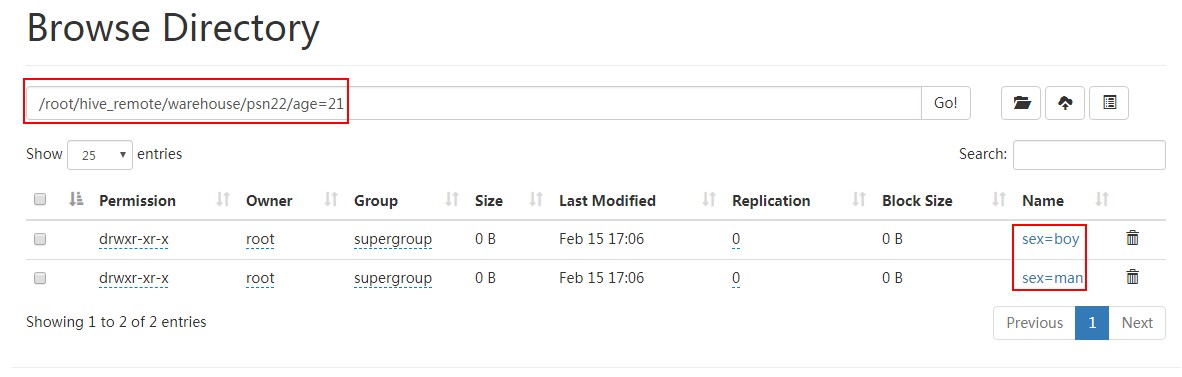

查看该分区下数据:
[root@PCS102 ~]# hdfs dfs -cat /root/hive_remote/warehouse/psn22/age=21/sex=boy/*

5,小明5,lol-book-movie,beijing:shangxuetang-shanghai:pudong

3,小明3,lol-book-movie,beijing:shangxuetang-shanghai:pudong

[root@PCS102 ~]#
全部分区数据:
hive> select * from psn22;

OK

psn22.id    psn22.name    psn22.likes    psn22.address    psn22.age    psn22.sex

    小明1    ["lol","book","movie"]    {"beijing":"shangxuetang","shanghai":"pudong"}        boy

    小明2    ["lol","book","movie"]    {"beijing":"shangxuetang","shanghai":"pudong"}        man

    小明5    ["lol","book","movie"]    {"beijing":"shangxuetang","shanghai":"pudong"}        boy

    小明3    ["lol","book","movie"]    {"beijing":"shangxuetang","shanghai":"pudong"}        boy

    小明6    ["lol","book","movie"]    {"beijing":"shangxuetang","shanghai":"pudong"}        man

    小明4    ["lol","book","movie"]    {"beijing":"shangxuetang","shanghai":"pudong"}        man

Time taken: 0.141 seconds, Fetched:  row(s)

hive>
三、分桶
1、分桶
分桶表是对列值取哈希值的方式,将不同数据放到不同文件中存储。
对于hive中每一个表、分区都可以进一步进行分桶。
由列的哈希值除以桶的个数来决定每条数据划分在哪个桶中。
适用场景:数据抽样( sampling )、map-join
2、开启支持分桶
set hive.enforce.bucketing=true;
默认:false;设置为true之后,mr运行时会根据bucket的个数自动分配reduce task个数。
(用户也可以通过mapred.reduce.tasks自己设置reduce任务个数,但分桶时不推荐使用)
注意:一次作业产生的桶(文件数量)和reduce task个数一致。
3、桶表 抽样查询
select * from bucket_table tablesample(bucket 1 out of 4 on columns);
TABLESAMPLE语法:
TABLESAMPLE(BUCKET x OUT OF y)
x:表示从哪个bucket开始抽取数据
y:必须为该表总bucket数的倍数或因子 (Y表示相隔多少个桶再次抽取)
举例:
当表总bucket数为32时
(1)TABLESAMPLE(BUCKET 2 OUT OF 4),抽取哪些数据?
数据个数:32/4=8份
桶号:2,6(2+4),10(6+4),14(10+4),18(14+4),22(18+4),26(22+4),30(26+4)
(2)TABLESAMPLE(BUCKET 3 OUT OF 8),抽取哪些数据?
数据个数:32/8=4份
桶号:3,11(3+8),19(11+8),27(19+8)
(3)TABLESAMPLE(BUCKET 3 OUT OF 256),抽取哪些数据?
数据个数:32/256=1/8份
桶号:3, 一个桶取1/8即可
4、分桶案例
原始表:
CREATE TABLE psn31

( id INT,

name STRING,

age INT)

ROW FORMAT

DELIMITED FIELDS TERMINATED BY ',';
数据/root/data2:
,tom,11

,cat,

,dog,

,hive,

,hbase,

,mr,

,alice,

,scala,
数据导入:
hive>load data local inpath '/root/data2' into table psn31;
创建分桶表
CREATE TABLE psnbucket

( id INT,

name STRING,

age INT)

CLUSTERED BY (age) INTO  BUCKETS

ROW FORMAT

DELIMITED FIELDS TERMINATED BY ',';
数据分桶预测:
             age%4
1,tom,     --3

,cat,22     --2

,dog,33     --1

,hive,44    --0

,hbase,55   --3

,mr,66      --2

,alice,77   --1

,scala,88   --0
加载数据 执行MR任务 表目录下有四个文件(桶表不能通过load的方式直接加载数据,只能从另一张表中插入数据):
hive>insert into table psnbucket select id, name, age from psn31;

看一下每个桶文件内的数据是否和预测一样:
[root@PCS102 ~]# hdfs dfs -cat /root/hive_remote/warehouse/psnbucket/000000_0

,scala,

,hive,

[root@PCS102 ~]# hdfs dfs -cat /root/hive_remote/warehouse/psnbucket/000001_0

,alice,

,dog,

[root@PCS102 ~]# hdfs dfs -cat /root/hive_remote/warehouse/psnbucket/000002_0

,mr,

,cat,

[root@PCS102 ~]# hdfs dfs -cat /root/hive_remote/warehouse/psnbucket/000003_0

,hbase,

,tom,
数据抽样:结果跟之前版本预期不一样 很奇怪 为什么不是取00001_0里的数据?
hive> select id, name, age from psnbucket tablesample(bucket 2 out of 4 on age);

OK

id    name    age

    mr

    tom

Time taken: 0.184 seconds, Fetched:  row(s)

hive>
【Hive学习之五】Hive 参数&动态分区&分桶的更多相关文章
- Hive学习之修改表、分区、列
Hive学习之修改表.分区.列 https://blog.csdn.net/skywalker_only/article/details/30224309 https://www.cnblogs.co ...
- 对现有Hive的大表进行动态分区
分区是在处理大型事实表时常用的方法.分区的好处在于缩小查询扫描范围,从而提高速度.分区分为两种:静态分区static partition和动态分区dynamic partition.静态分区和动态分区 ...
- Hive Experiment 2(表动态分区和IDE)
1.使用oracle sql developer 4.0.3作为hive query的IDE. 下载hive-jdbc driver http://www.cloudera.com/content/c ...
- Hive学习笔记——Hive中的分桶
对于每一个表(table)或者分区, Hive可以进一步组织成桶,也就是说桶是更为细粒度的数据范围划分.Hive也是针对某一列进行桶的组织.Hive采用对列值哈希,然后除以桶的个数求余的方式决定该条记 ...
- hive学习(二) hive操作
hive ddl 操作官方手册https://cwiki.apache.org/confluence/display/Hive/LanguageManual+DDL hive dml 操作官方手 ...
- hive学习(三) hive的分区
1.Hive 分区partition 必须在表定义时指定对应的partition字段 a.单分区建表语句: create table day_table (id int, content string ...
- Hive学习之五 《Hive进阶—UDF操作案例》 详解
hive—UDF操作 udf的操作过程: 在HIVE会话中add 自定义函数的jar文件,然后创建function,继而使用函数. 下面就以下面课题为例: 课题:统计每个活动的PV和UV 一.Java ...
- hive学习(四) hive的函数
1.内置运算符 1.1关系运算符 运算符 类型 说明 A = B 所有原始类型 如果A与B相等,返回TRUE,否则返回FALSE A == B 无 失败,因为无效的语法. SQL使用”=”,不使用”= ...
- Hive学习:Hive连接JOIN用例详解
1 准备数据: 1.1 t_1 01 张三 02 李四 03 王五 04 马六 05 小七 06 二狗 1.2 t_2 01 11 03 33 04 44 06 66 07 77 08 88 1.3 ...
随机推荐
- jquery 数组的操作
1.数组的创建 var arrayObj = new Array(); //创建一个数组 var arrayObj = new Array([size]); //创建一个数组并指定长度,注意不是上限, ...
- ubuntu编译opencv3.1遇到的问题
网上有很多关于编译的具体步骤,我也是按照网上的说明一步步操作的,这里主要想记录的是在安装完之后,import cv2不存在以及其他的libopencv_hdf.so.3.1等找不到的问题,如果将这样的 ...
- MVC编程模式
MVC编程模式 MVC 是一种使用 MVC(Model View Controller 模型-视图-控制器)设计创建 Web 应用程序的模式: Model(模型)表示应用程序核心(比如数据库记录列表) ...
- CAS 原理
基础模式 1. 访问服务: 客户端发送请求访问应用系统提供的服务资源. 2. 定向认证: 客户端会重定向用户请求到 服务器. 3. 用户认证:用户身份认证. 4. 发放票据: 服务器会产生一个随机 ...
- mysql 数据表操作 目录
mysql 数据表操作 存储引擎介绍 mysql 使用存储引擎 mysql 数据表的增删改查 mysql 数据类型 mysql 约束条件
- [NOSQL] Redis介绍
Redis概述 Redis是Salvatore Sanfilippo在2009年为其初创公司LLOOGG开发的,眼下仍是独立项目.但VMWare赞劣了项目(作者是其雇员).它採用C语言实现.因此性能非 ...
- linux搭建PHP开发环境
因为PHP是一门易于上手的开发语言,所以现在越来越多的初创公司选择PHP作为前期项目的主要开发语言. 工欲善其事,必先利其器! 现在我们就从最基本的环境搭建开始,PHP环境的搭建是非常简单的: 环境: ...
- 20190122 loop
declare a number; v_begin date := to_date('201901013','yyyymmdd'); v_end date := to_date('20190119', ...
- 002-MVC架构,贫血的领域模型、spring mvc,webhars使用
一.MVC.贫血的领域模型 MVC理念是将视图与模型进行解耦. 贫血的领域模型 <领域驱动设计>定义了一组架构规则,能够指导我们更好地将业务领域集成到代码中. 其中一个核心理念是将面向对象 ...
- 转发(forward)和重定向(redirect)
转发和重定向 参考:http://www.2cto.com/kf/201107/97118.html 以前写的一个注册页面: package com.ifly.bbs.controller; impo ...