
ByteHouse+Apache Airflow:高效简化数据管理流程
Apache Airflow 与 ByteHouse 相结合,为管理和执行数据流程提供了强大而高效的解决方案。本文突出了使用 Apache Airflow 与 ByteHouse 的主要优势和特点,展示如何简化数据工作流程并推动业务成功。
主要优势
可扩展可靠的数据流程:Apache Airflow 提供了一个强大的平台,用于设计和编排数据流程,让您轻松处理复杂的工作流程。搭配 ByteHouse,一款云原生的数据仓库解决方案,您可以高效地存储和处理大量数据,确保可扩展性和可靠性。
自动化工作流管理:Airflow 的直观界面通过可视化的 DAG(有向无环图)编辑器,使得创建和调度数据工作流程变得容易。通过与 ByteHouse 集成,您可以自动化提取、转换和加载(ETL)过程,减少手动工作量,实现更高效的数据管理。
简单的部署和管理:Apache Airflow 和 ByteHouse 均设计为简单的部署和管理。Airflow 可以部署在本地或云端,而 ByteHouse 提供完全托管的云原生数据仓库解决方案。这种组合使得数据基础设施的设置和维护变得无缝化。
客户场景
业务场景
在这个客户场景中,一家名为“数据洞察有限公司(假名)”的分析公司,他们将 Apache Airflow 作为数据管道编排工具。他们选择 ByteHouse 作为数据仓库解决方案,以利用其强大的分析和机器学习功能。
数据洞察有限公司在电子商务行业运营,并收集存储在 AWS S3 中的大量客户和交易数据。他们需要定期将这些数据加载到 ByteHouse,并执行各种分析任务,以获得对业务运营的洞察。
数据链路
使用 Apache Airflow,数据洞察有限公司设置了一个基于特定事件或时间表的数据加载管道。例如,他们可以配置 Airflow 在每天的特定时间触发数据加载过程,或者当新的数据文件添加到指定的 AWS S3 存储桶时触发。当触发事件发生时,Airflow 通过从 AWS S3 中检索相关数据文件来启动数据加载过程。它使用适当的凭据和 API 集成确保与 S3 存储桶的安全身份验证和连接。一旦数据从 AWS S3 中获取,Airflow 会协调数据的转换和加载到 ByteHouse 中。它利用 ByteHouse 的集成能力,根据预定义的模式和数据模型高效地存储和组织数据。
成功将数据加载到 ByteHouse 后,数据洞察有限公司可以利用 ByteHouse 的功能进行分析和机器学习任务。他们可以使用 ByteHouse 的类 SQL 语言查询数据,进行复杂的分析,生成报告,并揭示有关客户、销售趋势和产品性能的有意义洞察。
此外,数据洞察有限公司还利用 ByteHouse 的功能创建交互式仪表板和可视化。他们可以构建动态仪表板,显示实时指标,监控关键绩效指标,并与组织中的利益相关者共享可操作的洞察。
最后,数据洞察有限公司利用 ByteHouse 的机器学习功能来开发预测模型、推荐系统或客户细分算法。ByteHouse 提供了必要的计算能力和存储基础设施,用于训练和部署机器学习模型,使数据洞察有限公司能够获得有价值的预测性和规定性洞察。
总结
通过使用 Apache Airflow 作为数据管道编排工具,并将其与 ByteHouse 集成,数据洞察有限公司实现了从 AWS S3 加载数据到 ByteHouse 的流畅自动化流程。他们充分利用 ByteHouse 的强大分析、机器学习和仪表板功能,获得有价值的洞察,并推动组织内的数据驱动。
ByteHouse<>AirFlow 快速入门
先决条件
在您的虚拟/本地环境中安装 pip。在您的虚拟/本地环境中安装 ByteHouse CLI 并登录到 ByteHouse 账户。参考 ByteHouse CLI 以获取安装帮助。macOS 上使用 Homebrew 的示例brew install bytehouse-cli
安装 Apache Airflow
在本教程中,我们使用 pip 在您的本地或虚拟环境中安装 Apache Airflow。了解更多信息,请参阅官方 Airflow 文档。
# airflow需要一个目录,~/airflow是默认目录,

# 但如果您喜欢,可以选择其他位置

#(可选)

export AIRFLOW_HOME=~/airflow

AIRFLOW_VERSION=2.1.3

PYTHON_VERSION="$(python --version | cut -d " " -f 2 | cut -d "." -f 1-2)"

# 例如:3.6

CONSTRAINT_URL="https://raw.githubusercontent.com/apache/airflow/constraints-${AIRFLOW_VERSION}/constraints-${PYTHON_VERSION}.txt"

pip install "apache-airflow==${AIRFLOW_VERSION}" --constraint "${CONSTRAINT_URL}"
如果使用 pip 无法安装,请尝试使用 pip3 install 进行安装。安装完成后,运行命令 airflow info 以获取有关 Airflow 的更多信息。
Airflow 初始化
通过执行以下命令来初始化 Airflow 的 Web 服务器
# 初始化数据库

airflow db init

airflow users create \

--username admin \

--firstname admin \

--lastname admin \

--role Admin \

--email admin

# 启动Web服务器,默认端口是8080

# 或修改airflow.cfg设置web_server_port

airflow webserver --port 8080
设置好 Web 服务器后,您可以访问 http://localhost:8080/使用先前设置的用户名和密码登录 Airflow 控制台。
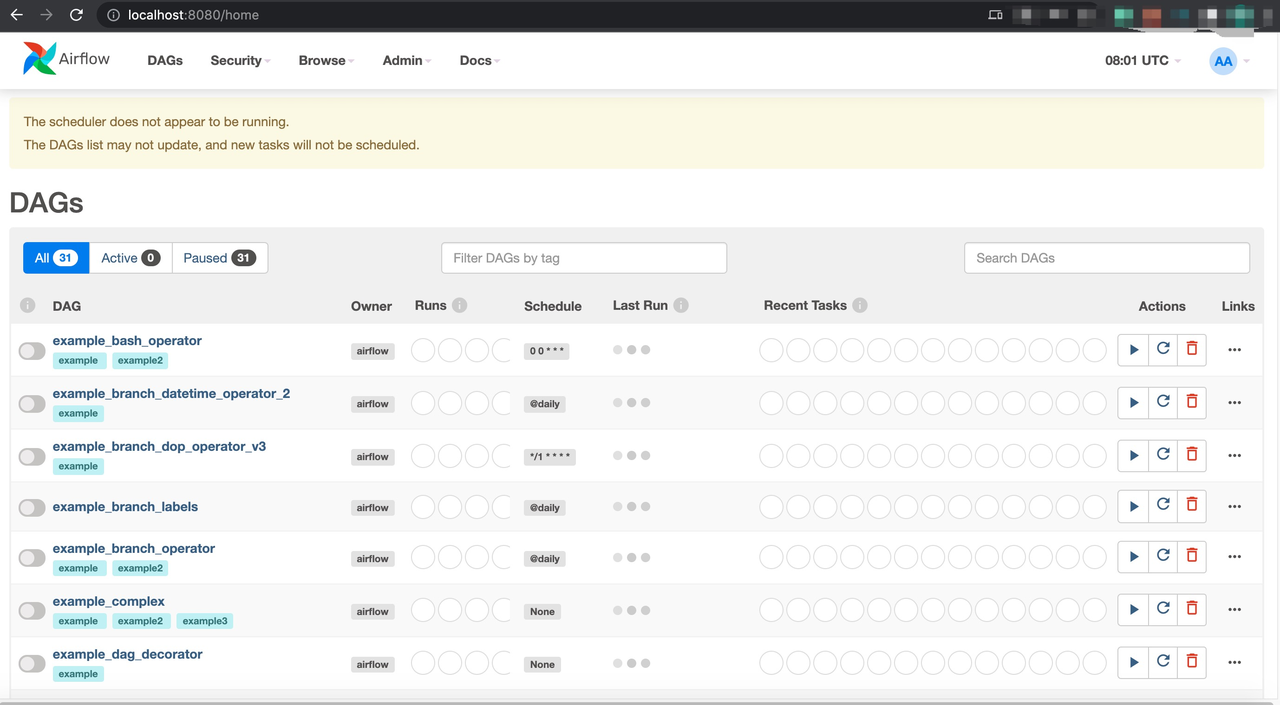
在新的终端中,使用以下命令设置 Airflow 调度器。然后,刷新 http://localhost:8080/。
YAML 配置
使用 cd ~/airflow 命令进入 Airflow 文件夹。打开名为 airflow.cfg 的配置文件。添加配置并连接到数据库。默认情况下,您可以使用 SQLite,但也可以连接到 MySQL。
# 默认情况下是SQLite,也可以连接到MySQL

sql_alchemy_conn = mysql+pymysql://airflow:airflow@xxx.xx.xx.xx:8080/airflow

# authenticate = False

# 禁用Alchemy连接池以防止设置Airflow调度器时出现故障 https://github.com/apache/airflow/issues/10055

sql_alchemy_pool_enabled = False

# 存放Airflow流水线的文件夹,通常是代码库中的子文件夹。该路径必须是绝对路径。

dags_folder = /home/admin/airflow/dags
创建有向无环图(DAG)作业
在 Airflow 路径下创建一个名为 dags 的文件夹,然后创建 test_bytehouse.py 以启动一个新的 DAG 作业。
~/airflow

mkdir dags

cd dags

nano test_bytehouse.py
在 test_bytehouse.py 中添加以下代码。该作业可以连接到 ByteHouse CLI,并使用 BashOperator 运行任务、查询或将数据加载到 ByteHouse 中。
from datetime import timedelta

from textwrap import dedent

from airflow import DAG

from airflow.operators.bash import BashOperator

from airflow.utils.dates import days_ago

default_args = {

    'owner': 'airflow',

    'depends_on_past': False,

    'email': ['airflow@example.com'],

    'email_on_failure': False,

    'email_on_retry': False,

    'retries': 1,

    'retry_delay': timedelta(minutes=5),

}

with DAG(

    'test_bytehouse',

    default_args=default_args,

    description='A simple tutorial DAG',

    schedule_interval=timedelta(days=1),

    start_date=days_ago(1),

    tags=['example'],

) as dag:

    tImport  = BashOperator(

        task_id='ch_import',

        depends_on_past=False,

        bash_command='$Bytehouse_HOME/bytehouse-cli -cf /root/bytehouse-cli/conf.toml "INSERT INTO korver.cell_towers_1 FORMAT csv INFILE \'/opt/bytehousecli/data.csv\' "',

    )

    tSelect  = BashOperator(

        task_id='ch_select',

        depends_on_past=False,

        bash_command='$Bytehouse_HOME/bytehouse-cli -cf /root/bytehouse-cli/conf.toml -q "select * from korver.cell_towers_1 limit 10 into outfile \'/opt/bytehousecli/dataout.csv\' format csv "'

    )

    tSelect >> tImport
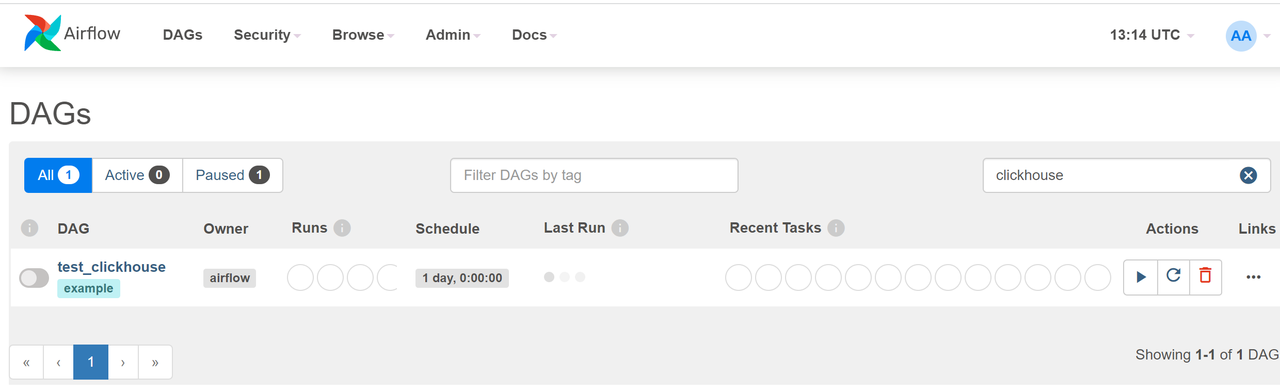
在当前文件路径下运行 python test_bytehouse.py 以在 Airflow 中创建 DAG。在浏览器中刷新网页。您可以在 DAG 列表中看到新创建的名为 test_bytehouse 的 DAG。
执行 DAG
在终端中运行以下 Airflow 命令来查看 DAG 列表和 test_bytehouse DAG 中的子任务。您可以分别测试查询执行和数据导入任务。
#打印"test_bytehouse" DAG中的任务列表

[root@VM-64-47-centos dags]# airflow tasks list test_bytehouse

ch_import

ch_select

#打印"test_bytehouse" DAG中任务的层次结构

[root@VM-64-47-centos dags]# airflow tasks list test_bytehouse --tree

<Task(BashOperator): ch_select>

<Task(BashOperator): ch_import>
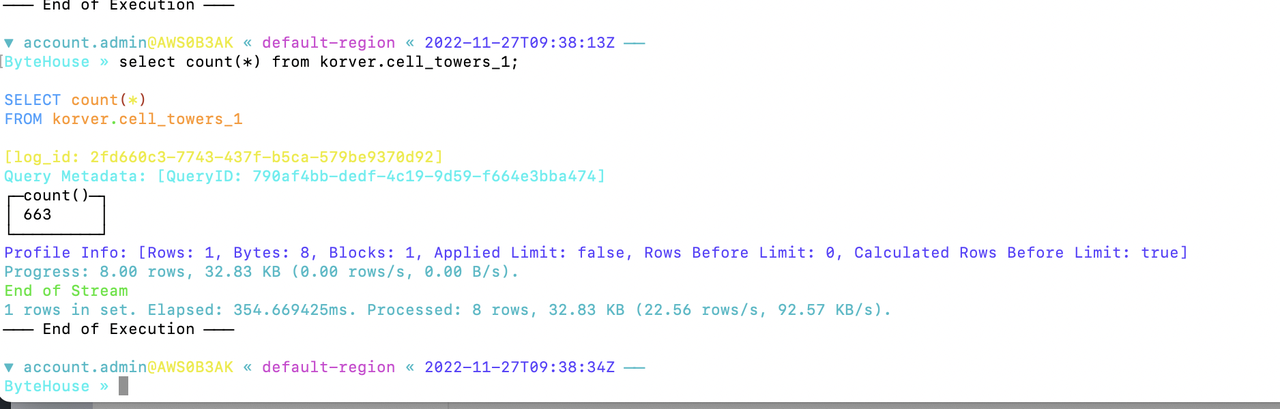
运行完 DAG 后,查看您的 ByteHouse 账户中的查询历史页面和数据库模块。您应该能够看到查询/加载数据成功执行的结果。
ByteHouse+Apache Airflow:高效简化数据管理流程的更多相关文章
- 任务调度工具 Apache Airflow 初识
参考文章: Apache Airflow (incubating) Documentation — Airflow ... 任务调度神器 airflow 之初体验 airflow 介绍 - 简书(原文 ...
- Nginx为什么比Apache Httpd高效
转载于:http://www.toxingwang.com/linux-unix/linux-basic/1712.html 一.进程.线程? 在回答nginx 为什么比apache更高效之前,必须要 ...
- SpringCloud+Eureka+Feign+Ribbon的简化搭建流程,加入熔断,网关和Redis缓存[2]
目录 前提:本篇是基于 SpringCloud+Eureka+Feign+Ribbon的简化搭建流程和CRUD练习[1] 的修改与拓展 1.修改consumer的CenterFeign.java,把返 ...
- 在 Docker 上快速运行 Apache Airflow 2.2.4
Docker 安装 Apache Airflow 参考资料 Running Airflow in Docker 安装依赖 Docker Engine Docker Composite 快速运行 Apa ...
- Nginx为什么比Apache Httpd高效:原理篇
一.进程.线程? 进程是具有一定独立功能的,在计算机中已经运行的程序的实体.在早期系统中(如linux 2.4以前),进程是基本运作单位,在支持线程的系统中(如windows,linux2.6)中,线 ...
- apache airflow docker 运行简单试用
airflow 是一个编排.调度和监控workflow的平台,由Airbnb开源,现在在Apache Software Foundation 孵化. airflow 将workflow编排为tasks ...
- DolphinDB +Python Airflow 高效实现数据清洗
DolphinDB 作为一款高性能时序数据库,其在实际生产环境中常有数据的清洗.装换以及加载等需求,而对于该如何结构化管理好 ETL 作业,Airflow 提供了一种很好的思路.本篇教程为生产环境中 ...
- apache本地服务器的配置流程
安装Apache 一.目的: 1. 能够有一个测试的服务器,不是所有的特殊网络服务都能找到免费的! 二.为什么是 "Apache" 1. 使用最广的 Web 服务器 2. Mac自 ...
- SpringCloud+Eureka+Feign+Ribbon的简化搭建流程和CRUD练习
作者:个人微信公众号:程序猿的月光宝盒 环境:win10--idea2019--jdk8 1.搭建Eureka服务模块 1.1 新建eureka服务模块(Sping Initializr) 取名为eu ...
- SpringCloud+Eureka+Feign+Ribbon+zuul的简化搭建流程和CRUD练习
环境:win10--idea2019--jdk8 1.搭建Eureka服务模块 1.1 新建eureka服务模块(Sping Initializr) 取名为eureka-server,并添加如下Dep ...
随机推荐
- mysql 数据库索引在什么场景下会失效?实战篇
CREATE TABLE `user` ( `id` int NOT NULL AUTO_INCREMENT, `code` varchar(20) COLLATE utf8mb4_bin DEFAU ...
- [C++]P3384 轻重链剖分(树链剖分)
[C++]树链剖分 预备知识 树的基础知识 关于这个本文有介绍 邻接表存图 线段树基础 会区间加法和区间结合就可以了P3372 建议阅读这篇Blog 最近公共祖先LCA 虽然用不到这个思想 但是有类似 ...
- .Net8 Blazor 尝鲜
全栈 Web UI 随着 .NET 8 的发布,Blazor 已成为全堆栈 Web UI 框架,可用于开发在组件或页面级别呈现内容的应用,其中包含: 用于生成静态 HTML 的静态服务器呈现. 使用 ...
- freeRTOS 学习
一.任务状态 任务状态可以分成 Running 和Not Running: 但实际的Not Running状态还有许多的其他状态作为细分. 包括挂起,阻塞和就绪态 挂起状态表示该任务虽然已经创建但是在 ...
- PTA作业4、5、6及期中考试的总结
一.前言 本次博客是针对面向对象程序设计课程布置的PTA第4.5.6次作业以及期中考试的编程题而写的总结分析,重点分析了菜单计价系列题目.期中考试的编程题等具有一定难度和特色的问题. 二.PTA第四次 ...
- 【Codeforces Global Round 12】 C2 - Errich-Tac-Toe题解(思维)
题面 题目要求不能有有三个连续相同的'X'或'O',注意到这样的连续串它们的横纵坐标之和是连续变化的,考虑将它们按照横纵坐标之和对 \(3\)的模值分组,因为这样分组后相邻的三个相同字符就被分到了三个 ...
- 架构师的知行合一(内容由AI的全文生成,满分100分我打99分)
大型架构是怎么来的 随着科技的不断发展,越来越多的企业和组织开始意识到数字化转型的重要性.为了更好地适应市场的变化,满足客户的需求,提高企业的竞争力,大型架构成为了企业和组织不可或缺的一部分.那么,大 ...
- Nacos 配置中心源码
客户端 入口 在引入配置中心 maven 依赖的 jar 文件中找到 spring-cloud-starter-alibaba-nacos-config-2.2.5.RELEASE.jar!/META ...
- [Ynoi2002] Goedel Machine
题目描述 由于你不会设计哥德尔机,所以你决定先做一道数据结构题: 给定一个长度为 \(n\) 的序列 \(a_1\cdots a_n\).你需要回答 \(m\) 个询问,第 \(i\) 个询问给定一个 ...
- idea的maven
在我学习springMvc时一直报一个错,后来发现是maven一直出错导致的 这个maven是idea系统自己的maven,用着用着发现依赖项不见了,怎么导入坐标都导不进去,导致在创建maven项目时 ...