
深入浅出Sqoop之迁移过程源码分析
Sqoop作业执行过程
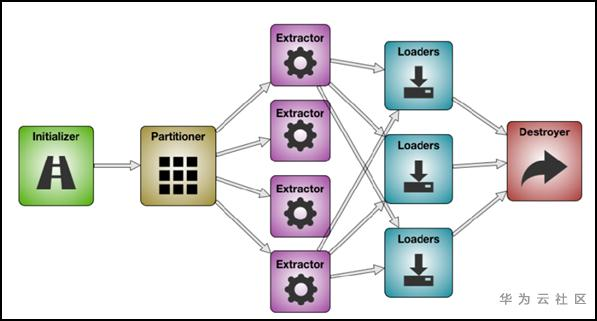
- Initializer:初始化阶段,源数据校验,参数初始化等工作;
- Partitioner:源数据分片,根据作业并发数来决定源数据要切分多少片;
- Extractor:开启extractor线程,根据用户配置从内存中构造数据写入队列;
- Loader:开启loader线程,从队列中读取数据并抛出;
- Destroyer:资源回收,断开sqoop与数据源的连接,并释放资源;
Initializer
public abstract void initialize(InitializerContext context, LinkConfiguration linkConfiguration,JobConfiguration jobConfiguration); public List<String> getJars(InitializerContext context, LinkConfiguration linkConfiguration,JobConfiguration jobConfiguration){ return new LinkedList<String>(); } public abstract Schema getSchema(InitializerContext context, LinkConfiguration linkConfiguration,JobConfiguration jobConfiguration) { return new NullSchema(); }
Destroyer
public abstract void destroy(DestroyerContext context, LinkConfiguration linkConfiguration,JobConfiguration jobConfiguration);
Partitioner
public abstract List<Partition> getPartitions(PartitionerContext context, LinkConfiguration linkConfiguration, FromJobConfiguration jobConfiguration);
Extractor
while (resultSet.next()) { ... context.getDataWriter().writeArrayRecord(array); ... }
Loader
public abstract void load(LoaderContext context, ConnectionConfiguration connectionConfiguration, JobConfiguration jobConfiguration) throws Exception;

load方法从SqoopOutputFormatDataReader中读取,它读取“中间数据格式表示形式” _中的数据并将其加载到数据源。此外Loader必须迭代的调用DataReader()直到它读完。

while ((array = context.getDataReader().readArrayRecord()) != null) { ... }
MapReduce执行过程
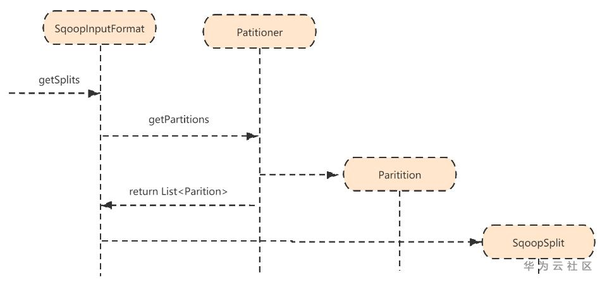
- SqoopInputFormat的getSplits方法会调用Partitioner类的getPartitions方法
- 将返回的Partition列表包装到SqoopSplit中;
- 默认分片个数为10
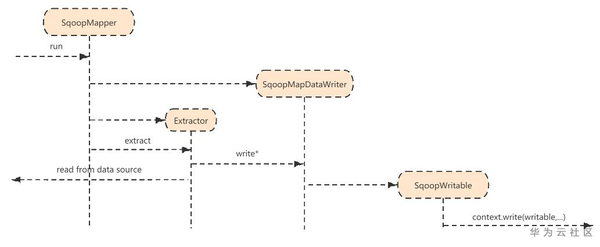
- SqoopMapper包含了一个SqoopMapDataWriter类,
- Mapper的run()调用Extractor.extract方法,该方法迭代的获取源端数据再调用DataWriter写入Context中
private Class SqoopMapDataWriter extends DataWriter { ... private void writeContent() { ... context.wirte(writable, NullWritable.get()); // 这里的writable 是SqoopWritable的一个对象 ... } ... }
- SqoopOutputFormatLoadExecutor包装了SqoopOuputFormatDataReader,SqoopRecordWriter, ConsumerThread三个内部类;
- SqoopNullOutputFormat调用getRecordWriter时创建一个线程:ConsumerThread,代码如下
- ConsumerThread集成了Runnable接口,线程内部调用Loader.load(...)方法,该方法用DataReader迭代的从Context中读取出SqoopWritable,并将其写入一个中间数据格式再写入目的端数据库中。
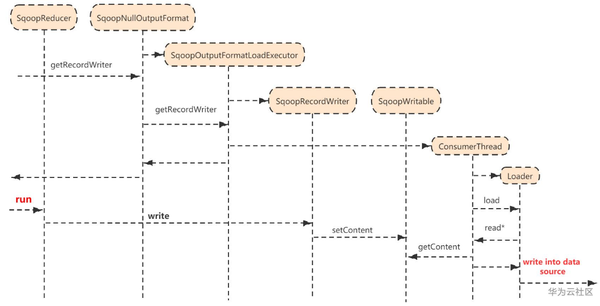
- 再本地模式下,Sqoop提交任务时没有设置SqoopReducer.class,MR会调用一个默认的reducer.class。
- setContent就是SqoopRecordWriter.write(...),它将SqoopWritable反序列化后存入中间存储格式中,即IntermediateDataFormat。与之对应,getContent就是从该中间存储格式中读取数据。
- Sqoop定义了一个可插拔的中间数据格式抽象类,IntermediateDataFormat类,SqoopWritable打包了这个抽象类用来保存中间数据。
深入浅出Sqoop之迁移过程源码分析的更多相关文章
- 大数据之Oozie——源码分析(一)程序入口
工作中发现在oozie中使用sqoop与在shell中直接调度sqoop性能上有很大的差异.为了更深入的探索其中的缘由,开始了oozie的源码分析之路.今天第一天阅读源码,由于没有编译成功,不能运行测 ...
- Sqoop-1.4.6 Merge源码分析与改造使其支持多个merge-key
Sqoop中提供了一个用于合并数据集的工具sqoop-merge.官方文档中的描述可以参考我的另一篇博客Sqoop-1.4.5用户手册. Merge的基本原理是,需要指定新数据集和老数据集的路径,根据 ...
- [Abp vNext 源码分析] - 文章目录
一.简要介绍 ABP vNext 是 ABP 框架作者所发起的新项目,截止目前 (2019 年 2 月 18 日) 已经拥有 1400 多个 Star,最新版本号为 v 0.16.0 ,但还属于预览版 ...
- linux内存源码分析 - 内存压缩(同步关系)
本文为原创,转载请注明:http://www.cnblogs.com/tolimit/ 概述 最近在看内存回收,内存回收在进行同步的一些情况非常复杂,然后就想,不会内存压缩的页面迁移过程中的同步关系也 ...
- 【转】HashMap实现原理及源码分析
哈希表(hash table)也叫散列表,是一种非常重要的数据结构,应用场景极其丰富,许多缓存技术(比如memcached)的核心其实就是在内存中维护一张大的哈希表,而HashMap的实现原理也常常出 ...
- Spring IOC 容器源码分析系列文章导读
1. 简介 Spring 是一个轻量级的企业级应用开发框架,于 2004 年由 Rod Johnson 发布了 1.0 版本.经过十几年的迭代,现在的 Spring 框架已经非常成熟了.Spring ...
- [阿里DIEN] 深度兴趣进化网络源码分析 之 Keras版本
[阿里DIEN] 深度兴趣进化网络源码分析 之 Keras版本 目录 [阿里DIEN] 深度兴趣进化网络源码分析 之 Keras版本 0x00 摘要 0x01 背景 1.1 代码进化 1.2 Deep ...
- mongodb 数据块迁移的源码分析
1. 简介 上一篇我们聊到了mongodb数据块的基本概念,和数据块迁移的主要流程,这篇文章我们聊聊源码实现部分. 2. 迁移序列图 数据块迁移的请求是从配置服务器(config server)发给( ...
- JUC源码学习笔记8——ConcurrentHashMap源码分析1 如何实现低粒度锁的插入,如何实现统计元素个数,如何实现并发扩容迁移
源码基于jdk1.8 这一片主要讲述ConcurrentHashMap如何实现低粒度锁的插入,如何实现统计元素个数,如何实现并发扩容迁移 系列文章目录和关于我 一丶ConcurrentHashMap概 ...
- ABP源码分析一:整体项目结构及目录
ABP是一套非常优秀的web应用程序架构,适合用来搭建集中式架构的web应用程序. 整个Abp的Infrastructure是以Abp这个package为核心模块(core)+15个模块(module ...
随机推荐
- 软件开发人员 Kubernetes 入门指南|Part 1
Kubernetes 是一个用于部署和管理容器的编排系统.使用 Kubernetes,用户可以通过自动执行管理任务(例如在跨节点间扩展容器并在容器停止时重新启动任务),在不同环境中可靠地运行容器. K ...
- Windows 95 的辉煌诞生历史
1992 年 2 月,Windows 3.1 的研发即将结束,而 Windows 团队正忙得不亦乐乎地计划他们的下一盘大棋.到了 3 月 5 日,他们终于悠哉悠哉地敲定了战略大计:横扫桌面.笔记本.移 ...
- Molecule 在构建工具中的选择
我们是袋鼠云数栈 UED 团队,致力于打造优秀的一站式数据中台产品.我们始终保持工匠精神,探索前端道路,为社区积累并传播经验价值. 本文作者:修能 朝闻道,夕死可矣 何为 Molecule? 轻量级的 ...
- CSS display属性的作用
作者:WangMin 格言:努力做好自己喜欢的每一件事 网页上的每个元素都是一个矩形框.CSS中的display属性决定了矩形框的行为.display属性是我们在前端开发中常常使用的一个属性. dis ...
- CoreFX中Dictionary<TKey, TValue>的源码解读
无论是实际的项目中,还是在我们学习的过程中,都会重点的应用到Dictionary<TKey, TValue>这个存储类型.每次对Dictionary<TKey, TValue> ...
- 递归与分治思想:汉诺塔(递归 && 分治思想)
1 //64个盘子 2 //划分成小问题:1.将上面的63个盘子从x借助z移动到y上 3 2.将第64个盘子从x移动到z上 4 3.将y上的63个盘子借助x移动到z上 5 详解:https://www ...
- 最小生成树(Prim、Kruskal)
MST 引入 现在有一个连通图,他有\(N\)个节点,\(M\)条边 当我们砍掉一些边时,它会变成一棵树,其剩下的边权之和即为这棵树的权,当剩下的权值最小时,称这棵树为此图的最小生成树,即MST 模版 ...
- 浅析MySQL代价模型:告别盲目使用EXPLAIN,提前预知索引优化策略
背景 在 MySQL 中,当我们为表创建了一个或多个索引后,通常需要在索引定义完成后,根据具体的数据情况执行 EXPLAIN 命令,才能观察到数据库实际使用哪个索引.是否使用索引.这使得我们在添加新索 ...
- c# 高并发必备技巧(三)
前面两篇文章主要是介绍了如何解决高并发情况下资源争夺的问题.但是现实的应用场景中除了要解决资源争夺问题,高并发的情况还需要解决更多问题,比如快速处理业务数据等, 本篇文章简要罗列一下与之相关的更多技术 ...
- MVC:开发模式
1.jsp演变历史 1.早期只有servlet,只能使用response输出标签数据,非常麻烦. 2.后来有了jsp,简化了Servlet的开发,如果过度使用jsp中即写大量的Ja ...