
Decision Tree Algorithm
Decision Tree算法的思路是,将原始问题不断递归地细分为子问题,直到子问题直接可获得答案为止。在模型训练的过程中,根据训练集去做树的生长(Grow the tree),生长所有可能的Branches,最终达到叶子节点(leaf nodes)。在预测过程中,则遍历树枝,去寻找和预测目标最相近的叶子。
构建决策树模型:
而在构建过程中的主要问题是,选择数据集的哪个feature来做分割。这里用到了Greedy Search。形象地说,每走一步,都选择当前情况下最好的路径,而不管下一步如何或几步之后如何。那么,定义什么是“最好”,有三个标准:ID3,C4.5和Gini index。
ID3:计算信息增益(Information Gain),即分割前后熵值的差,差值越大,则我们在分割过程中,获得的信息量就越大:
Entropy of the target datase:
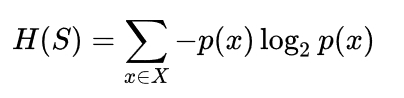
Information Gain by a split:

C4.5:和ID3相似,但采取的是信息增益率(Information Gain Ratio),避免了通过将数据集分割为无限多个从而获得最大信息增益的极限情况:
切割信息量(feature_A将集合S分割为若干个sj):
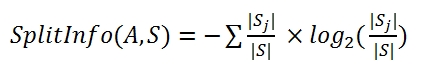
信息增益率=信息增益/切割信息量
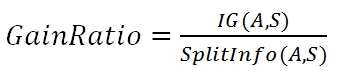
在ID3和C4.5算法中,构建树时需要选择Information Gain或Gain Ratio最大的feature.
CART:与前面两种算法不同,CART计算的是Gini系数。Gini如果为0,说明集合纯净,Gini大则说明集合离散度高。所以我们选择,使Gini系数最小的feature来生成枝叶。同时,在算法比较中,Gini算法没有logrithm的存在,计算速度会更快:
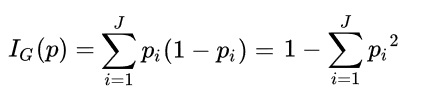
选择ID3, C4.5和CART中的一个标准来递归的生成树,即可完成建模。
利用决策树做预测:
在预测时,根据target example的feature取值,在现有决策树的枝叶路径中搜寻最匹配的路径。如果存在相同的路径,perfect!直接找出输出值。如果不存在,卡在了某个分叉路口,那么就对该分岔路口下的所有节点进行投票,来取得最大可能性的输出值。
问题思考:
如果我的Training Set足够大,同时其多样性也足够,那么在训练过程中生成的决策树就会枝叶茂盛、十分复杂。同时带来的问题就是,过于细枝末节的决策树,会完美拟合训练集,但对于测试集的预测会大打折扣。这是典型的Overfitting,这时就要对决策树进行修剪,具体原理请见下篇博文。
Decision Tree Algorithm的更多相关文章
- 机器学习技法:09 Decision Tree
Roadmap Decision Tree Hypothesis Decision Tree Algorithm Decision Tree Heuristics in C&RT Decisi ...
- 机器学习技法笔记:09 Decision Tree
Roadmap Decision Tree Hypothesis Decision Tree Algorithm Decision Tree Heuristics in C&RT Decisi ...
- Decision Tree
Decision Tree builds classification or regression models in the form of a tree structure. It break d ...
- Spark MLlib - Decision Tree源码分析
http://spark.apache.org/docs/latest/mllib-decision-tree.html 以决策树作为开始,因为简单,而且也比较容易用到,当前的boosting或ran ...
- Sklearn库例子1:Sklearn库中AdaBoost和Decision Tree运行结果的比较
DisCrete Versus Real AdaBoost 关于Discrete 和Real AdaBoost 可以参考博客:http://www.cnblogs.com/jcchen1987/p/4 ...
- OpenCV码源笔记——Decision Tree决策树
来自OpenCV2.3.1 sample/c/mushroom.cpp 1.首先读入agaricus-lepiota.data的训练样本. 样本中第一项是e或p代表有毒或无毒的标志位:其他是特征,可以 ...
- (转)Decision Tree
Decision Tree:Analysis 大家有没有玩过猜猜看(Twenty Questions)的游戏?我在心里想一件物体,你可以用一些问题来确定我心里想的这个物体:如是不是植物?是否会飞?能游 ...
- CART分类与回归树与GBDT(Gradient Boost Decision Tree)
一.CART分类与回归树 资料转载: http://dataunion.org/5771.html Classification And Regression Tree(CART)是决策 ...
- [ML学习笔记] 决策树与随机森林(Decision Tree&Random Forest)
[ML学习笔记] 决策树与随机森林(Decision Tree&Random Forest) 决策树 决策树算法以树状结构表示数据分类的结果.每个决策点实现一个具有离散输出的测试函数,记为分支 ...
随机推荐
- WOJ#2423 安全出行Safe Travel
描述 精灵最近在农场上泛滥,它们经常会阻止牛们从农庄(牛棚_1)走到别的牛棚(牛_i的目的 地是牛棚_i).每一个精灵只认识牛_i并且知道牛_i一般走到牛棚_i的最短路经.所以它们在牛_i到牛棚_i之 ...
- 深入ArrayList看fast-fail机制
fail-fast机制简介 什么是fail-fast fail-fast 机制是java集合(Collection)中的一种错误机制.它只能被用来检测错误,因为JDK并不保证fail-fast机制一定 ...
- Django - Xadmin (三) 分页、搜索和批量操作
Django - Xadmin (三) 分页.搜索和批量操作 分页和 ShowList 类 因为 list_view 视图函数里面代码太多,太乱,所以将其里面的用于处理表头.处理表单数据的关键代码提取 ...
- Angular.js 使用获取验证码按钮实现-倒计时
获取验证码界面效果如图: 需要实现以下逻辑 按钮不可选 --输入电话号码,按钮可选 --点击获取,进入倒计时,按钮不可选 --倒计时结束,回到初识状态 核心代码: var cd = 60; var t ...
- Vue简单封装axios—解决post请求后端接收不到参数问题
1.在src/下新建api文件夹,api/下新建index.js和public.js 在public.js中: import axios from 'axios'; import qs from 'q ...
- 在Eclipse-jee-neon中配置springsource-tool-suite
今天为大家展示如何在Eclipse-jee-neon中配置spring的插件(springsource-tool-suit): 打开Eclipse,查看自己的版本. Help –> About ...
- 行人重识别(ReID) ——数据集描述 DukeMTMC-reID
数据集简介 DukeMTMC 数据集是一个大规模标记的多目标多摄像机行人跟踪数据集.它提供了一个由 8 个同步摄像机记录的新型大型高清视频数据集,具有 7,000 多个单摄像机轨迹和超过 2,700 ...
- 初步理解React
1.组件化 在 MV* 架构出现之前,组件主要分为两种: 狭义上的组件,又称为 UI 组件,比如 Tabs 组件.Dropdown 组件.组件主要围绕在交互 动作上的抽象,针对这些交互动作,利用 Ja ...
- openstack stein部署手册 3. keystone
# 建立数据库用户及权限 create database keystone; grant all privileges on keystone.* to keystone@'localhost' id ...
- 封装操作mysql、redis
封装操作mysql: import pymysql class MyDb: def __init__(self,host,password,user,db,port=3306,charset='utf ...