
kafka_2.11-2.0.0_介绍
1. JMS是什么
1.1. JMS的基础
JMS是什么:JMS是Java提供的一套技术规范
JMS干什么用:用来异构系统 集成通信,缓解系统瓶颈,提高系统的伸缩性增强系统用户体验,使得系统模块化和组件化变得可行并更加灵活
通过什么方式:生产消费者模式(生产者、服务器、消费者)
1.2. JMS消息传输模型
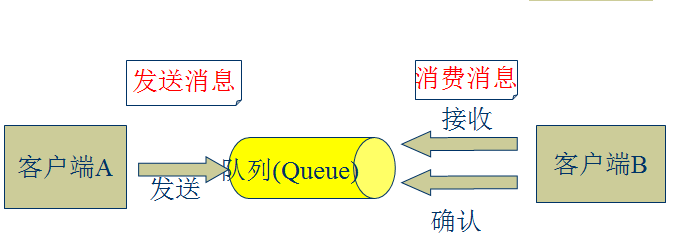
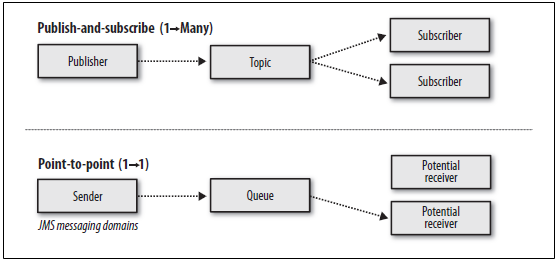
- 点对点模式(一对一,消费者主动拉取数据,消息收到后消息清除)
点对点模型通常是一个基于拉取或者轮询的消息传送模型,这种模型从队列中请求信息,而不是将消息推送到客户端。这个模型的特点是发送到队列的消息被一个且只有一个接收者接收处理,即使有多个消息监听者也是如此。
- 发布/订阅模式(一对多,数据生产后,推送给所有订阅者)
发布订阅模型则是一个基于推送的消息传送模型。发布订阅模型可以有多种不同的订阅者,临时订阅者只在主动监听主题时才接收消息,而持久订阅者则监听主题的所有消息,即时当前订阅者不可用,处于离线状态。
queue.put(object) 数据生产
queue.take(object) 数据消费
1.3. JMS核心组件
- Destination:消息发送的目的地,也就是前面说的Queue和Topic。
- Message :从字面上就可以看出是被发送的消息。
- Producer:消息的生产者,要发送一个消息,必须通过这个生产者来发送。
- MessageConsumer: 与生产者相对应,这是消息的消费者或接收者,通过它来接收一个消息。
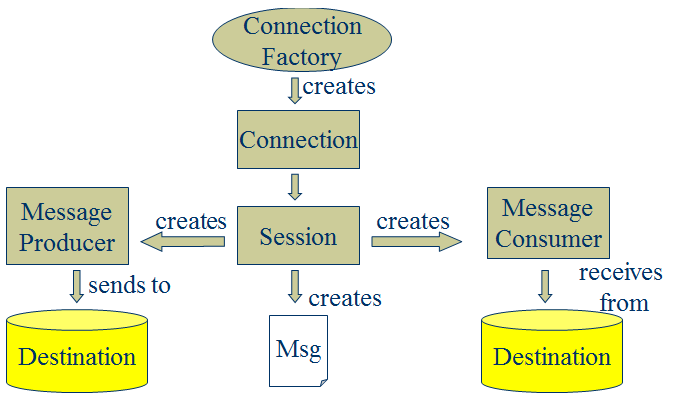
通过与ConnectionFactory可以获得一个connection
通过connection可以获得一个session会话。
2. Kafka是什么
- Apache Kafka是一个开源消息系统,由Scala写成。是由Apache软件基金会开发的一个开源消息系统项目。
- Kafka最初是由LinkedIn开发,并于2011年初开源。2012年10月从Apache Incubator毕业。该项目的目标是为处理实时数据提供一个统一、高通量、低等待的平台。
- Kafka是一个分布式消息队列:生产者、消费者的功能。它提供了类似于JMS的特性,但是在设计实现上完全不同,此外它并不是JMS规范的实现。
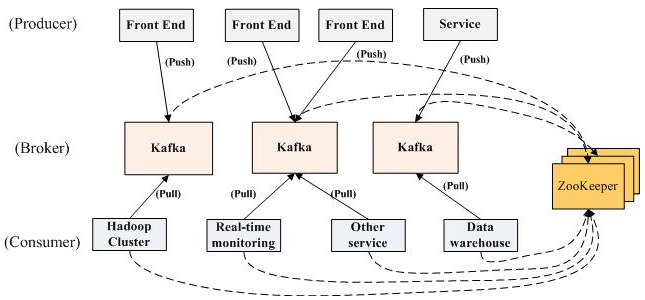
- Kafka对消息保存时根据Topic进行归类,发送消息者称为Producer,消息接受者称为Consumer,此外kafka集群有多个kafka实例组成,每个实例(server)成为broker。
- 无论是kafka集群,还是producer和consumer都依赖于zookeeper集群保存一些meta信息,来保证系统可用性
3. Kafka的架构
4. kafka名词解释
- Topic:用于划分Message的逻辑概念,一个Topic可以分布在多个Broker上。可以理解为一个队列。
- Partition:是Kafka中横向扩展和一切并行化的基础,每个Topic都至少被切分为1个Partition,每个partition是一个有序的队列。partition中的每条消息都会被分配一个有序的id(offset)。kafka只保证按一个partition中的顺序将消息发给consumer,不保证一个topic的整体(多个partition间)的顺序。
- Offset:消息在Partition中的编号,编号顺序不跨Partition。kafka的存储文件都是按照offset.kafka来命名,用offset做名字的好处是方便查找。例如你想找位于2049的位置,只要找到2048.kafka的文件即可。当然the first offset就是00000000000.kafka
- Producer:用于往Broker中发送/生产Message。
- Consumer:用于从Broker中取出/消费Message。
- Replication:Kafka支持以Partition为单位对Message进行冗余备份,每个Partition都可以配置至少1个Replication(当仅1个Replication时即仅该Partition本身)。
- Leader:每个Replication集合中的Partition都会选出一个唯一的Leader,所有的读写请求都由Leader处理。其他Replicas从Leader处把数据更新同步到本地,过程类似大家熟悉的MySQL中的Binlog同步。
- Broker:Kafka中使用Broker来接受Producer和Consumer的请求,并把Message持久化到本地磁盘。每个Cluster当中会选举出一个Broker来担任Controller,负责处理Partition的Leader选举,协调Partition迁移等工作。
- ISR(In-Sync Replica):是Replicas的一个子集,表示目前Alive且与Leader能够“Catch-up”的Replicas集合。由于读写都是首先落到Leader上,所以一般来说通过同步机制从Leader上拉取数据的Replica都会和Leader有一些延迟(包括了延迟时间和延迟条数两个维度),任意一个超过阈值都会把该Replica踢出ISR。每个Partition都有它自己独立的ISR。
- Consumer Group (CG):这是kafka用来实现一个topic消息的广播(发给所有的consumer)和单播(发给任意一个consumer)的手段。一个topic可以有多个CG。topic的消息会复制(不是真的复制,是概念上的)到所有的CG,但每个partion只会把消息发给该CG中的一个consumer。如果需要实现广播,只要每个consumer有一个独立的CG就可以了;要实现单播只要所有的consumer在同一个CG。用CG还可以将consumer进行自由的分组而不需要多次发送消息到不同的topic。
- Zookeeper:集群依赖,保存meta信息。
5. Consumer与topic关系
本质上kafka只支持Topic
- 每个group中可以有多个consumer,每个consumer属于一个consumer group;
通常情况下,一个group中会包含多个consumer,这样不仅可以提高topic中消息的并发消费能力,而且还能提高"故障容错"性,如果group中的某个consumer失效那么其消费的partitions将会有其他consumer自动接管。
- 对于Topic中的一条特定的消息,只会被订阅此Topic的每个group中的其中一个consumer消费,此消息不会发送给一个group的多个consumer;
那么一个group中所有的consumer将会交错的消费整个Topic,每个group中consumer消息消费互相独立,我们可以认为一个group是一个"订阅"者。
- 在kafka中,一个partition中的消息只会被group中的一个consumer消费(同一时刻);
一个Topic中的每个partions,只会被一个"订阅者"中的一个consumer消费,不过一个consumer可以同时消费多个partitions中的消息。
- kafka的设计原理决定,对于一个topic,同一个group中不能有多于partitions个数的consumer同时消费,否则将意味着某些consumer将无法得到消息。
kafka只能保证一个partition中的消息被某个consumer消费时是顺序的;事实上,从Topic角度来说,当有多个partitions时,消息仍不是全局有序的。
6. Kafka消息的分发
Producer客户端负责消息的分发
- kafka集群中的任何一个broker都可以向producer提供metadata信息,这些metadata中包含"集群中存活的servers列表"/"partitions leader列表"等信息;
- 当producer获取到metadata信息之后, producer将会和Topic下所有partition leader保持socket连接;
- 消息由producer直接通过socket发送到broker,中间不会经过任何"路由层",事实上,消息被路由到哪个partition上由producer客户端决定;
比如可以采用"random""key-hash""轮询"等,如果一个topic中有多个partitions,那么在producer端实现"消息均衡分发"是必要的。
- 在producer端的配置文件中,开发者可以指定partition路由的方式。
Producer消息发送的应答机制
设置发送数据是否需要服务端的反馈,有三个值0,1,-1
0: producer不会等待broker发送ack
1: 当leader接收到消息之后发送ack
-1: 当所有的follower都同步消息成功后发送ack
request.required.acks=0
7. kafka文件存储机制
7.1. Kafka文件存储基本结构
- 在Kafka文件存储中,同一个topic下有多个不同partition,每个partition为一个目录,partiton命名规则为topic名称+有序序号,第一个partiton序号从0开始,序号最大值为partitions数量减1。
- 每个partion(目录)相当于一个巨型文件被平均分配到多个大小相等segment(段)数据文件中。但每个段segment file消息数量不一定相等,这种特性方便old segment file快速被删除。默认保留7天的数据。
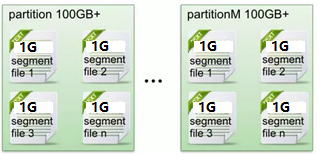
- 每个partiton只需要支持顺序读写就行了,segment文件生命周期由服务端配置参数决定。(什么时候创建,什么时候删除)
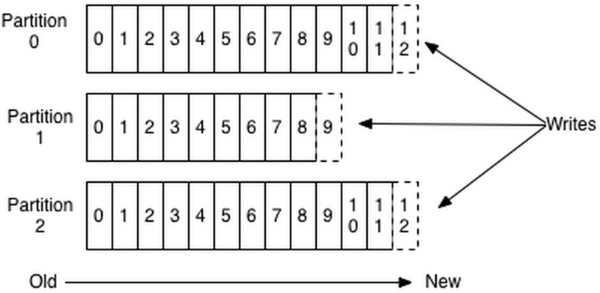
数据有序的讨论?
一个partition的数据是否是有序的? 间隔性有序,不连续
针对一个topic里面的数据,只能做到partition内部有序,不能做到全局有序。
特别加入消费者的场景后,如何保证消费者消费的数据全局有序的?伪命题。
只有一种情况下才能保证全局有序?就是只有一个partition。
7.2. Kafka Partition Segment
- Segment file组成:由2大部分组成,分别为index file和data file,此2个文件一一对应,成对出现,后缀".index"和“.log”分别表示为segment索引文件、数据文件。
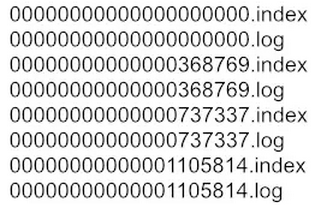
- Segment文件命名规则:partion全局的第一个segment从0开始,后续每个segment文件名为上一个segment文件最后一条消息的offset值。数值最大为64位long大小,19位数字字符长度,没有数字用0填充。
- 索引文件存储大量元数据,数据文件存储大量消息,索引文件中元数据指向对应数据文件中message的物理偏移地址。
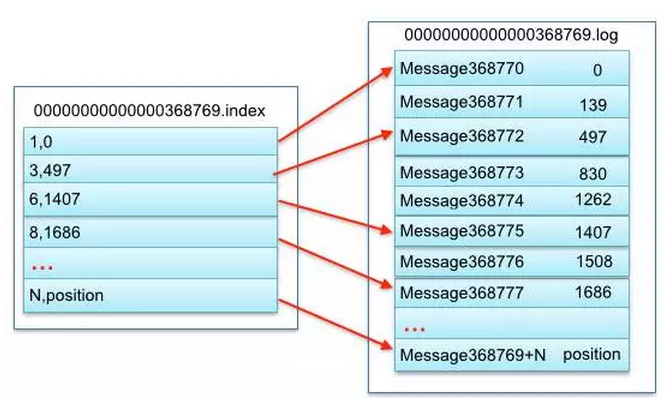
3,497:当前log文件中的第几条信息,存放在磁盘上的那个地方
说明:其中以索引文件中元数据3,497为例,依次在数据文件中表示第3个message(在全局partiton表示第368772个message)、以及该消息的物理偏移地址为497。
7.3. Kafka 查找message
读取offset=368776【全局offset】的message,需要通过下面2个步骤查找。

7.3.1. 查找segment file
00000000000000000000.index表示最开始的文件,起始偏移量(offset)为0
00000000000000368769.index的消息量起始偏移量为368770 = 368769 + 1
00000000000000737337.index的起始偏移量为737338=737337 + 1
其他后续文件依次类推。
以起始偏移量命名并排序这些文件,只要根据offset **二分查找**文件列表,就可以快速定位到具体文件。当offset=368776时定位到00000000000000368769.index和对应log文件。
7.3.2. 通过segment file查找message
当offset=368776时,依次定位到00000000000000368769.index的元数据物理位置和00000000000000368769.log的物理偏移地址
然后再通过00000000000000368769.log顺序查找直到offset=368776为止。
kafka_2.11-2.0.0_介绍的更多相关文章
- 从零开始编写自己的C#框架(6)——SubSonic3.0插件介绍(附源码)
前面几章主要是概念性的东西为主,向初学者们介绍项目开始前的一些知识与内容,从本章开始将会进入实操阶段,希望跟着本系统学习的朋友认真按说明做好每一步操作(对于代码最好是直接照着文档内容在你的IDE中打一 ...
- DotNetBar for Windows Forms 12.9.0.0_冰河之刃重打包版及制作Visual Studio C#项目模板文件详解
关于 DotNetBar for Windows Forms 12.9.0.0_冰河之刃重打包版 --------------------11.8.0.8_冰河之刃重打包版-------------- ...
- DotNetBar for Windows Forms 12.1.0.0_冰河之刃重打包版 原创发布
关于 DotNetBar for Windows Forms 12.1.0.0_冰河之刃重打包版 --------------------11.8.0.8_冰河之刃重打包版-------------- ...
- Java 集合系列11之 Hashtable详细介绍(源码解析)和使用示例
概要 前一章,我们学习了HashMap.这一章,我们对Hashtable进行学习.我们先对Hashtable有个整体认识,然后再学习它的源码,最后再通过实例来学会使用Hashtable.第1部分 Ha ...
- HPDL380G8平台11.2.0.3 RAC实施手册
HPDL380G8平台11.2.0.3 RAC实施手册 1 前言 此文档详细描述了Oracle 11gR2 数据库在HPDL380G上的安装RAC的检查及安装步骤.文档中#表示root用户执行,$ ...
- 模拟生产搭建Standby RAC实验环境(11.2.0.4 DG)
模拟生产搭建Standby RAC实验环境(11.2.0.4 DG) 环境:RHEL 6.5 + Oracle 11.2.0.4 GI.DB 1.需求背景介绍 2.准备工作 3.主库配置 4.备库配置 ...
- kafka_2.12-1.1.0 生产与消费java实现示例
环境准备: 1)需要在maven工程中引入依赖: <!-- https://mvnrepository.com/artifact/org.apache.kafka/kafka --> &l ...
- Vmware Workstation实现CentOS6.10_x64 下ORACLE RAC 11.2.0.4的搭建
想必大家在学习ORACLE 11g时,都想搭建一个RAC的实验环境.在搭建RAC实验环境时,会碰到诸如IP怎么规划.虚拟机环境下怎么共享磁盘.ASM磁盘创建,以及安装过程中会遇到这样那样的问题.搭建一 ...
- centos7安装kafka_2.11
1.下载 官网地址:http://kafka.apache.org/downloads.html 下载:wget https://www.apache.org/dyn/closer.cgi?path= ...
随机推荐
- Nacos系列:Nacos的三种部署模式
三种部署模式 Nacos支持三种部署模式 1.单机模式:可用于测试和单机使用,生产环境切忌使用单机模式(满足不了高可用) 2.集群模式:可用于生产环境,确保高可用 3.多集群模式:可用于多数据中心场景 ...
- TensorFlow(3)CNN中的函数
tf.nn.conv2d()函数 参数介绍: tf.nn.conv2d(input, filter, strides, padding, use_cudnn_on_gpu=None, name=Non ...
- [转]git commit之后,想撤销commit
本文转自:http://www.cnblogs.com/lfxiao/p/9378763.html 写完代码后,我们一般这样 git add . //添加所有文件 git commit -m &quo ...
- WebAPI参数传值string转bool,int转bool相关问题
今天在公司同事问了我一个问题,用postman传递json字符串给接口,接口获取到的值不正确. 我就看到下面的json数据: { "Mark":"1" } 接口 ...
- [android] 代码注册广播接收者&利用广播调用服务的方法
利用广播调用服务里面的方法,间接的方式调用服务内部的方法,与现实中差不多,请媒体曝光 主界面里面 在界面创建的时候开启一下服务普通的startService()方法 发送一条广播出去 获取Intent ...
- python面向对象学习(三)私有属性和私有方法
目录 1. 应用场景和定义方式 2. 伪私有属性和私有方法 在java或者其他的编程语言中,使用访问修饰符来限制属性和方法的访问级别,一般有public.protected.default.priva ...
- Java io 入门
目录 前言 代码演练 字符流 FileReader,FileWriter: BufferedReader,BufferedWriter: InputStreamReader,OutputStreamW ...
- Git学习(二)Git命令
1.创建新的git仓库 初始化一个Git仓库,使用git init命令. 上图中我们新建了目录/home/honey/cxf,并进入目录cxf执行命令git init完成新git仓库的初始化,初始化成 ...
- 实现响应式——CSS变量
CSS 变量是 CSS 引入的一个新特性,目前绝大多数浏览器已经支持了,它可以帮助我们用更少的代码写出同样多的样式,大大提高了工作效率,本篇文章将教你如何使用 CSS 变量(css variable) ...
- openEntityForm如何给关于(regardingobjectid)类型查找字段赋值?
本人微信和易信公众号: 微软动态CRM专家罗勇 ,回复264或者20170924可方便获取本文,同时可以在第一间得到我发布的最新的博文信息,follow me!我的网站是 www.luoyong.me ...