
TF:利用sklearn自带数据集使用dropout解决学习中overfitting的问题+Tensorboard显示变化曲线—Jason niu
import tensorflow as tf

from sklearn.datasets import load_digits

#from sklearn.cross_validation import train_test_split

from sklearn.model_selection import train_test_split

from sklearn.preprocessing import LabelBinarizer

# load data

digits = load_digits()  X = digits.data

y = digits.target

y = LabelBinarizer().fit_transform(y)

X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=.3)

def add_layer(inputs, in_size, out_size, layer_name, activation_function=None, ):

    # add one more layer and return the output of this layer

    Weights = tf.Variable(tf.random_normal([in_size, out_size]))

    biases = tf.Variable(tf.zeros([1, out_size]) + 0.1, )

    Wx_plus_b = tf.matmul(inputs, Weights) + biases

    # here to dropout

    Wx_plus_b = tf.nn.dropout(Wx_plus_b, keep_prob)

    if activation_function is None:

        outputs = Wx_plus_b

    else:

        outputs = activation_function(Wx_plus_b, )

    tf.summary.histogram(layer_name + '/outputs', outputs)

    return outputs

# define placeholder for inputs to network

keep_prob = tf.placeholder(tf.float32)

xs = tf.placeholder(tf.float32, [None, 64])

ys = tf.placeholder(tf.float32, [None, 10])

# add output layer

l1 = add_layer(xs, 64, 50, 'l1', activation_function=tf.nn.tanh)

prediction = add_layer(l1, 50, 10, 'l2', activation_function=tf.nn.softmax)

# the loss between prediction and real data

cross_entropy = tf.reduce_mean(-tf.reduce_sum(ys * tf.log(prediction),

                                              reduction_indices=[1]))

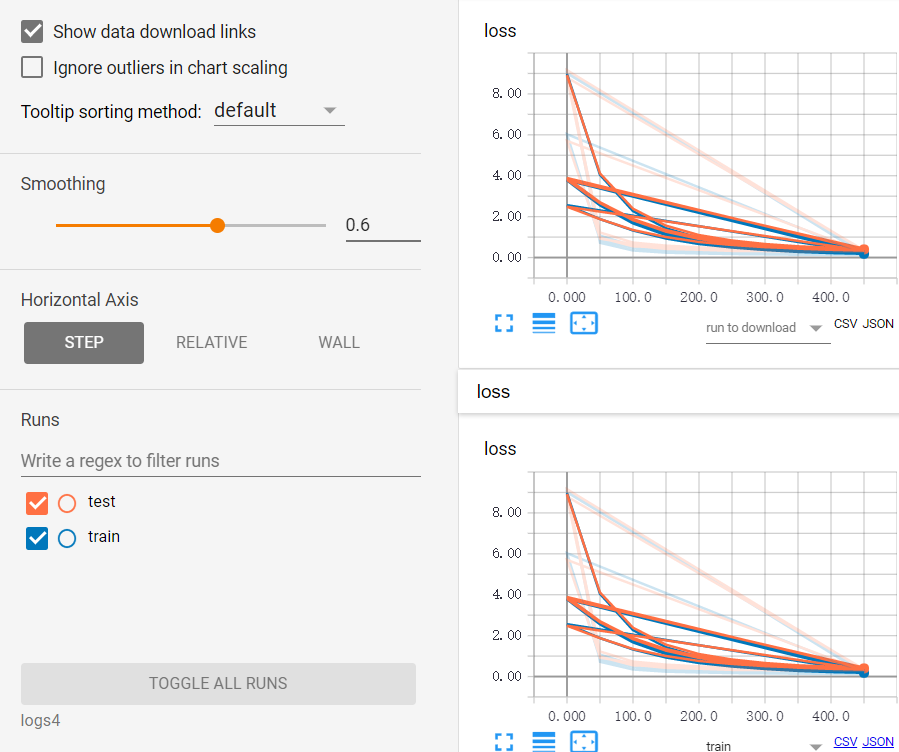
tf.summary.scalar ('loss', cross_entropy)

train_step = tf.train.GradientDescentOptimizer(0.5).minimize(cross_entropy)

sess = tf.Session()

merged =  tf.summary.merge_all()

# summary writer goes in here

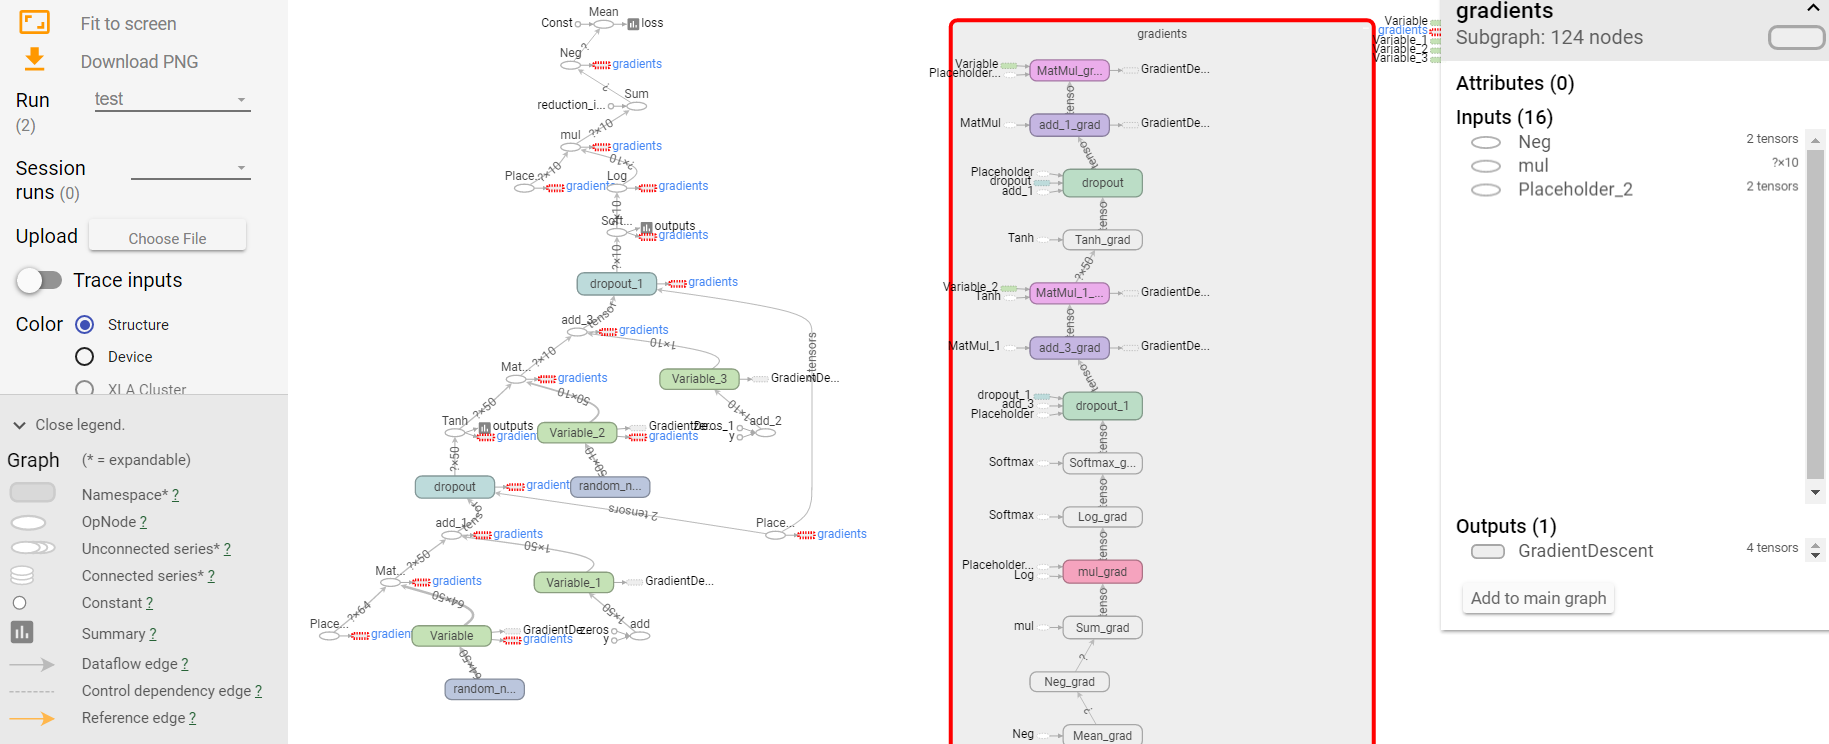
train_writer = tf.summary.FileWriter("logs4/train", sess.graph)

test_writer = tf.summary.FileWriter("logs4/test", sess.graph)

sess.run(tf.global_variables_initializer())

for i in range(500):

    # here to determine the keeping probability

    sess.run(train_step, feed_dict={xs: X_train, ys: y_train, keep_prob: 0.5})

    if i % 50 == 0:

        # record loss

        train_result = sess.run(merged, feed_dict={xs: X_train, ys: y_train, keep_prob: 1})

        test_result = sess.run(merged, feed_dict={xs: X_test, ys: y_test, keep_prob: 1})

        train_writer.add_summary(train_result, i)

        test_writer.add_summary(test_result, i)
TF:利用sklearn自带数据集使用dropout解决学习中overfitting的问题+Tensorboard显示变化曲线—Jason niu的更多相关文章
- TF之NN:matplotlib动态演示深度学习之tensorflow将神经网络系统自动学习并优化修正并且将输出结果可视化—Jason niu
import tensorflow as tf import numpy as np import matplotlib.pyplot as plt def add_layer(inputs, in_ ...
- TF:TF分类问题之MNIST手写50000数据集实现87.4%准确率识别:SGD法+softmax法+cross_entropy法—Jason niu
import tensorflow as tf from tensorflow.examples.tutorials.mnist import input_data # number 1 to 10 ...
- 利用Linux自带的logrotate管理日志
日常运维中,经常要对各类日志进行管理,清理,监控,尤其是因为应用bug,在1小时内就能写几十个G日志,导致磁盘爆满,系统挂掉. nohup.out,access.log,catalina.out 本文 ...
- GA:利用GA对一元函数进行优化过程,求x∈(0,10)中y的最大值——Jason niu
x = 0:0.01:10; y = x + 10*sin(5*x)+7*cos(4*x); figure plot(x, y) xlabel('independent variable') ylab ...
- 利用sklearn对MNIST手写数据集开始一个简单的二分类判别器项目(在这个过程中学习关于模型性能的评价指标,如accuracy,precision,recall,混淆矩阵)
.caret, .dropup > .btn > .caret { border-top-color: #000 !important; } .label { border: 1px so ...
- 『Sklearn』框架自带数据集接口
自带数据集类型如下: # 自带小型数据集# sklearn.datasets.load_<name># 在线下载数据集# sklearn.datasets.fetch_<name&g ...
- 利用Sklearn实现加州房产价格预测,学习运用机器学习的整个流程(包含很多细节注解)
Chapter1_housing_price_predict .caret, .dropup > .btn > .caret { border-top-color: #000 !impor ...
- 利用jdk自带的运行监控工具JConsole观察分析Java程序的运行
利用jdk自带的运行监控工具JConsole观察分析Java程序的运行 原文链接 一.JConsole是什么 从Java 5开始 引入了 JConsole.JConsole 是一个内置 Java 性能 ...
- 利用sklearn计算文本相似性
利用sklearn计算文本相似性,并将文本之间的相似度矩阵保存到文件当中.这里提取文本TF-IDF特征值进行文本的相似性计算. #!/usr/bin/python # -*- coding: utf- ...
随机推荐
- STM32应用实例十四:利用光敏二极管实现光度测量
最近我们在开发臭氧发生器时,需要监测生成的臭氧的浓度,于是想到使用光度计来测量.因为不同浓度的臭氧对管的吸收作用是不相同的,于是检测光照强度的变化就可以得到相应的浓度数据. 1.硬件设计 此次光照度检 ...
- java基础题刷题中的知识点复习
将变量转换为字符串方法:(String)待转对象..toString().String.valueOf(待转对象) 对字符串进行操作的方法,使用StringBuffer和StringBuilder定义 ...
- linux 批量进行:解压缩某一类压缩文件类型的文件
1: 编写脚本 [oracle@oracle oracle]$ vim unzip.sh ziphome=/u01/app/oracle ziplist=`du -a $ziphome |grep ' ...
- Confluence 6 配置附件大小
你可以限制上传到 Confluence 的附件的大小. 配置可以上传到 Confluence 的附件所允许的大小: 进入 > 基本配置(General Configuration). 选择 编 ...
- linux 使用的部分命令
搜索所有运行着的线程 ps -A | grep apt-get 你会得到类似下面的输出: root ? Ss : : /bin/sh /usr/lib/apt/apt.systemd.daily _a ...
- PDF裁剪页面,PDF怎么裁剪页面的方法
PDF文件要怎么裁剪页面呢,是不是有很多的小伙们想知道呢,当打开一个PDF文件的时候如果一个页面中有很多的空白页面就会影响文件的美观与使用,今天小编就为大家分享一下小编的裁剪页面的方法. 操作软件:迅 ...
- Nginx详解二十九:基于Nginx的中间件架构设计
基于Nginx的中间件架构 一:了解需求 1.定义Nginx在服务体系中的角色 1.静态资源服务 2.代理服务 3.动静分离 2.静态资源服务的功能设计 3.代理服务 二:设计评估 三:配置注意事项
- 安装cx_Oracle 6
首先声明,本文是在Linux 环境下进行安装.不涉及Windows 版安装. 一. 了解cx_Oracle 安装要求 要python 通过cx_Oracle 6 操作Oracle 数据库,以下几个条件 ...
- 论文阅读笔记三十二:YOLOv3: An Incremental Improvement
论文源址:https://pjreddie.com/media/files/papers/YOLOv3.pdf 代码:https://github.com/qqwweee/keras-yolo3 摘要 ...
- 2017-2018-2 20165206 实验二《Java面向对象程序设计》实验报告
2017-2018-2 20165206 实验二<Java面向对象程序设计>实验报告 一.实验报告封面 课程:Java程序设计 班级:1652班 姓名:韩啸 学号:20165206 指导教 ...