
Flume简介与使用(三)——Kafka Sink消费数据之Kafka安装
前面已经介绍了如何利用Thrift Source生产数据,今天介绍如何用Kafka Sink消费数据。
其实之前已经在Flume配置文件里设置了用Kafka Sink消费数据
agent1.sinks.kafkaSink.type = org.apache.flume.sink.kafka.KafkaSink

agent1.sinks.kafkaSink.topic = TRAFFIC_LOG

agent1.sinks.kafkaSink.brokerList = 10.208.129.3:,10.208.129.4:,10.208.129.5:

agent1.sinks.kafkaSink.metadata.broker.list = 10.208.129.3:,10.208.129.4:,10.208.129.5:

agent1.sinks.kafkaSink.producer.type=sync

agent1.sinks.kafkaSink.serializer.class=kafka.serializer.DefaultEncoder

agent1.sinks.kafkaSink.channel = memoryChannel
那么当Flume的channel收到数据的时候,会根据配置文件主动把数据event发送到Kafka的broker上,所以只要安装好Kafka就可以消费收据了。
Step 1: Download the code
下载安装包并解压
> tar -xzf kafka_2.11-0.10.0.0.tgz
> cd kafka_2.11-0.10.0.0
Step 2: Start the server
Kafka是基于Zookeeperl来实现分布式协同的,因此先启动Zookeeper:
> %Zookeeper_Home%/bin/zkServer.sh start
在配置文件server.properties中把下面一句前面的注释去掉,然后启动Kafka服务器
> #listeners=PLAINTEXT://:9092
> bin/kafka-server-start.sh config/server.properties
接下来启动其他两个broker:
> cp config/server.properties config/server-1.properties
> cp config/server.properties config/server-2.properties
修改配置文件,broker.id不能重复
config/server-1.properties:

    broker.id=1
config/server-2.properties:

    broker.id=2
Step 3: Create a topic
创建一个TRAFFIC_LOG主题的broker,复制因子为3(因为有3个Kafka服务器集群),分区个数为1
> bin/kafka-topics.sh --create --zookeeper 10.208.129.4:2181 --replication-factor 3 --partitions 1 --topic TRAFFIC_LOG
Step 5: Start a consumer
> bin/kafka-console-consumer.sh --zookeeper 10.208.129.4:2181/kafka --topic TRAFFIC_LOG --from-beginning
topic一定要写正确了,否则消费不到数据
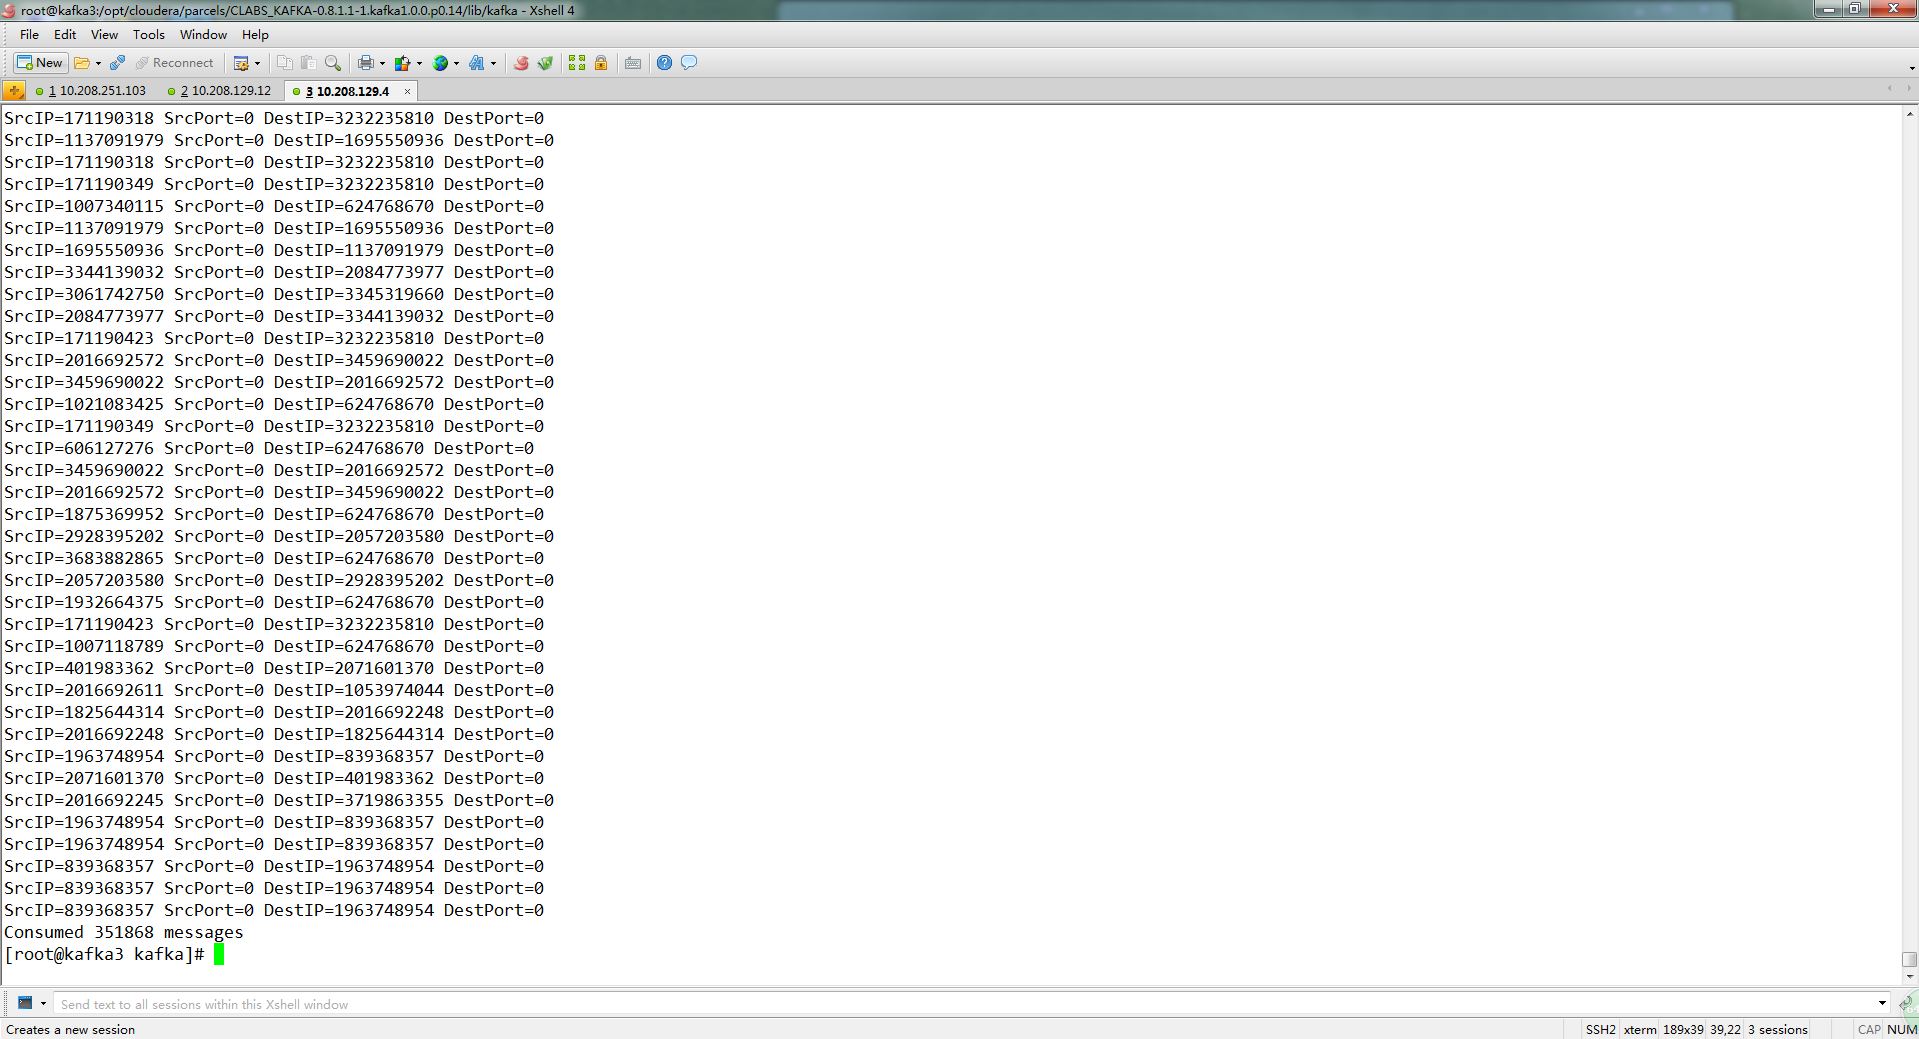
如果在终端看到之前接入的Thrift Source输出,那么整个Flume+Kafka算是跑通了
这里已经引入了Flume和Kafka,下一篇将介绍Kafka以及Flume和Kafka的区别
Flume简介与使用(三)——Kafka Sink消费数据之Kafka安装的更多相关文章
- kafka查看消费数据
一.如何查看 在老版本中,使用kafka-run-class.sh 脚本进行查看.但是对于最新版本,kafka-run-class.sh 已经不能使用,必须使用另外一个脚本才行,它就是kafka-co ...
- Python往kafka生产消费数据
安装 kafka: pip install kafka-python 生产数据 from kafka import KafkaProducer import json ''' 生产者demo 向te ...
- 关于kafka重新消费数据问题
我们在使用consumer消费数据时,有些情况下我们需要对已经消费过的数据进行重新消费,这里介绍kafka中两种重新消费数据的方法. 1. 修改offset 我们在使用consumer消费的时候,每个 ...
- kafka无法消费数据
遇到一个问题,使用Python kafka客户端和kafka命令行都无法消费数据,但是在kafka命令行后面添加--partition 0后就可以消费数据. bin/kafka-console-con ...
- 相同数据源情况下,使用Kafka实时消费数据 vs 离线环境下全部落表后处理数据,结果存在差异
原因分析: 当某个consumer宕机时,消费位点(例如2s提交一次)尚未提交到zookeeper,此时Kafka集群自动rebalance后另一consumer来接替该宕机consumer继续消费, ...
- kafka无法消费数据提示找不到分区
1 原因 自己重建了kafka 但是只有一个分区 以前的offset没有重置,导致了消费的时候 找不到主题分区 手动删除之前的offset数据(mysql自定义配置)
- Flume简介与使用(一)——Flume安装与配置
Flume简介与使用(一)——Flume安装与配置 Flume简介 Flume是一个分布式的.可靠的.实用的服务——从不同的数据源高效的采集.整合.移动海量数据. 分布式:可以多台机器同时运行采集数据 ...
- 《从0到1学习Flink》—— Flink 写入数据到 Kafka
前言 之前文章 <从0到1学习Flink>-- Flink 写入数据到 ElasticSearch 写了如何将 Kafka 中的数据存储到 ElasticSearch 中,里面其实就已经用 ...
- Spark Streaming和Kafka整合保证数据零丢失
当我们正确地部署好Spark Streaming,我们就可以使用Spark Streaming提供的零数据丢失机制.为了体验这个关键的特性,你需要满足以下几个先决条件: 1.输入的数据来自可靠的数据源 ...
随机推荐
- IO 图
- vector(相对线程安全) arryList(线程不安全)
1.什么是线程安全? 如果说某个集合是线程安全的,那么我们就不用考虑并发访问这个集合?(需要定义自己百度,但是很难懂) 2.深入jvm中的线程安全的级别. a不变模式(String等基本类型) b.绝 ...
- codeforce 609A - USB Flash Drives
排序水题 #include<iostream> #include<cstdlib> #include<cstdio> #include<algorithm&g ...
- leetcode@ [211] Add and Search Word - Data structure design
https://leetcode.com/problems/add-and-search-word-data-structure-design/ 本题是在Trie树进行dfs+backtracking ...
- SPOJ-7001 VLATTICE 莫比乌斯反演定理
题目链接:http://www.spoj.com/problems/VLATTICE/ 题意:求gcd(x,y,z)=1,1<=x,y,z<=n,的个数. 开始做的时候枚举gcd(x,y) ...
- Visual Studio C++ Command Line
最近在Visual Studio 2012进行vp8的开发,之前一直都是在ubuntu上进行开发,关于编译链接的一些选项可直接在makefile中定义,比如vp8的头文件都放在include文件下面, ...
- 【现代程序设计】【homework-04】
Personal Software Process Stages 时间百分比(%) 实际花费的时间 (分钟) 原来估计的时间 (分钟) 计划 0 0 0 · 估计这个任务需要多少时 ...
- [Objective-c 基础 - 3.3] @property属性详解
ARC 自动引用计数 ARC不是垃圾回收,而是编译器自动插入代码来减少程序员的代码输入和失误. 同时比垃圾和效率要高,因为其不影响运行时间,相当于自己管理内存. 总是通过属性来 ...
- jsDoc注释的规范
注释以/** 开始 */结束 JSDoc 命令属性 命令名 描述 @param @argument 指定参数名和说明来描述一个函数参数. @return @returns 描述函数的返回值. ...
- How good software makes us stupid?
How good software makes us stupid? 科技是怎样让人变傻的? People assume that iPhones, laptops and Netflix are e ...