
sparkSql使用hive数据源
<dependency>

      <groupId>org.scala-lang</groupId>

      <artifactId>scala-library</artifactId>

      <version>${scala.version}</version>

    </dependency>

    <dependency>

      <groupId>junit</groupId>

      <artifactId>junit</artifactId>

      <version>4.4</version>

      <scope>test</scope>

    </dependency>

    <dependency>

      <groupId>org.specs</groupId>

      <artifactId>specs</artifactId>

      <version>1.2.5</version>

      <scope>test</scope>

    </dependency>

      <!-- https://mvnrepository.com/artifact/oracle/ojdbc6 -->

      <dependency>

          <groupId>com.oracle</groupId>

          <artifactId>ojdbc6</artifactId>

          <version>11.2.0.3</version>

      </dependency>

      <!-- https://mvnrepository.com/artifact/mysql/mysql-connector-java -->

    <dependency>

      <groupId>mysql</groupId>

      <artifactId>mysql-connector-java</artifactId>

      <version>${mysql.version}</version>

    </dependency>

    <!-- https://mvnrepository.com/artifact/com.alibaba/druid -->

    <dependency>

      <groupId>com.alibaba</groupId>

      <artifactId>druid</artifactId>

      <version>${druid.version}</version>

    </dependency>

    <!-- https://mvnrepository.com/artifact/org.apache.spark/spark-core -->

    <dependency>

      <groupId>org.apache.spark</groupId>

      <artifactId>spark-core_2.11</artifactId>

      <version>${spark.verson}</version>

    </dependency>

    <!-- https://mvnrepository.com/artifact/org.apache.spark/spark-streaming -->

    <dependency>

      <groupId>org.apache.spark</groupId>

      <artifactId>spark-streaming_2.11</artifactId>

      <version>${spark.verson}</version>

      <scope>provided</scope>

    </dependency>

    <!-- https://mvnrepository.com/artifact/org.apache.spark/spark-sql -->

    <dependency>

      <groupId>org.apache.spark</groupId>

      <artifactId>spark-sql_2.11</artifactId>

      <version>${spark.verson}</version>

    </dependency>

    <dependency>

      <groupId>org.apache.spark</groupId>

      <artifactId>spark-hive_2.11</artifactId>

      <version>${spark.verson}</version>

    </dependency>
2.代码
import org.apache.spark.{SparkConf, SparkContext}

import org.apache.spark.sql.hive.HiveContext

object HiveDataSource extends App {

  val config = new SparkConf().setAppName("HiveDataSource").setMaster("local")

  val sc = new SparkContext(config)

  val sqlContext = new HiveContext(sc)

  sqlContext.sql("drop table if exists default.student_infos")

  sqlContext.sql("create  table if not exists default.student_infos (name string,age int) row format delimited fields terminated by ',' stored  as textfile")

  sqlContext.sql("load data inpath '/tmp/student_infos.txt' into table  default.student_infos")

  // 用同样的方式,给student_scores导入数据

  sqlContext.sql("DROP  TABLE  IF EXISTS default.student_scores")

  sqlContext.sql("create  table if not exists default.student_scores (name string,score int) row format delimited fields terminated by ',' stored  as textfile")

  sqlContext.sql("load data inpath '/tmp/student_scores.txt' into table  default.student_scores")

  // 关联两张表执行查询,查询成绩大于80分的学生

  val goodStudentDf = sqlContext.sql("select t1.name,t1.age,t2.score from default.student_infos t1 join default.student_scores t2 on t1.name = t2.name")

  goodStudentDf.show()

}
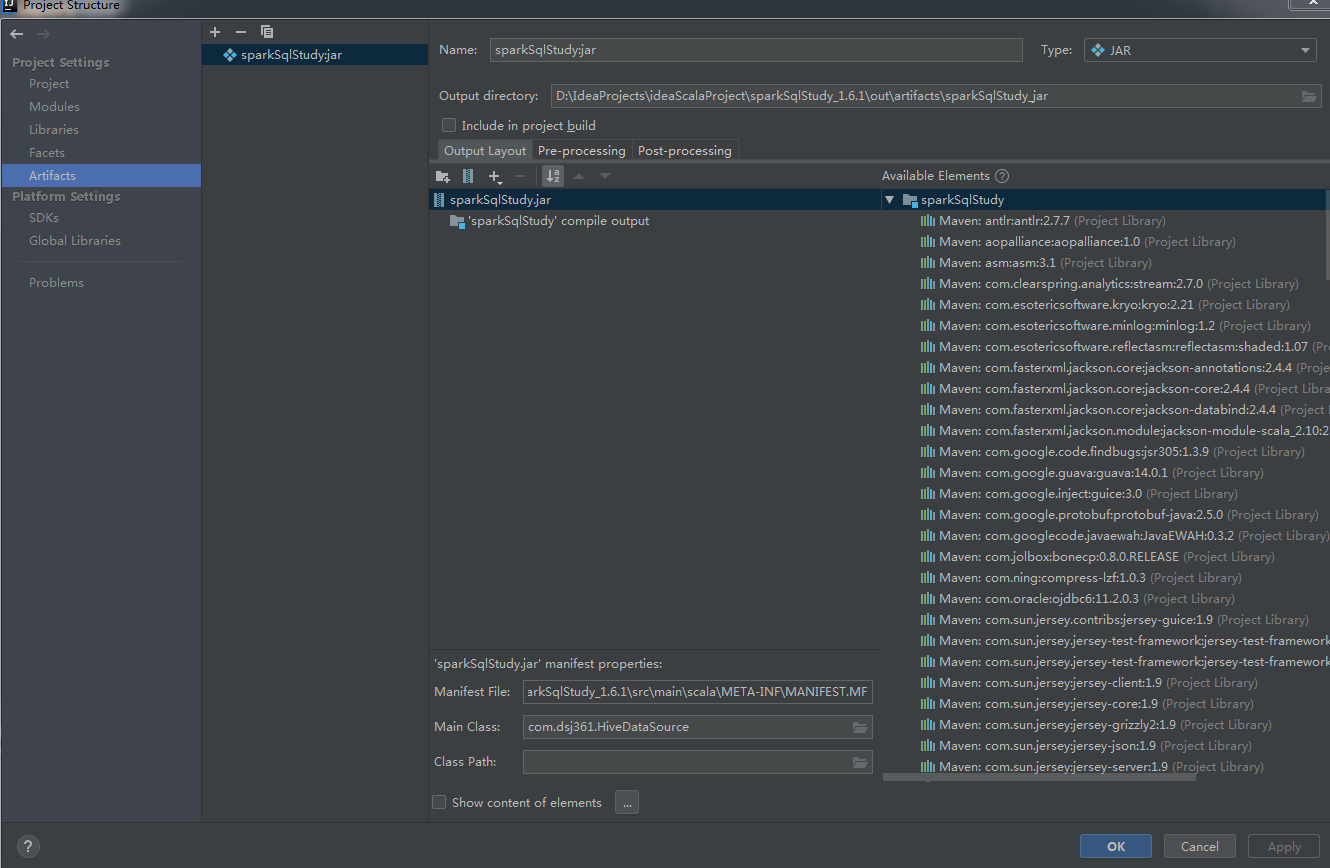
/home/hadoop/app/spark/bin/spark-submit \

--class com.dsj361.HiveDataSource \

--master local[*] \

--num-executors 2 \

--driver-memory 1000m \

--executor-memory 1000m \

--executor-cores 2 \

/home/hadoop/sparksqlapp/jar/sparkSqlStudy.jar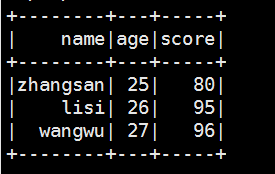
<wiz_tmp_tag id="wiz-table-range-border" contenteditable="false" style="display: none;">
附件列表
sparkSql使用hive数据源的更多相关文章
- SparkSQL与Hive on Spark的比较
简要介绍了SparkSQL与Hive on Spark的区别与联系 一.关于Spark 简介 在Hadoop的整个生态系统中,Spark和MapReduce在同一个层级,即主要解决分布式计算框架的问题 ...
- SparkSQL与Hive on Spark
SparkSQL与Hive on Spark的比较 简要介绍了SparkSQL与Hive on Spark的区别与联系 一.关于Spark 简介 在Hadoop的整个生态系统中,Spark和MapR ...
- SparkSQL和hive on Spark
SparkSQL简介 SparkSQL的前身是Shark,给熟悉RDBMS但又不理解MapReduce的技术人员提供快速上手的工具,hive应运而生,它是当时唯一运行在Hadoop上的SQL-on-h ...
- SparkSQL访问Hive源,MySQL源
SparkSQL访问Hive源,MySQL源 一.SparkSQL访问Hive源 软件环境 SparkSQL命令行模式可以直接连接Hive的 Java程序SparkSQL连接Hive 二.SparkS ...
- SparkSQL读取Hive中的数据
由于我Spark采用的是Cloudera公司的CDH,并且安装的时候是在线自动安装和部署的集群.最近在学习SparkSQL,看到SparkSQL on HIVE.下面主要是介绍一下如何通过SparkS ...
- 关于sparksql操作hive,读取本地csv文件并以parquet的形式装入hive中
说明:spark版本:2.2.0 hive版本:1.2.1 需求: 有本地csv格式的一个文件,格式为${当天日期}visit.txt,例如20180707visit.txt,现在需要将其通过spar ...
- spark on yarn模式下配置spark-sql访问hive元数据
spark on yarn模式下配置spark-sql访问hive元数据 目的:在spark on yarn模式下,执行spark-sql访问hive的元数据.并对比一下spark-sql 和hive ...
- sparksql 操作hive
写在前面:hive的版本是1.2.1spark的版本是1.6.x http://spark.apache.org/docs/1.6.1/sql-programming-guide.html#hive- ...
- 【完美解决】Spark-SQL、Hive多 Metastore、多后端、多库
[完美解决]Spark-SQL.Hive多 Metastore.多后端.多库 [完美解决]Spark-SQL.Hive多 Metastore.多后端.多库 SparkSQL 支持同时连接多种 Meta ...
随机推荐
- ABAP-根据采购订单行项目统计供应商未清额和已清额
1.传入和传出表结构都是一样的: FUNCTION zmm_fm_po_invence. *"------------------------------------------------ ...
- 树莓派dht11,土壤湿度传感器,继电器的使用。树莓派云灌溉(二)
关于传感器的一些说明 我的想法是这样的 我尽量用易于理解的语言去说我的想法 首先,土壤湿度传感器和dh11会获取数据,然后树莓派会处理这些数据,读出土壤温湿度和空气温湿度,并将这些数据上传到云服务器, ...
- 关于阿里云Mysql分页查询不走索引的问题
需要修改阿里云中的MYSQL 配置参数 : eq_range_index_dive_limit 阿里云上默认是 10 , 这个参数 表示 in 查询 条件超过 10 个 就不走索引,走全表扫描.如果我 ...
- 微信小程序项目总结-记账小程序(包括后端)
一.小程序部分 这是理财系统的前端,江苏海洋大学微信小程序比赛,最后获得了一等奖 GitHub:https://github.com/GeorgeLeoo/finance 1. 项目描述 (1). 此 ...
- 一文看懂ConstraintLayout的用法
ConstraintLayout 相对于 RelativeLayout来说性能更好,布局上也更加灵活.在最新的Google Android开发文档中是推荐使用 ConstraintLayout的,下面 ...
- Sqlserver 存储过程中使用事务
ALTER PROCEDURE [dbo].[Purchase_Create]@Docid varchar(100), ---- 搜索唯一编号@Title varchar(100), - ...
- Linux - 通过expect工具实现脚本的自动交互
目录 1 安装expect工具 2 expect的常用命令 3 作用原理简介 3.1 示例脚本 3.2 脚本功能解读 4 其他脚本使用示例 4.1 直接通过expect执行多条命令 4.2 通过she ...
- Redis缓存,持久化,高可用
一,Redis作缓存服务器 本篇博客是接着上一篇博客未分享完的技术点. redis作为缓存服务器是众多企业中的选择之一,虽然该技术很成熟但也是存在一定的问题.就是缓存带来的缓存穿透,缓存击穿, ...
- cocos creator 事件
cocos creator 事件 在做一个消除类游戏时,需要对点击的方块做出响应.代码很简单,可背后的原理还多着呢. 1. 普通节点注册click事件 在cc中如果需要相应click事件,需要为该节点 ...
- vue中组件通信
组件的通信 1. 父子组件通信 案例: //父子组件通信思路 // 1 将父组件的数据传给子组件 在子组件上自定义单项数据绑定 // 2 子组件用props 接受自定义的那个:号属性 Vue.co ...