
搭建高可用的flink JobManager HA
JobManager协调每个flink应用的部署,它负责执行定时任务和资源管理。
每一个Flink集群都有一个jobManager, 如果jobManager出现问题之后,将不能提交新的任务和运行新任务失败,这样会造成单点失败,所以需要构建高可用的JobMangager。
类似zookeeper一样,构建好了高可用的jobManager之后,如果其中一个出现问题之后,其他可用的jobManager将会接管任务,变为leader。不会造成flink的任务执行失败。可以在单机版和集群版构建jobManager。
下面开始构建一个单机版flink的JobManger高可用HA版。
首先需要设置SSH免密登录,因为启动的时候程序会通过远程登录访问并且启动程序。
执行命令,就可以免密登录自己的机器了。如果不进行免密登录的话,那么启动的hadoop的时候会报 "start port 22 connection refused"。
ssh-keygen -t rsa

ssh-copy-id -i ~/.ssh/id_rsa.pub huangqingshi@localhost
接下来在官网上下载hadoop的binary文件,然后开始解压,我下载的版本为hadoop-3.1.3版本。安装Hadoop的目的是用hadoop存储flink的JobManager高可用的元数据信息。
我安装的是hadoop的单机版,可以构建hadoop集群版。接下来进行hadoop的配置。
配置etc/hadoop/coresite.xml,指定namenode的hdfs协议文件系统的通信地址及临时文件目录。
<configuration>

    <property>

        <!--指定namenode的hdfs协议文件系统的通信地址-->

        <name>fs.defaultFS</name>

        <value>hdfs://127.0.0.1:9000</value>

    </property>

    <property>

        <!--指定hadoop集群存储临时文件的目录-->

        <name>hadoop.tmp.dir</name>

        <value>/tmp/hadoop/tmp</value>

    </property>

</configuration>
配置etc/hadoop/hdfs-site.xml, 设置元数据的存放位置,数据块的存放位置,DFS监听端口。
<configuration>

    <property>

        <!--namenode 节点数据(即元数据)的存放位置,可以指定多个目录实现容错,多个目录用逗号分隔-->

        <name>dfs.namenode.name.dir</name>

        <value>/tmp/hadoop/namenode/data</value>

    </property>

    <property>

        <!--datanode 节点数据(即数据块)的存放位置-->

        <name>dfs.datanode.data.dir</name>

        <value>/tmp/hadoop/datanode/data</value>

    </property>

    <property>

        <!--手动设置DFS监听端口-->

        <name>dfs.http.address</name>

        <value>127.0.0.1:</value>

    </property>

</configuration>
配置etc/hadoop/yarn-site.xml,配置NodeManager上运行的附属服务以及resourceManager主机名。
<configuration>

<!-- Site specific YARN configuration properties -->

    <property>

        <!--配置NodeManger上运行的附属服务。需要配置成mapreduce_shuffle后才可以在Yarn上运行MapReduce程序-->

        <name>yarn.nodemanager.aux-services</name>

        <value>mapreduce_shuffle</value>

    </property>

    <property>

        <!--resourcemanager 的主机名-->

        <name>yarn.resourcemanager.hostname</name>

        <value>localhost</value>

    </property>

</configuration>
配置etc/hadoop/mapred-site.xml,指定mapreduce作业运行在yarn上。
    <property>

        <!--指定mapreduce作业运行在yarn上-->

        <name>mapreduce.framework.name</name>

        <value>yarn</value>

    </property>

</configuration>
需要执行nameNode的format操作,不执行直接启动会报“NameNode is not formatted.”。
bin/hdfs namenode -format
接下来启动hadoop,如果成功的话,可以访问如下URL:
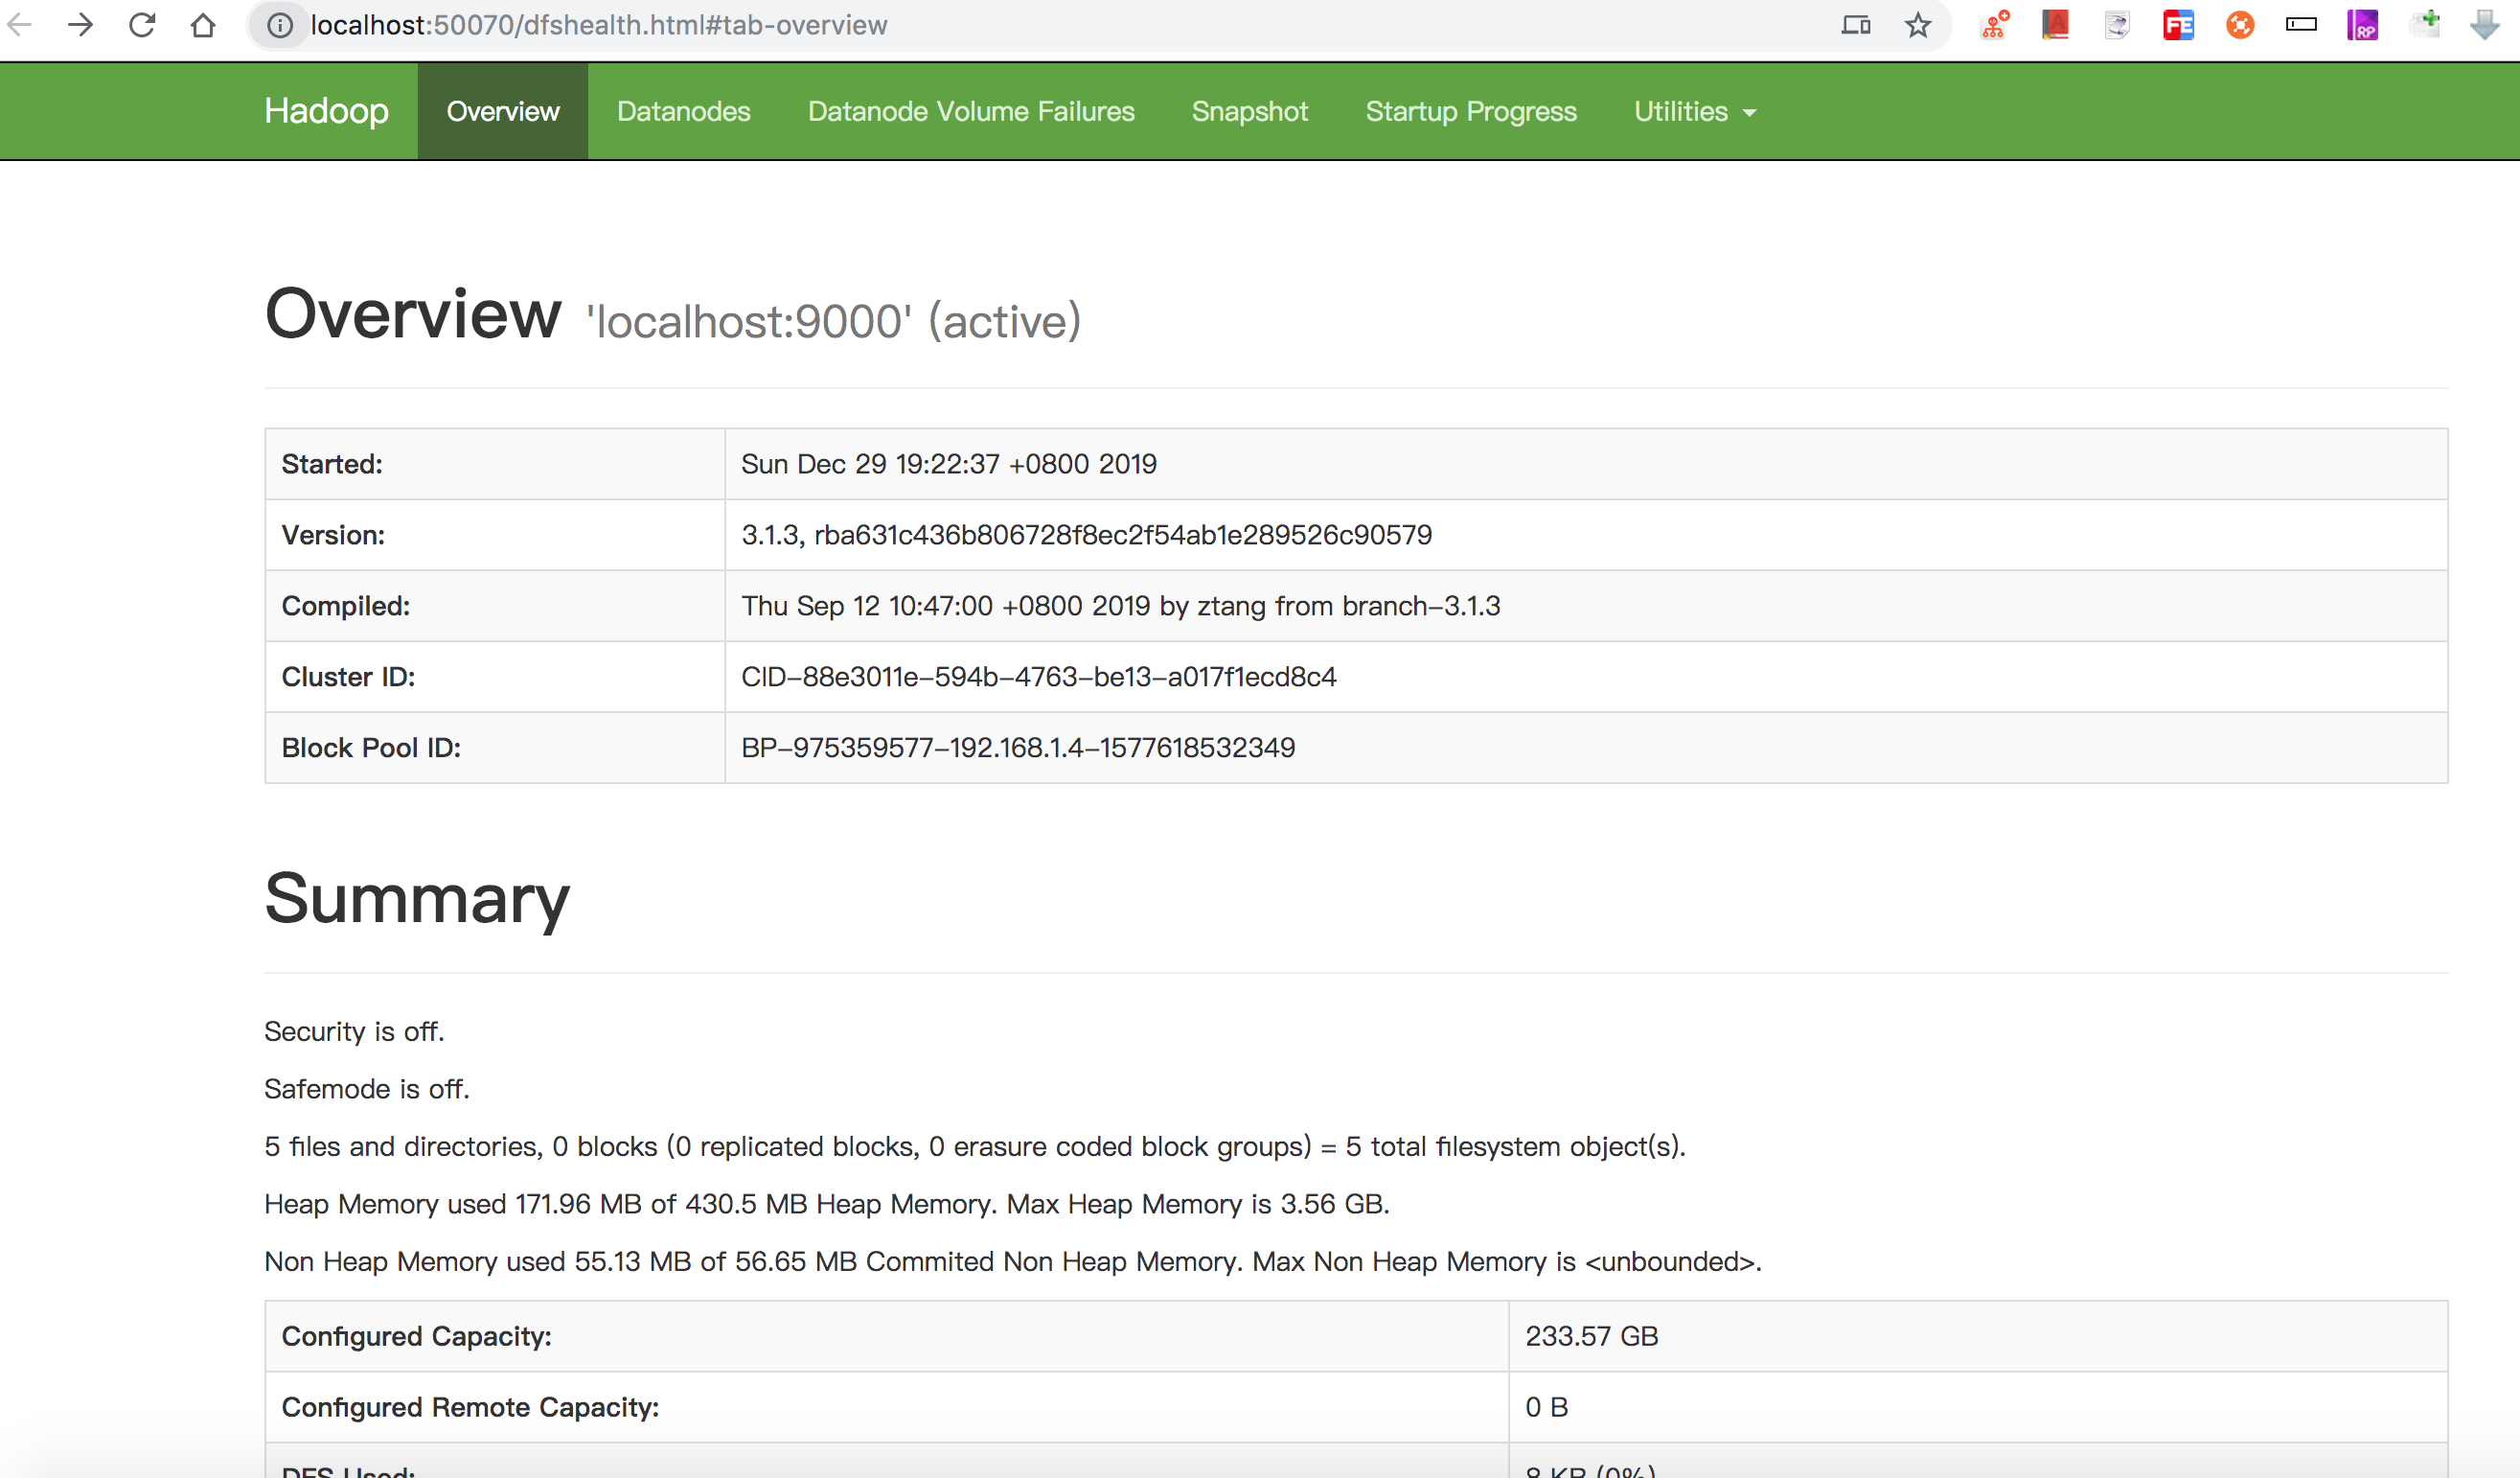
http://localhost:8088/ 查看构成cluster的节点
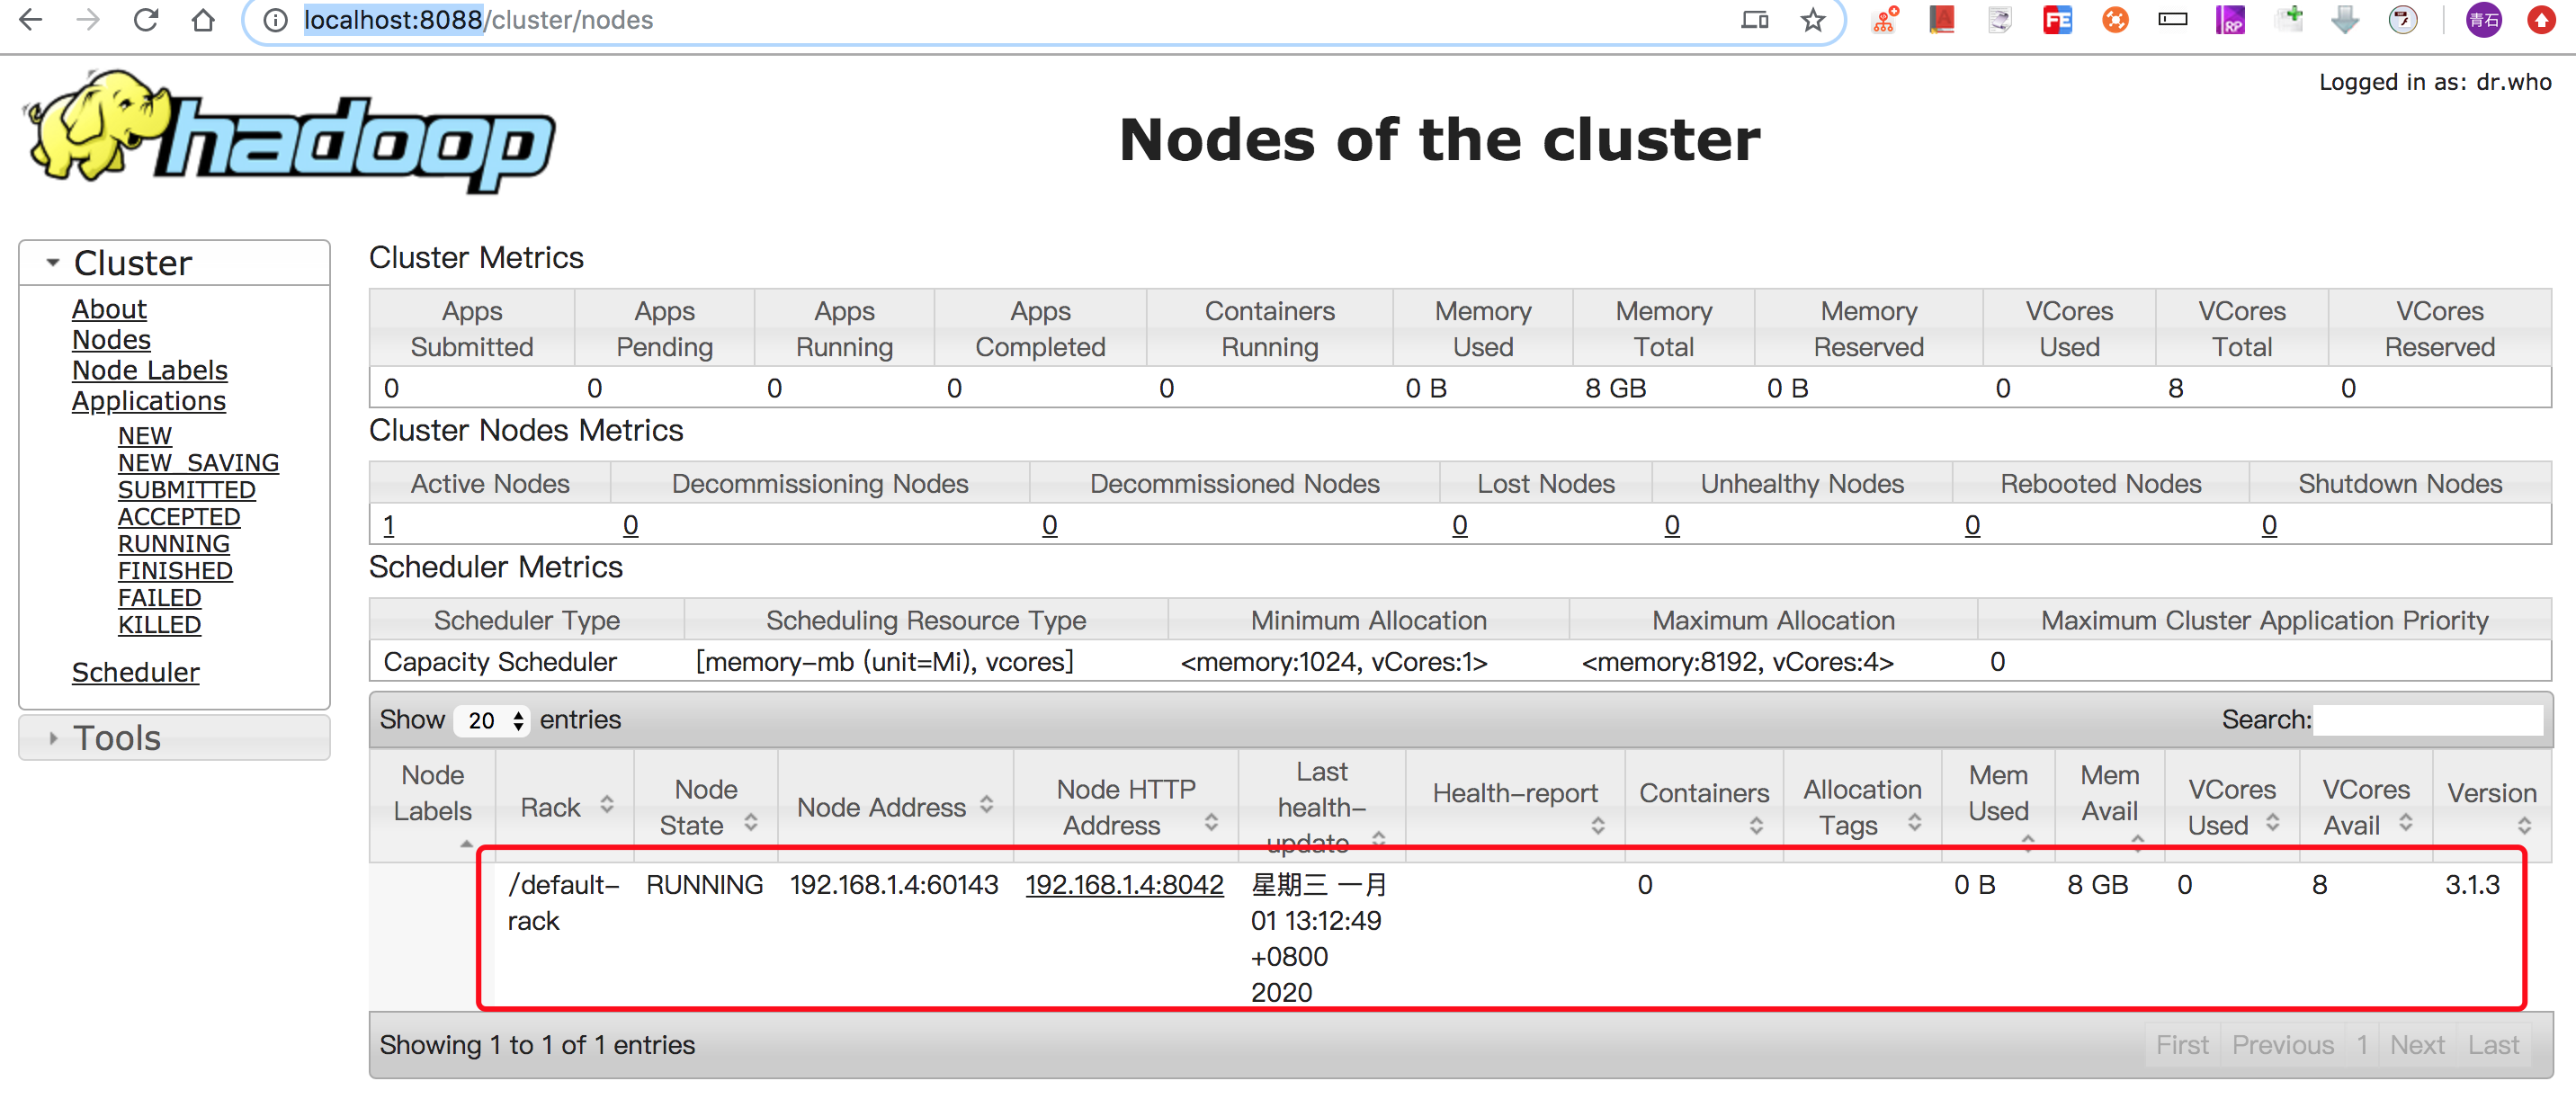
http://localhost:8042/node 查看node的相关信息。

以上说明hadoop单机版搭建完成。
接下来需要下载一个flink的hadoop插件,要不然flink启动的时候会报错的。
把下载的插件放到flink文件的lib文件夹中。
配置一下flink文件夹的conf/flink-conf.yaml。指定HA高可用模式为zookeeper,元数据存储路径用于恢复master,zookeeper用于flink的 checkpoint 以及 leader 选举。最后一条为zookeeper单机或集群的地址。
high-availability: zookeeper

high-availability.storageDir: hdfs://127.0.0.1:9000/flink/ha

high-availability.zookeeper.quorum: localhost:2181
其他的采用默认配置,比如JobManager的最大堆内存为1G,每一个TaskManager提供一个task slot,执行串行的任务。
接下来配置flink的 conf/masters 用于启动两个主节点JobManager。
localhost:8081

localhost:8082
配置flink的 conf/slaver 用于配置三个从节点TaskManager。
localhost

localhost

localhost
进入zookeeper路径并且启动zookeeper
bin/zkServer.sh start
进入flink路径并启动flink。
bin/start-cluster.sh conf/flink-conf.yaml
启动截图说明启动了两个节点的HA集群。

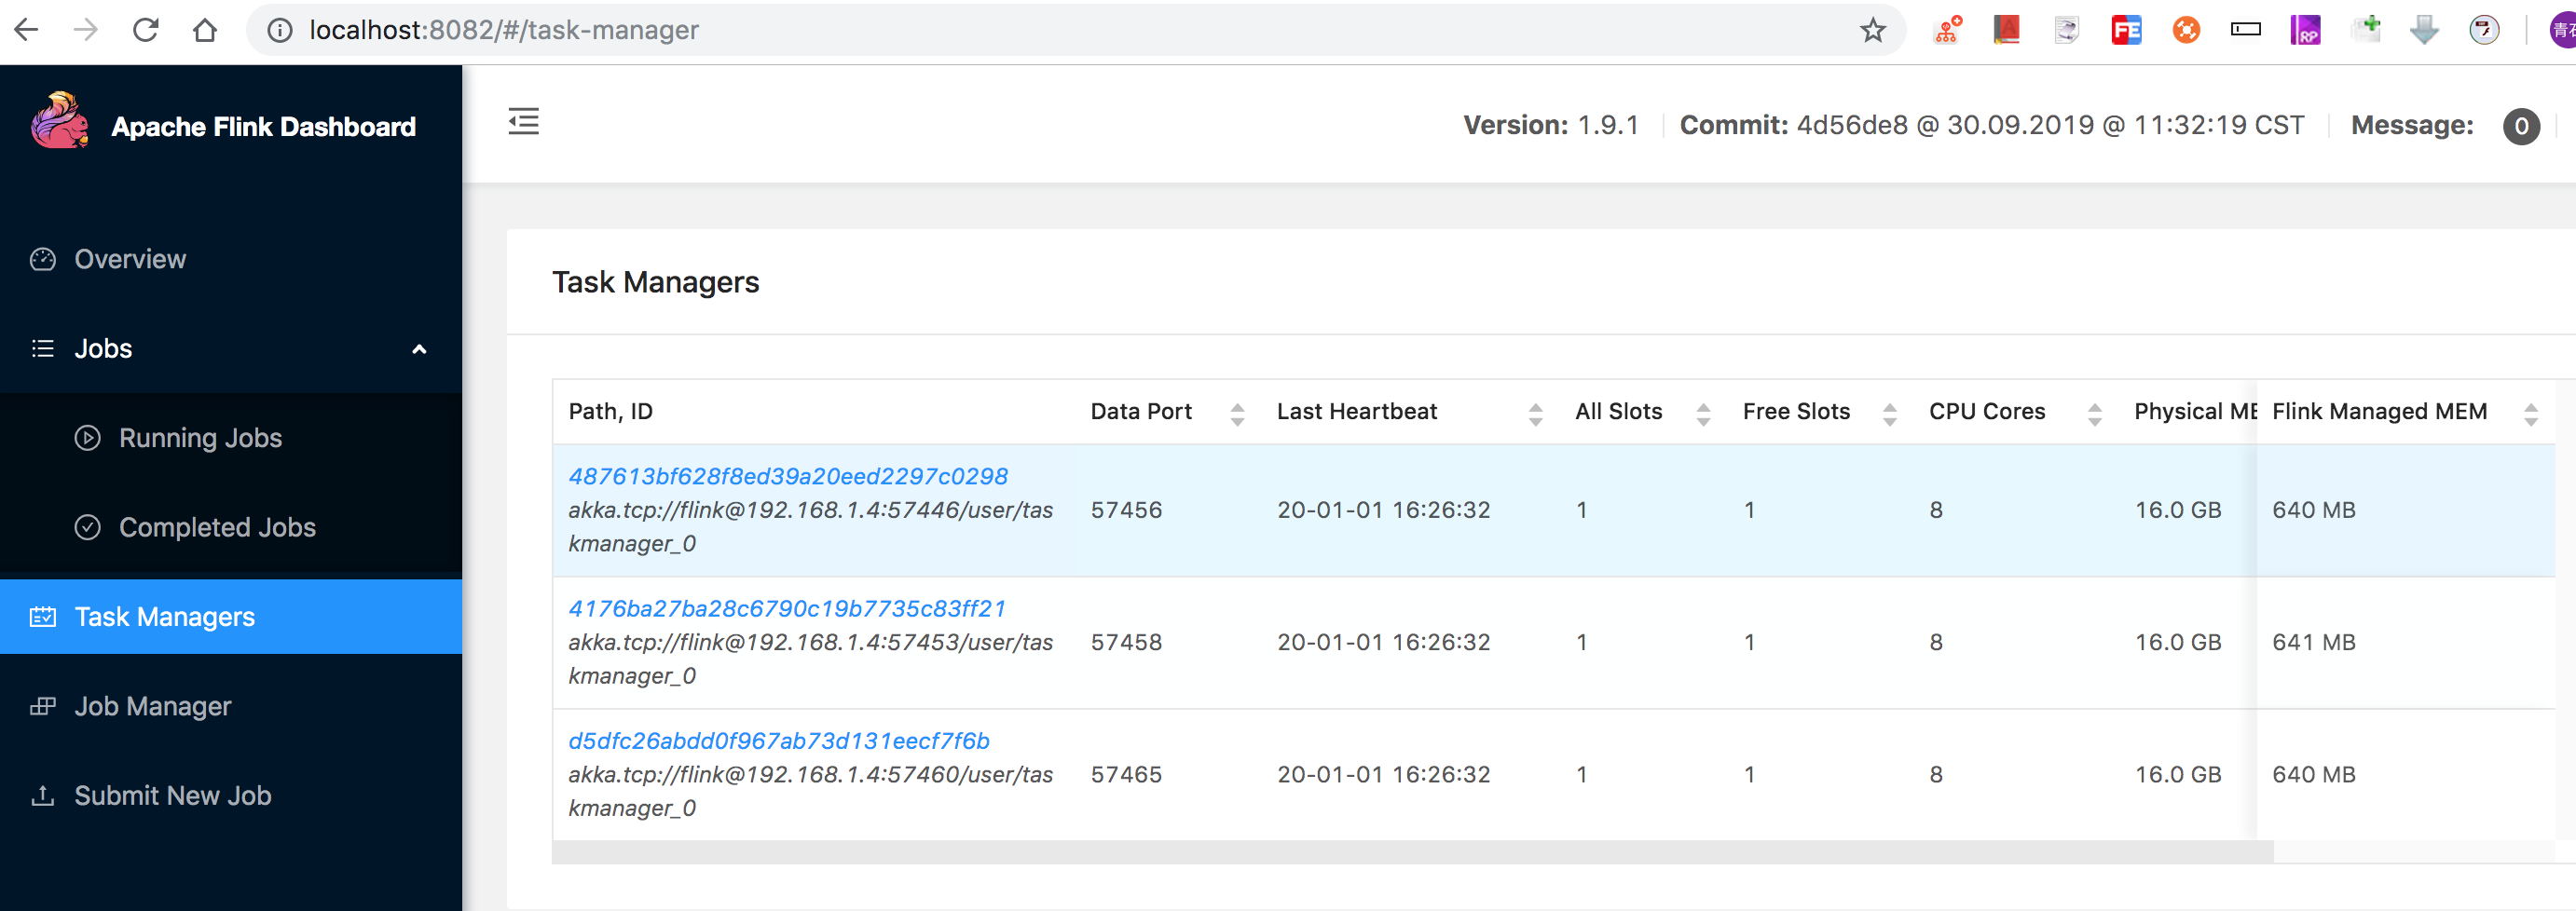
执行jps,两个JobManager节点和三个TaskManager节点:

浏览器访问 http://localhost:8081 和 http://localhost:8082,查看里边的日志,搜索granted leadership的说明是主JobManager,如下图。8082端口说明为主JobMaster

一个JobManager, 里边有三个TaskManager,两个JobManager共享这三个TaskManager:
接下来我们来验证一下集群的HA功能,我们已经知道8082为主JobManager,然后我们找到它的PID,使用如下命令:
ps -ef | grep StandaloneSession
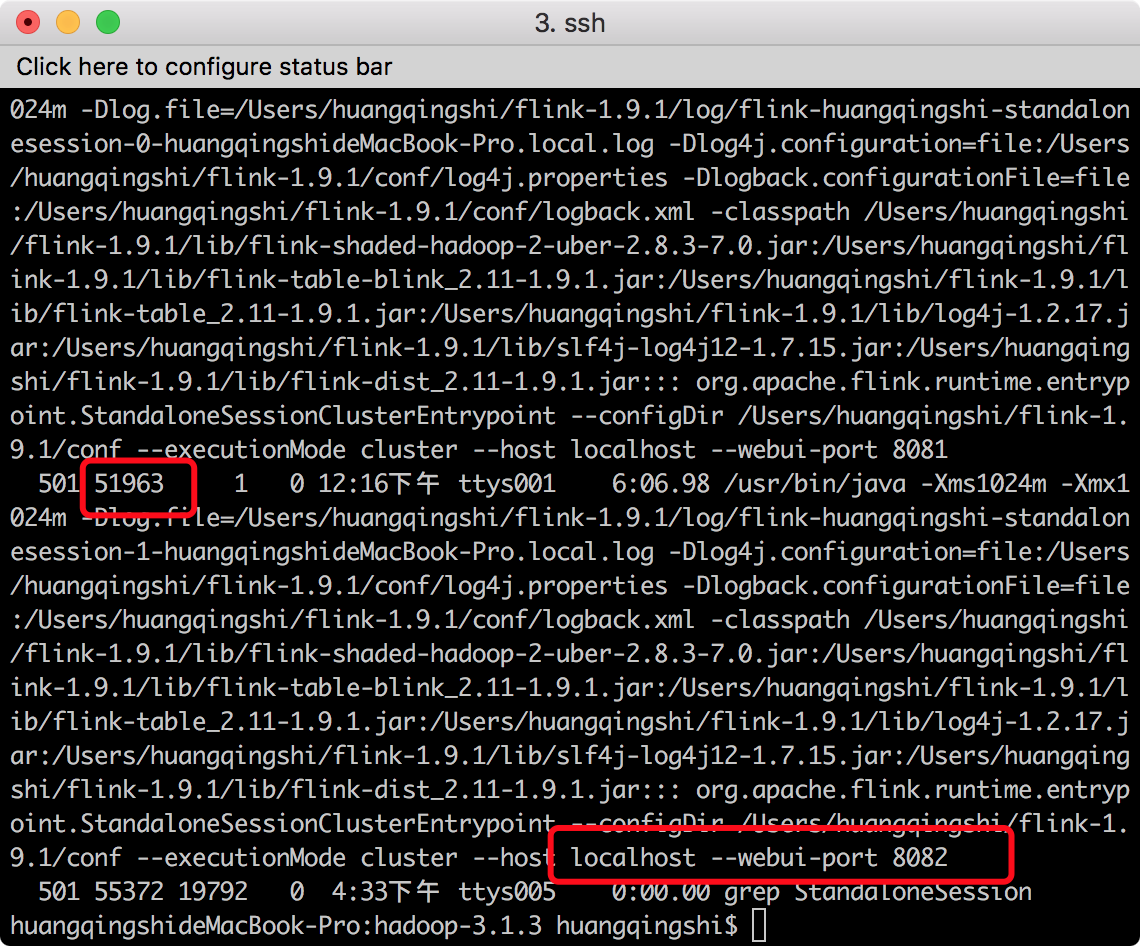
我们将其kill掉,执行命令kill -9 51963,此时在访问localhost:8082 就不能访问了。localhost:8081 还可以访问,还可以提供服务。接下来咱们重新 启动flink的JobManager 8082 端口。
bin/jobmanager.sh start localhost
此时8081已经成为leader了,继续提供高可用的HA了。

好了,到此就算搭建完成了。
搭建高可用的flink JobManager HA的更多相关文章
- Nginx+Keepalived(双机热备)搭建高可用负载均衡环境(HA)
原文:https://my.oschina.net/xshuai/blog/917097 摘要: Nginx+Keepalived搭建高可用负载均衡环境(HA) http://blog.csdn.ne ...
- Nginx+Keepalived(双机热备)搭建高可用负载均衡环境(HA)-转帖篇
原文:https://my.oschina.net/xshuai/blog/917097 摘要: Nginx+Keepalived搭建高可用负载均衡环境(HA) http://blog.csdn.ne ...
- 通过LVS+Keepalived搭建高可用的负载均衡集群系统
1. 安装LVS软件 (1)安装前准备操作系统:统一采用Centos6.5版本,地址规划如下: 服务器名 IP地址 网关 虚拟设备名 虚拟ip Director Server 192.168 ...
- keepalived工作原理和配置说明 腾讯云VPC内通过keepalived搭建高可用主备集群
keepalived工作原理和配置说明 腾讯云VPC内通过keepalived搭建高可用主备集群 内网路由都用mac地址 一个mac地址绑定多个ip一个网卡只能一个mac地址,而且mac地址无法改,但 ...
- 搭建高可用mongodb集群(四)—— 分片(经典)
转自:http://www.lanceyan.com/tech/arch/mongodb_shard1.html 按照上一节中<搭建高可用mongodb集群(三)-- 深入副本集>搭建后还 ...
- [转]搭建高可用mongodb集群(四)—— 分片
按照上一节中<搭建高可用mongodb集群(三)—— 深入副本集>搭建后还有两个问题没有解决: 从节点每个上面的数据都是对数据库全量拷贝,从节点压力会不会过大? 数据压力大到机器支撑不了的 ...
- [转]搭建高可用mongodb集群(二)—— 副本集
在上一篇文章<搭建高可用MongoDB集群(一)——配置MongoDB> 提到了几个问题还没有解决. 主节点挂了能否自动切换连接?目前需要手工切换. 主节点的读写压力过大如何解决? 从节点 ...
- 搭建高可用mongodb集群(四)—— 分片
按照上一节中<搭建高可用mongodb集群(三)—— 深入副本集>搭建后还有两个问题没有解决: 从节点每个上面的数据都是对数据库全量拷贝,从节点压力会不会过大? 数据压力大到机器支撑不了的 ...
- 搭建高可用mongodb集群(三)—— 深入副本集内部机制
在上一篇文章<搭建高可用mongodb集群(二)—— 副本集> 介绍了副本集的配置,这篇文章深入研究一下副本集的内部机制.还是带着副本集的问题来看吧! 副本集故障转移,主节点是如何选举的? ...
随机推荐
- HLSL效果框架-多光源效果
原文:HLSL效果框架-多光源效果 昨日不可追, 今日尤可为.勤奋,炽诚,不忘初心 手机淘宝二维码 扫描 或者打开连接:程序设计开发 ,掌声鼓励,欢迎光临. 高级着色器语言(HLS ...
- BKDRhash
哈希: 字符串(数字同理): 例如有100000个字符串,现在要插入一些字符串,插入前比较是否已经存在避免含有重复数据 用暴力计较的话会比较慢,在某字符串插入时,最好的情况是在第一个位置就遇见该字符 ...
- javax.websocket.Session的一个close异常记录
一刷新页面就报错如下: Connection closed 四月 10, 2018 11:20:18 上午 org.apache.tomcat.websocket.pojo.PojoEndpointB ...
- oracle函数 sysdate
[功能]:返回当前日期. [参数]:没有参数,没有括号 [返回]:日期 [示例]select sysdate hz from dual; 返回:2008-11-5
- part11.2-LED驱动设计
- 详解TableStore模糊查询——以订单场景为例
背景 订单系统在各行各业中广泛应用,为消费者.商家后台.促销系统等第三方提供用户.产品.订单等多维度的管理和查询服务.为了挖掘出海量订单数据的潜能,丰富高效的查询必不可少.然而很多时候并不能给出完整准 ...
- laravel 实现微博第三方登陆
https://blog.csdn.net/a12541254/article/details/79415550 1.安装 composer require socialiteproviders/we ...
- vue1——vue引入方法,npm本地安装
博客地址 :https://www.cnblogs.com/sandraryan/ Vue.js(读音 /vjuː/, 类似于 view) 是一套构建用户界面的渐进式框架.Vue 只关注视图层, 采用 ...
- 读取hive的表结构,生成带comment的视图建表语句
### 读取hive的表结构,生成带comment的视图建表语句 # 读取配置文件中的表并进行遍历 grep -v '^#' tablesFile|while read tableName do st ...
- 使用基于Apache Spark的随机森林方法预测贷款风险
使用基于Apache Spark的随机森林方法预测贷款风险 原文:Predicting Loan Credit Risk using Apache Spark Machine Learning R ...