
最简单之安装hadoop单机版
一,hadoop下载
(前提:先安装java环境)
下载地址:http://hadoop.apache.org/releases.html(注意是binary文件,source那个是源码)
二,解压配置
tar xzvf hadoop-2.10..tar.gz

[root@--- hadoop-2.10.]# echo $JAVA_HOME

/usr/java/jdk1..0_231-amd64

[root@--- hadoop-2.10.]# vi /home/hadoop-2.10./etc/hadoop/hadoop-env.sh

export JAVA_HOME=/usr/java/jdk1..0_231-amd64
[root@192-168-22-220 hadoop-2.10.0]# vi /home/hadoop-2.10.0/etc/hadoop/yarn-env.sh
export JAVA_HOME=/usr/java/jdk1.8.0_231-amd64
[root@--- hadoop-2.10.]# hostname

---

[root@--- ~]# mkdir /home/hadoop-2.10./tmp

[root@--- ~]# vi /home/hadoop-2.10./etc/hadoop/core-site.xml

<configuration>

    <!-- 指定HDFS老大(namenode)的通信地址 -->

    <property>

        <name>fs.defaultFS</name>

        <value>hdfs://localhost:9000</value>

    </property>

    <!-- 指定hadoop运行时产生文件的存储路径 -->

    <property>

        <name>hadoop.tmp.dir</name>

        <value>/home/hadoop-2.10./tmp</value>

    </property>

</configuration>
[root@--- hadoop-2.10.]# mkdir /home/hadoop-2.10./hdfs

[root@--- hadoop-2.10.]# mkdir /home/hadoop-2.10./hdfs/name

[root@--- hadoop-2.10.]# mkdir /home/hadoop-2.10./hdfs/data

[root@--- hadoop-2.10.]# vi /home/hadoop-2.10./etc/hadoop/hdfs-site.xml

<configuration>

<property>

    <name>dfs.name.dir</name>

    <value>/home/hadoop-2.10./hdfs/name</value>

    <description>namenode上存储hdfs名字空间元数据 </description>

</property>

<property>

    <name>dfs.data.dir</name>

    <value>/home/hadoop-2.10./hdfs/data</value>

    <description>datanode上数据块的物理存储位置</description>

</property>

<property>

    <name>dfs.replication</name>

    <value></value>

    <description>副本个数,配置默认是3,应小于datanode机器数量</description>

</property>

</configuration>
[root@--- hadoop]# cp mapred-site.xml.template mapred-site.xml

[root@--- hadoop]# vi /home/hadoop-2.10./etc/hadoop/mapred-site.xml

<configuration>

    <!-- 通知框架MR使用YARN -->

    <property>

        <name>mapreduce.framework.name</name>

        <value>yarn</value>

    </property>

</configuration>
[root@--- hadoop]#vi /home/hadoop-2.10./etc/hadoop/yarn-site.xml

<configuration>

    <!-- reducer取数据的方式是mapreduce_shuffle -->

    <property>

        <name>yarn.nodemanager.aux-services</name>

        <value>mapreduce_shuffle</value>

    </property>

</configuration>
三,环境变量
vi /etc/profile

export HADOOP_HOME=/home/hadoop-2.10.0

export PATH=$PATH:$HADOOP_HOME/bin

source /etc/profile
四,免密登陆
ssh-keygen -t dsa -P '' -f ~/.ssh/id_dsa

cat ~/.ssh/id_dsa.pub >> ~/.ssh/authorized_keys

chmod  ~/.ssh/authorized_keys
五,第一次先格式化hdfs
[root@--- hadoop-2.10.]# pwd

/home/hadoop-2.10.

[root@--- hadoop-2.10.]# ./bin/hdfs namenode -format  #或者 hadoop namenode -format
六,启动hdfs
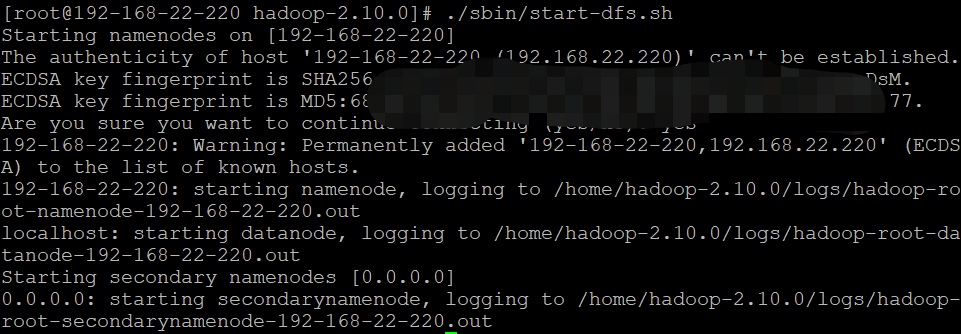
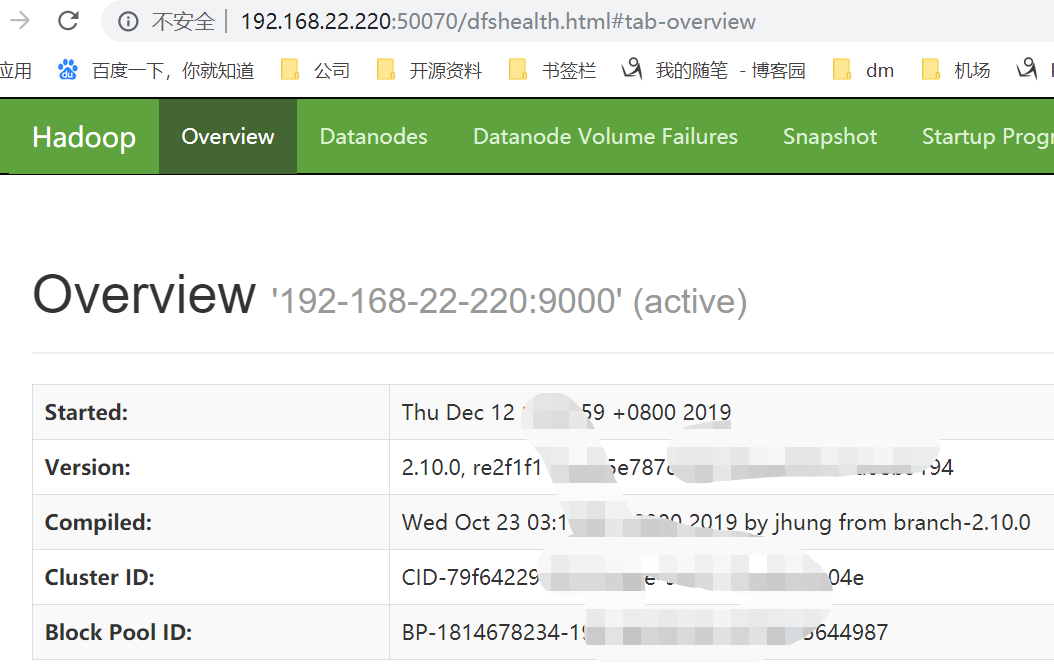
./sbin/start-dfs.sh  #启动命令

./sbin/stop-dfs.sh   #停止命令
七,启动yarn
[root@--- hadoop-2.10.]# pwd

/home/hadoop-2.10.

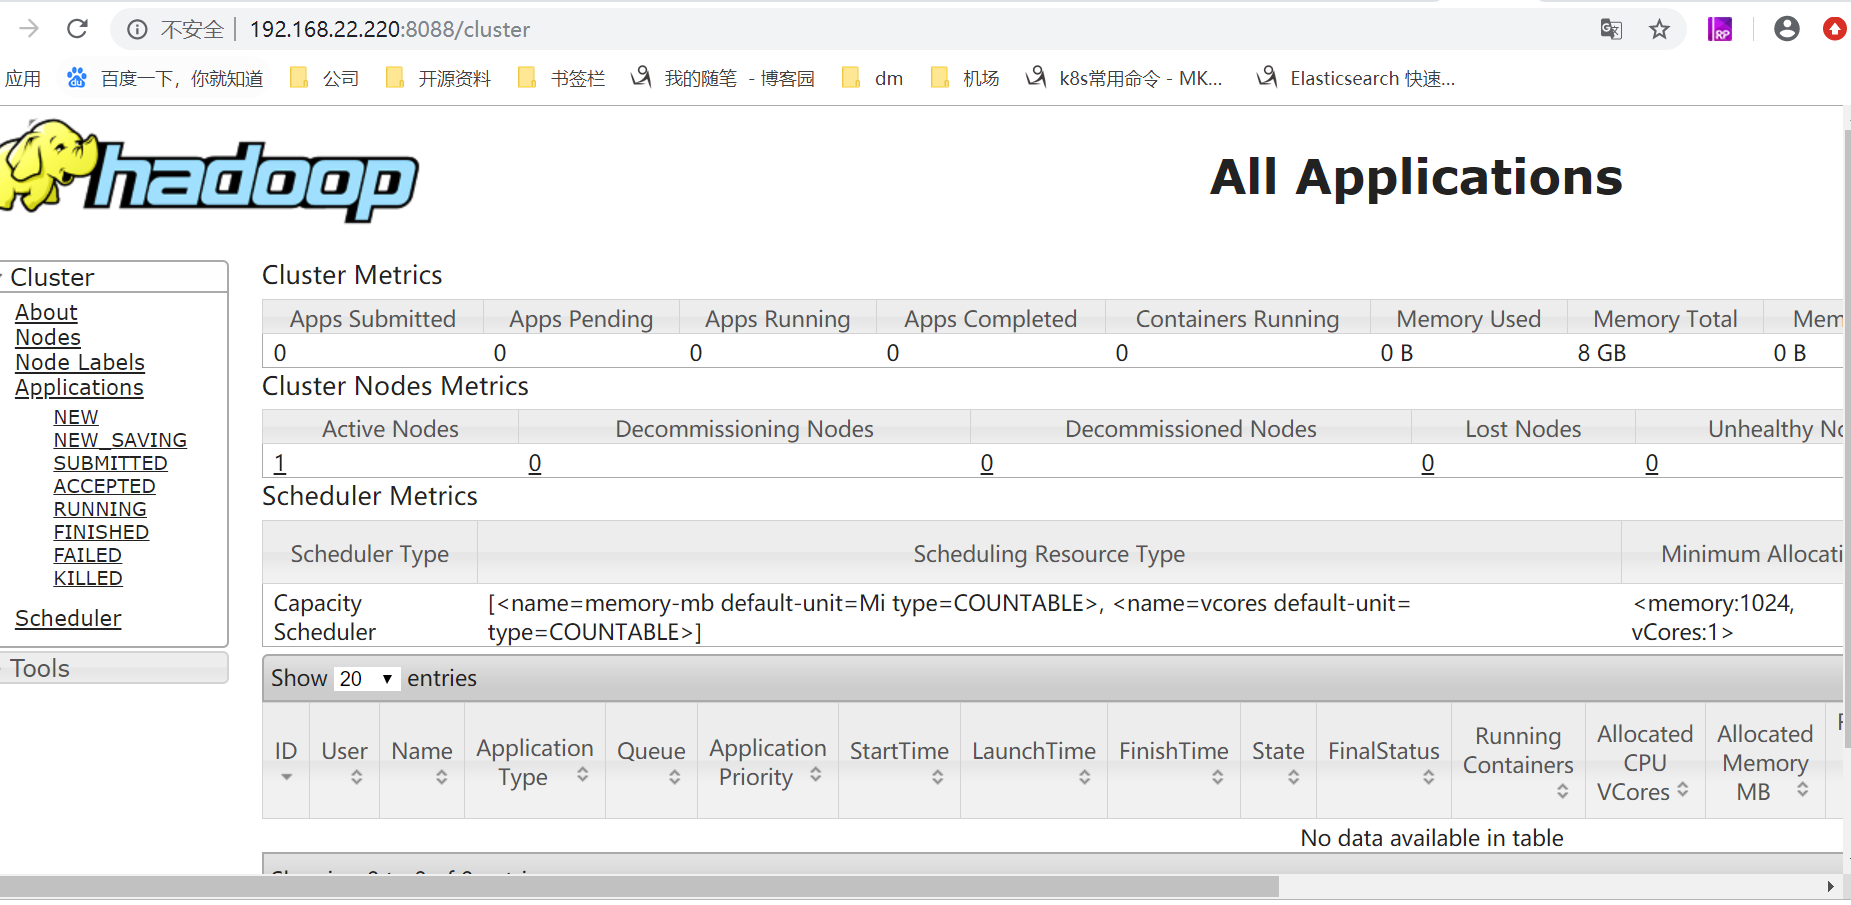
[root@--- hadoop-2.10.]# ./sbin/start-yarn.sh            # 关闭命令:./sbin/stop-yarn.sh

starting yarn daemons

resourcemanager running as process . Stop it first.

localhost: starting nodemanager, logging to /home/hadoop-2.10./logs/yarn-root-n
odemanager----.out

[root@--- hadoop-2.10.]# jps

 NameNode

 ResourceManager

 Jps

 DataNode

 SecondaryNameNode

 NodeManager
八,批量启动和停止
[root@--- hadoop-2.10.]# ./sbin/stop-all.sh

This script is Deprecated. Instead use stop-dfs.sh and stop-yarn.sh

Stopping namenodes on [---]

---: stopping namenode

localhost: stopping datanode

Stopping secondary namenodes [0.0.0.0]

0.0.0.0: stopping secondarynamenode

stopping yarn daemons

stopping resourcemanager

localhost: stopping nodemanager

localhost: nodemanager did not stop gracefully after  seconds: killing with kill -

no proxyserver to stop

[root@--- hadoop-2.10.]# ./sbin/start-all.sh

This script is Deprecated. Instead use start-dfs.sh and start-yarn.sh

Starting namenodes on [---]

---: starting namenode, logging to /home/hadoop-2.10./logs/hadoop-root-namenode----.out

localhost: starting datanode, logging to /home/hadoop-2.10./logs/hadoop-root-datanode----.out

Starting secondary namenodes [0.0.0.0]

0.0.0.0: starting secondarynamenode, logging to /home/hadoop-2.10./logs/hadoop-root-secondarynamenode----.out

starting yarn daemons

starting resourcemanager, logging to /home/hadoop-2.10./logs/yarn-root-resourcemanager----.out

localhost: starting nodemanager, logging to /home/hadoop-2.10./logs/yarn-root-nodemanager----.out
最简单之安装hadoop单机版的更多相关文章
- ambari快速安装hadoop
资源下载http://www.cnblogs.com/bfmq/p/6027202.html 大家都知道hadoop包含很多的组件,虽然很多都是下载后解压简单配置下就可以用的,但是还是耐不住我是一个懒 ...
- Hadoop单机版安装,配置,运行
Hadoop是最近非常流行的东东啦,但是乍一看都觉得是集群的东东,其实在单机版上安装Hadoop也是可以的,并且安装好以后可以很方便的进行程序的调试,调试好程序以后再丢到集群中,放心的算吧,呵呵.. ...
- hadoop单机版安装及基本功能演示
本文所使用的Linux发行版本为:CentOS Linux release 7.4.1708 (Core) hadoop单机版安装 准备工作 创建用户 useradd -m hadoop passwd ...
- CentOS下安装hadoop
CentOS下安装hadoop 用户配置 添加用户 adduser hadoop passwd hadoop 权限配置 chmod u+w /etc/sudoers vi /etc/sudoers 在 ...
- Linux下安装Hadoop完全分布式(Ubuntu12.10)
Hadoop的安装非常简单,可以在官网上下载到最近的几个版本,最好使用稳定版.本例在3台机器集群安装.hadoop版本如下: 工具/原料 hadoop-0.20.2.tar.gz Ubuntu12.1 ...
- Ubuntu安装Hadoop与Spark
更新apt 用 hadoop 用户登录后,我们先更新一下 apt,后续我们使用 apt 安装软件,如果没更新可能有一些软件安装不了.按 ctrl+alt+t 打开终端窗口,执行如下命令: sudo a ...
- 在Ubuntu上单机安装Hadoop
最近大数据比较火,所以也想学习一下,所以在虚拟机安装Ubuntu Server,然后安装Hadoop. 以下是安装步骤: 1. 安装Java 如果是新机器,默认没有安装java,运行java –ver ...
- [Hadoop]如何安装Hadoop
Hadoop是一个分布式系统基础架构,他使得用户可以在不了解分布式底层细节的情况下,开发分布式程序. Hadoop的重要核心:HDFS和MapReduce.HDFS负责储存,MapReduce负责计算 ...
- Ubuntu 安装hadoop 伪分布式
一.安装JDK : http://www.cnblogs.com/E-star/p/4437788.html 二.配置SSH免密码登录1.安装所需软件 sudo apt-get ins ...
随机推荐
- 深入理解C语言-二级指针三种内存模型
二级指针相对于一级指针,显得更难,难在于指针和数组的混合,定义不同类型的二级指针,在使用的时候有着很大的区别 第一种内存模型char *arr[] 若有如下定义 char *arr[] = {&quo ...
- js单击事件
<script type="text/javascript"> // 根据ID获取元素,得到按钮[注册] var elbtn=document.getElementBy ...
- canal原理&部署
原理: https://www.jianshu.com/p/87944efe1005 部署: https://www.cnblogs.com/janes/p/9318576.html https:// ...
- python调用hanlp进行命名实体识别
本文分享自 6丁一的猫 的博客,主要是python调用hanlp进行命名实体识别的方法介绍.以下为分享的全文. 1.python与jdk版本位数一致 2.pip install jpype1(pyth ...
- 查看Oracle索引是否被使用或者有效
第一步: explain plan for select * from T_USER where OPEN_ID='12345'; 第二步: select * from table(dbms_xpla ...
- 解决连接HIS连接不上数据库的问题
运行程序单步运行,设置断点 配置HIS中的 GetDataBaseInfo类,将与本机无关的配置函数全部删除,(按照DMHospital.ini文件来对照修改),如下图: 往数据库中所创建的表中添加数 ...
- 从入门到自闭之Python--RESTful API规范与序列化
RESTful API规范 REST全称是Representational State Transfer,中文意思是表述(编者注:通常译为表征)性状态转移. 它首次出现在2000年Roy Fieldi ...
- Elastic Search中Query String常见语法
1 搜索所有数据timeout参数:是超时时长定义.代表每个节点上的每个shard执行搜索时最多耗时多久.不会影响响应的正常返回.只会影响返回响应中的数据数量.如:索引a中,有10亿数据.存储在5个s ...
- url编码问题小计
昨天通过get访问服务器遇到了服务器获取不到参数的问题,最后排查下来是因为url编码的原因,之前使用的是字符串拼接,所以有一些特殊字符如‘%’没有正确的编码, 通过改成各个部分编码,正确获取到数据. ...
- 使用Iview时候 报:no-parsing-error Parsing error: x-invalid-end-tag 解决办法
解决办法有两种解决办法: 1.MenuItem修改为:menu-item 2.在根目录下 .eslintrc.js 文件 rules 下添加: "vue/no-parsing-error&q ...