
爬虫之解析库BeautifulSoup
介绍
Beautiful Soup是python的一个库,最主要的功能是从网页抓取数据。官方解释如下:
Beautiful Soup提供一些简单的、python式的函数用来处理导航、搜索、修改分析树等功能。它是一个工具箱,通过解析文档为用户提供需要抓取的数据,因为简单,所以不需要多少代码就可以写出一个完整的应用程序。

Beautiful Soup自动将输入文档转换为Unicode编码,输出文档转换为utf-8编码。你不需要考虑编码方式,除非文档没有指定一个编码方式,这时,Beautiful Soup就不能自动识别编码方式了。然后,你仅仅需要说明一下原始编码方式就可以了。

Beautiful Soup已成为和lxml、html6lib一样出色的python解释器,为用户灵活地提供不同的解析策略或强劲的速度。
使用方法
(1) 根据标签名查找

    - suop.a 只能找到第一个符合要求的标签

(2) 获取属性值

    - suop.a.attrs         获取a所有的属性和属性值,返回一个字典

    - suop.a.attrs["href"] 获取href属性值

    - suop.a["href"]       简写为这种形式

(3) 获取内容

    - suop.a.string        获取标签中直系的文本内容

    - suop.a.text          获取所有标签中的文本内容

    - suop.a.get_text()    获取所有标签中的文本内容

   【注意】如果标签中还有标签,那么string获取到的结果为None,其他两个方法可以获取到文本内容

(4) find 找到第一个符合要求的标签

    - suop.find("a")       找到第一个符合要求的

    # 根据标签中的属性获取指定的a标签

    - suop.find("a", class_="xxx")  # class是关键字需要加_

    - suop.find("a", id="xxx")

    - suop.find("a", href="xxx")

    - suop.find("a", alt="xxx")

    - suop.find("a", tetle="xxx")

    # 可以和获取内容的方法连用

    - suop.find("a",href="/hecheng/27.html").text

(5) find_all 找到所有符合要求的标签

    - suop.find_all("a")

    - suop.find_all(["a","p"])  找到所有a标签和p标签

    - suop.find_all(["a","p"],limit=2)   取前两个

(6) 根据选择器选择指定的内容

    select:suop.select("#id")

    - 常见的选择器:标签选择器(a)|类选择器(.)|id选择器(#)|层级选择器

    - 层级选择器:

        div .mm         div下面所有class属性值为mm的,子子孙孙,下面多级

        div > .dd       div儿子级class属性为dd的,下面一级

    【注意】查询到的是所有数据,返回列表
项目演示
import requests

import lxml

from bs4 import BeautifulSoup

url = "http://www.shicimingju.com/book/sanguoyanyi.html"

response = requests.get(url).text

suop = BeautifulSoup(response,'lxml') # 实例化对象,使用lxml进行解析

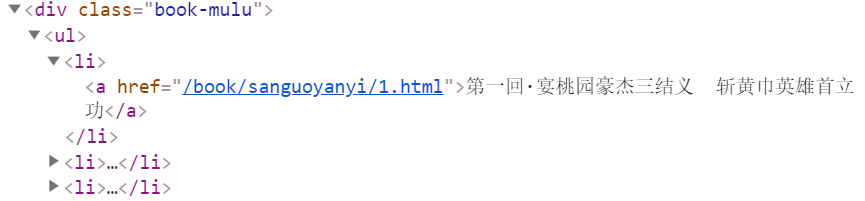
a_list = suop.select('.book-mulu > ul > li > a')

url = "http://www.shicimingju.com"

for a in a_list:

    fiction_name = a.string   # 小说章节名称

    fiction_url = url+a["href"]  # 小说章节url地址

    response = requests.get(fiction_url).text  # 请求每个章节的url地址

    suop = BeautifulSoup(response,'lxml')

    content = suop.find("div",class_="chapter_content").text  # 获取标签内所有文本数据

    with open("./{}.txt".format(fiction_name),"w",encoding="utf-8") as fp:

        fp.write(content)

print("下载成功!!!")
select选择器选择a标签中的文本内容和gref属性
效果

爬虫之解析库BeautifulSoup的更多相关文章
- Python爬虫【解析库之beautifulsoup】
解析库的安装 pip3 install beautifulsoup4 初始化 BeautifulSoup(str,"解析库") from bs4 import BeautifulS ...
- 爬虫解析库——BeautifulSoup
解析库就是在爬虫时自己制定一个规则,帮助我们抓取想要的内容时用的.常用的解析库有re模块的正则.beautifulsoup.pyquery等等.正则完全可以帮我们匹配到我们想要住区的内容,但正则比较麻 ...
- 爬虫----爬虫解析库Beautifulsoup模块
一:介绍 Beautiful Soup 是一个可以从HTML或XML文件中提取数据的Python库.它能够通过你喜欢的转换器实现惯用的文档导航,查找,修改文档的方式.Beautiful Soup会帮你 ...
- 爬虫之解析库-----re、beautifulsoup、pyquery
一.介绍 Beautiful Soup 是一个可以从HTML或XML文件中提取数据的Python库.它能够通过你喜欢的转换器实现惯用的文档导航,查找,修改文档的方式.Beautiful Soup会帮你 ...
- 爬虫解析库BeautifulSoup的一些笔记
BeautifulSoup类使用 基本元素 说明 Tag 标签,最基本的信息组织单元,分别是<>和</>标明开头和结尾 Name 标签的名字,<p></p ...
- 爬虫解析库beautifulsoup
一.介绍 Beautiful Soup是一个可以从HTML或XML文件中提取数据的python库. #安装Beautiful Soup pip install beautifulsoup4 #安装解析 ...
- python爬虫数据解析之BeautifulSoup
BeautifulSoup是一个可以从HTML或者XML文件中提取数据的python库.它能够通过你喜欢的转换器实现惯用的文档导航,查找,修改文档的方式. BeautfulSoup是python爬虫三 ...
- python爬虫之解析库Beautiful Soup
为何要用Beautiful Soup Beautiful Soup是一个可以从HTML或XML文件中提取数据的Python库.它能够通过你喜欢的转换器实现惯用的文档导航,查找,修改文档的方式, 是一个 ...
- 解析库beautifulsoup
目录 一.介绍 二.遍历文档树 三.搜索文档树(过滤) 四.修改文档树 五.总结 一.介绍 Beautiful Soup 是一个可以从HTML或XML文件中提取数据的Python库.它能够通过你喜欢的 ...
随机推荐
- Mysql的实现原理
上篇文章已经简单介绍了Mysql索引的基本介绍,这篇文章主要讲解一下所以的实现原理.索引的定义其实非常复杂,严格的定义需要用到关系代数的概念,不在咱们讨论范围内,这里咱们只讨论mysql的常用的引擎的 ...
- luogu2657-Windy数题解--数位DP
题目链接 https://www.luogu.org/problemnew/show/P2657 分析 第一道数位DP题,发现有点意思 DP求\([L,R]\)区间内的XXX个数,很套路地想到前缀和, ...
- C# 哥德巴赫猜想的实现方式 region分区编写
using System;using System.Collections.Generic;using System.Linq;using System.Text;using System.Threa ...
- MysqL之数值函数
1.CEIL() 用法:向上取整 举例: mysql> select CEIL(3.5); +-----------+ | CEIL(3.5) | +-----------+ | +------ ...
- Linux命令——netstat
参考:20 Netstat Commands for Linux Network Management Foreword Print network connections, routing tabl ...
- KVM虚拟机高级设置——08 管理远程虚拟机
在搭建KVM环境——07 带GUI的Linux上安装KVM图形界面管理工具介绍了KVM图形化管理工具,这款工具除了可以管理本地KVM虚拟外,还可以管理远程KVM虚拟机. 输入113机器密码 输入yes ...
- MySQL数据库的基本认识与操作
Mysql是一个数据库,但是我们安装的mysql数据库服务,服务就会有状态,启动,停止,重启.我们使用mysql必须保证mysql启动. 使用mysql数据库需要连接数据库 Mysql -u -p - ...
- k2系列-安装篇
K2介绍: K2是基于BPM的流程开发平台,它支持在net开发环境/visio/moss等不同环境下进行流程开发. K2本身部署简单,操作灵活,非常适合大中型企业流程开发和部署. K2安装步骤: 首先 ...
- css一个元素垂直居中的6种方法
方法一: <!DOCTYPE html> <html> <head> <meta charset="UTF-8"> <titl ...
- TCP的服务简单介绍
1 引言尽管T C P和U D P都使用相同的网络层(I P),T C P却向应用层提供与U D P完全不同的服务.T C P提供一种面向连接的.可靠的字节流服务.面向连接意味着两个使用 T C P的 ...