
Node.js 爬虫爬取电影信息
Node.js 爬虫爬取电影信息
我的CSDN地址:https://blog.csdn.net/weixin_45580251/article/details/107669713
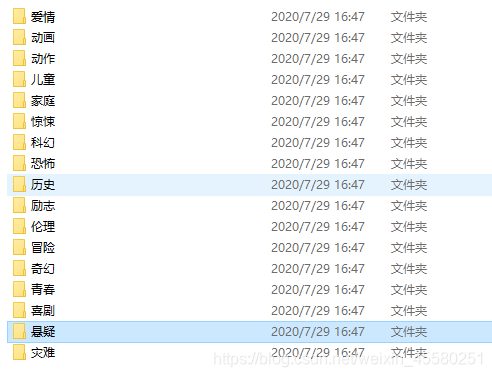
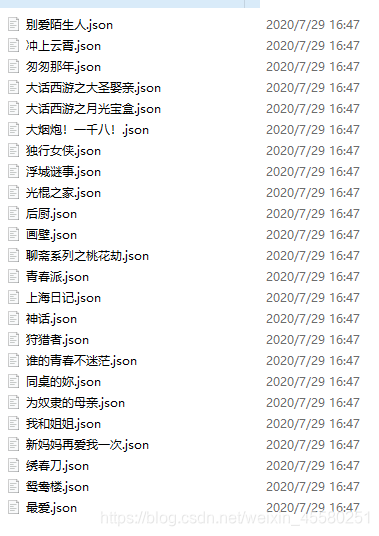
爬取的是1905电影网的信息,使用的是正则匹配。
本来为了更好地学习异步编程打好基础,没想到这玩意这么上头。
代码也写了好几天,自己技术不到家,肯定有写的不好的地方,还需要多努力。
下个月争取把vue学完,九月估计该开学了。
代码在最下面
const request=require('request');

const url="https://www.1905.com/vod/list/n_1/o3p1.html";

const fs=require('fs');

const { resolve } = require('path');

function req(url){

    return new Promise((resolve,reject)=>{

        request.get(url,(err,response,body)=>{

            if(err) reject(err)

            else resolve({response,body});

        })

    })

}

//获取起始界面的所有分类地址

async function getClassUrl(){

    let {response,body}=await req(url);

    // console.log(body);

    let reg1=/<span class="search-index-L">类型 :<\/span>(.*?)<div class="grid-12x">/igs;   //i不区分大小写 g全局 s让.匹配换行

    let result1=reg1.exec(body)[1];

    let reg2=/<a href="javascript\:void\(0\);" onclick="location\.href='(.*?)';return false;"(.*?)>(.*?)<\/a>/igs;

    let result2="";

    // console.log(reg2.exec(result1));

    let urlArr=[];

    while(result2=reg2.exec(result1)){

        if(result2[3]!="全部"){

            let obj={

                className:result2[3],

                url:result2[1]

            }

            urlArr.push(obj);

            fs.mkdir("./movies/"+result2[3],{ recursive: true },(err) => {

                    if (err) throw err;

                });

            getMovies(result2[1],result2[3]);

            // console.log(result2.index);

            // console.log(reg2.lastIndex);

        }

    }

    // console.log(urlArr.length);      //17个分类

};

//通过分类栏,获取页面中的电影连接

async function getMovies(url,className){

    let {response,body}=await req(url);

    let reg3=/<a class="pic-pack-outer" target="_blank" href="(.*?)".*?><img/igs;

    let result3="";

    let urlArr=[];

    while(result3=reg3.exec(body)){

        urlArr.push(result3[1]);

        getDate(result3[1],className);

    }

}

//对电影详情页进行分析

async function getDate(url,className){

    let {response,body}=await req(url);

    let reg1=/<h1 class="playerBox-info-name playerBox-info-cnName">(.*?)<\/h1>/;

    // let reg4=/<!-- 文字简介 -->.*?<span id="playerBoxIntroCon">(.*?)<a href="(.*?)" target="_blank" data-hrefexp="fr=vodplay_ypzl_xx">\.\.\.<span>[详细]/;

    let result1=reg1.exec(body);

    // console.log(result1[1]);

    let reg2=/<span id="playerBoxIntroCon">(.*?)<a href="(.*?)" /;

    let result2=reg2.exec(body);

    // console.log(result2[2]);

    writeFile(result1,result2,url,className);

}

//写入文件

async function writeFile(result1,result2,url,className){

    let movie={

        name:result1[1],

        brief:result2[1],

        url:url,

        details:result2[2]

    };

    let data=JSON.stringify(movie);

    fs.writeFile(`./movies/${className}/${movie.name}.json`,data,(err)=>{

        if (err) {return console.log(err)}

    });

    //下面的写入流写法也可以

    // let w = fs.createWriteStream(`./movies/${className}/${movie.name}.json`);

    // w.write(data,'utf-8');

    // w.end;

    // w.on('error', function(err){

    //     console.log(err.stack);

    //  });

};

getClassUrl();
Node.js 爬虫爬取电影信息的更多相关文章
- Node.js爬虫-爬取慕课网课程信息
第一次学习Node.js爬虫,所以这时一个简单的爬虫,Node.js的好处就是可以并发的执行 这个爬虫主要就是获取慕课网的课程信息,并把获得的信息存储到一个文件中,其中要用到cheerio库,它可以让 ...
- 养只爬虫当宠物(Node.js爬虫爬取58同城租房信息)
先上一个源代码吧. https://github.com/answershuto/Rental 欢迎指导交流. 效果图 搭建Node.js环境及启动服务 安装node以及npm,用express模块启 ...
- node.js爬虫爬取拉勾网职位信息
简介 用node.js写了一个简单的小爬虫,用来爬取拉勾网上的招聘信息,共爬取了北京.上海.广州.深圳.杭州.西安.成都7个城市的数据,分别以前端.PHP.java.c++.python.Androi ...
- 手把手教你用Node.js爬虫爬取网站数据
个人网站 https://iiter.cn 程序员导航站 开业啦,欢迎各位观众姥爷赏脸参观,如有意见或建议希望能够不吝赐教! 开始之前请先确保自己安装了Node.js环境,还没有安装的的童鞋请自行百度 ...
- node js 爬虫爬取静态页面,
先打一个简单的通用框子 //根据爬取网页的协议 引入对应的协议, http||https var http = require('https'); //引入cheerio 简单点讲就是node中的jq ...
- node:爬虫爬取网页图片
代码地址如下:http://www.demodashi.com/demo/13845.html 前言 周末自己在家闲着没事,刷着微信,玩着手机,发现自己的微信头像该换了,就去网上找了一下头像,看着图片 ...
- 一个简单python爬虫的实现——爬取电影信息
最近在学习网络爬虫,完成了一个比较简单的python网络爬虫.首先为什么要用爬虫爬取信息呢,当然是因为要比人去收集更高效. 网络爬虫,可以理解为自动帮你在网络上收集数据的机器人. 网络爬虫简单可以大致 ...
- Python多线程爬虫爬取电影天堂资源
最近花些时间学习了一下Python,并写了一个多线程的爬虫程序来获取电影天堂上资源的迅雷下载地址,代码已经上传到GitHub上了,需要的同学可以自行下载.刚开始学习python希望可以获得宝贵的意见. ...
- 用java编写爬虫爬取电影
一.爬取前提1)本地安装了mysql数据库2)安装了idea或者eclipse等开发工具 二.爬取内容 电影名称.电影简介.电影图片.电影下载链接 三.爬取逻辑1)进入电影网列表页, 针对列表的htm ...
随机推荐
- vm虚拟机设置共享文件夹不显示
1. 确认VMtools已经装好,开启共享文件夹,设置好共享目录 2.执行命令 sudo mount -t vmhgfs .host:/ /mnt/hgfs如果出现错误: Error: cannot ...
- html中object标签
首先将这个强大web页面打印例子(pintTest.html)贴上来. <!DOCTYPE HTML PUBLIC "-//W3C//DTD HTML 4.0 Transitional ...
- ASP.NET 获取客户端IP地址
我们用Request.ServerVariables( "REMOTE_ADDR ") 来取得客户端的IP地址, 但如果客户端是使用代理服务器来访问,那取到的就是代理服务器的I ...
- HTTP协议和APACHE
HTTP服务 超文本传输协议. 互联网上应用最广的一种服务. 是一种应用层协议. Internet 互联网表示把各个网连起来 ARPAnet军网 TCP/IP协议 开放的协议 互联互通 Interne ...
- Mysql JDBC-mysql-Driver queryTimeout分析
Mysql jdbc的queryTimeout分析 Mysql的jdbc-driver com.mysql.jdbc.Driver 设置queryTimeout方法 com.mysql.jdbc.St ...
- Java9系列第九篇-对HTTP2协议的支持与非阻塞HTTP-API
在HTTP/1.1 发布了16 年之后,IETF在2015年终于通过了HTTP/2 协议.HTTP/2协议旨在降低延迟,满足当今时代对于信息响应时间的要求.在这篇文章中,我会简要的对HTTP/2协议进 ...
- 【算法】二叉树、N叉树先序、中序、后序、BFS、DFS遍历的递归和迭代实现记录(Java版)
本文总结了刷LeetCode过程中,有关树的遍历的相关代码实现,包括了二叉树.N叉树先序.中序.后序.BFS.DFS遍历的递归和迭代实现.这也是解决树的遍历问题的固定套路. 一.二叉树的先序.中序.后 ...
- Vue、Node全栈项目~面向小白的博客系统~
个人博客系统 前言 ❝ 代码质量问题轻点喷(去年才学的前端),有啥建议欢迎联系我,联系方式见最下方,感谢! 页面有啥bug也可以反馈给我,感谢! 这是一套包含前后端代码的个人博客系统,欢迎各位提出建议 ...
- Miniconda 安装 & Pip module 安装 & Shell 脚本调用 Miniconda 虚拟环境手册(实战项目应用)
(实战项目应用) 1. 下载Miniconda 两个安装方式: 方式1:wget https://mirrors.tuna.tsinghua.edu.cn/anaconda/miniconda/Min ...
- 基于MVC的RESTFul风格API实战
基于MVC的RESTful风格的实现 1.RESTful风格阐述 REST服务是一种ROA(Resource-Oriented Architecture,面向资源的架构)应用.主要特点是方法信息存在于 ...