
链表vector
根据逻辑次序的复杂程度,大致可以将各种数据结构划分为线性结构、半线性结构与非线性结构三大类。
在线性结构中,各数据项按照一个线性次序构成一个整体。最为基本的线性结构统称为序列(sequence),根据其中数据项的逻辑次序与其物理存储地址的对应关系不同,又可进一步地将序列区分为向量(vector)和列表(list)。在向量中,所有数据项的物理存放位置与其逻辑次序完全吻合,此时的逻辑次序也称作秩(rank);而在列表中,逻辑上相邻的数据项在物理上未必相邻,而是采用间接定址的方式通过封装后的位置(position)相互引用。
- 向量结构的高效实现,包括其作为抽象数据类型的接口规范以及对应的算法,尤其是高效维护动态向量的技巧。
- 还将针对有序向量,系统介绍经典的查找与排序算法,并就其性能做一分析对比,这也是本章的重点与难点所在。
- 引入复杂度下界的概念,并通过建立比较树模型,针对基于比较式算法给出复杂度下界的统一界定方法。
一、数组:
若集合S由n个元素组成,且各元素之间具有一个线性次序,则可将它们存放于起始于地址A、物理位置连续的一段存储空间,并统称作数组(array),通常以A作为该数组的标识。对于任何0 < i < j < n,A[i]都是A[j]的前驱(predecessor),A[j]都是A[i]的后继(successor).,对于任何i >1,A[i - 1]称作A[i]的直接前驱(intermediate predecessor);对于任何i < n - 2,A[i + 1]称作A[i]的直接后继(intermediate successor)。任一元素的所有前驱构成其前缀(prefix),所有后继构成其后缀(suffix)。
若数组A[]存放空间的起始地址为A,且每个元素占用s个单位的空间,则元素A[i]对应的物理地址为:A + i * s因其中元素的物理地址与其下标之间满足这种线性关系,故亦称作线性数组(linear array).
二、向量
按照面向对象思想中的数据抽象原则,可对以上的数组结构做一般性推广,使得其以上特性更具普遍性。向量(vector)就是线性数组的一种抽象与泛化,它也是由具有线性次序的一组元素构成的集合V = { v0, v1, ..., vn-1 },其中的元素分别由秩相互区分。
各元素的秩(rank)互异,且均为[0, n)内的整数。具体地,若元素e的前驱元素共计r个,则其秩就是r。经如此抽象之后,我们不再限定同一向量中的各元素都属于同一基本类型,它们本身可以是来自于更具一般性的某一类的对象。另外,各元素也不见得同时具有某一数值属性,故而并不保证它们之间能够相互比较大小。
- 以下首先从向量最基本的接口出发,设计并实现与之对应的向量模板类。
- 然后在元素之间具有大小可比性的假设前提下,通过引入通用比较器或重载对应的操作符明确定义元素之间的大小判断依据,并强制要求它们按此次序排列,从而得到所谓有序向量。
- 介绍和分析此类向量的相关算法及其针对不同要求的各种实现版本。
2.1 ADT接口:

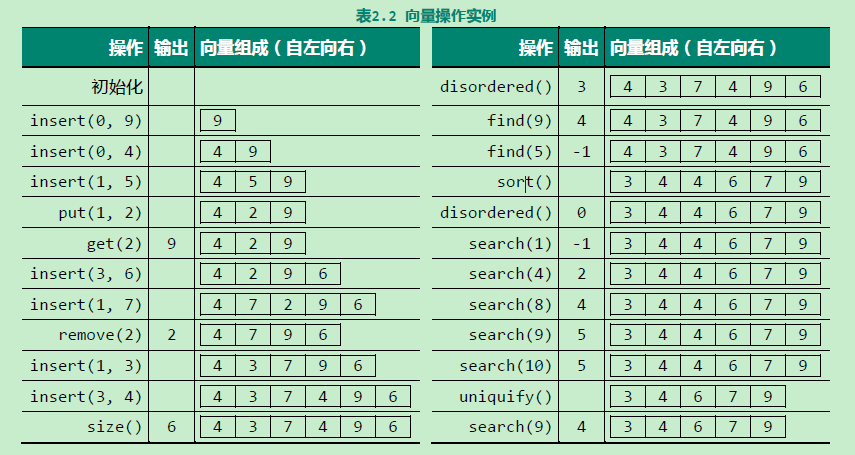
在引入秩的概念并将外部接口与内部实现分离之后,无论采用何种具体的方式,符合统一外部接口规范的任一实现均可直接地相互调用和集成。下表给出了一个整数向量从被创建开始,通过ADT接口依次实施一系列操作的过程。请留意观察,向量内部各元素秩的逐步变化过程。
typedef int Rank; //秩

#define DEFAULT_CAPACITY 3 //默讣癿刜始容量(实际应用中可讴置为更大)

template <typename T> class Vector { //向量模板类

protected:

  Rank _size; int _capacity; T* _elem; //规模、容量、数据区

  void copyFrom(T const* A, Rank lo, Rank hi); //复制数据区间A[lo,hi]

  void expand(); //空间时扩容

  void shrink(); //装填因子过小时压缩

  bool bubble(Rank lo, Rank hi); //扫描交换

  void bubbleSort(Rank lo, Rank hi); //起泡排序算法

  Rank max(Rank lo, Rank hi); //选取最大元素

  void selectionSort(Rank lo, Rank hi); //选择排序算法

  void merge(Rank lo, Rank mi, Rank hi); //归并算法

  void mergeSort(Rank lo, Rank hi); //归并排序算法

  Rank partition(Rank lo, Rank hi); //轴点构造算法

  void quickSort(Rank lo, Rank hi); //快速排序算法

  void heapSort(Rank lo, Rank hi); //堆排序(稍后结合完全堆讲解)

public:

//构造函数

Vector(int c = DEFAULT_CAPACITY, int s = , T v = ) //容量为c、规模为s、所有元素初始为v

  { _elem = new T[_capacity = c]; for (_size = ; _size < s; _elem[_size++] = v); } //s <= c 大小小于等于容量

Vector(T const* A, Rank lo, Rank hi) { copyFrom(A, lo, hi); } //数组区间复制

Vector(T const* A, Rank n) { copyFrom(A, , n); } //数组整体复制

Vector(Vector<T> const& V, Rank lo, Rank hi) { copyFrom(V._elem, lo, hi); } //向量区间复制

Vector(Vector<T> const& V) { copyFrom(V._elem, , V._size); } //向量整体复制

// 析构函数

~Vector() { delete [] _elem; } //释放内部空间

// 只读访问接口

Rank size() const { return _size; } //规模

bool empty() const { return !_size; } //判空

int disordered() const; //判断向量是否已经排序

Rank find(T const& e) const { return find(e, , _size); } //无序向量整体查找

Rank find(T const& e, Rank lo, Rank hi) const; //无序向量区间查找

Rank search(T const& e) const //有序向量整体查找

  { return ( >= _size) ? - : search(e, , _size); }

Rank search(T const& e, Rank lo, Rank hi) const; //有序向量区间查找

// 可写访问接口

T& operator[](Rank r) const; //重载下标操作符,可以类似亍数组形式引用各元素

Vector<T> & operator=(Vector<T> const&); //重载赋值操作符,以便直接克隆向量

T remove(Rank r); //初除秩为r的元素

int remove(Rank lo, Rank hi); //删除秩在区间[lo, hi)之内的元素

Rank insert(Rank r, T const& e); //插入元素

Rank insert(T const& e) { return insert(_size, e); } //默认作为末元素插入

void sort(Rank lo, Rank hi); //对[lo, hi)排序

void sort() { sort(, _size); } //整体排序

void unsort(Rank lo, Rank hi); //对[lo, hi)置乱
void unsort() { unsort(, _size); } //整体置乱

int deduplicate(); //无序去重

int uniquify(); //有序去重

// 遍历

void traverse(void (*)(T&)); //遍历(使用函数指针,只读或局部性修改)

template <typename VST> void traverse(VST&); //遍历(使用函数对象,可全局性修改)

}; //Vector
这里通过模板参数T,指定向量元素的类型。于是,以Vector<int>或Vector<float>之类的形式,可便捷地引入存放整数或浮点数的向量;而以Vector<Vector<char>>之类的形式,则可直接定义存放字符的二维向量等。这一技巧有利于提高数据结构选用的灵活性和运行效率,并减少出错,因此在本书中频繁使用。
2.2 构造与析构:

因此向量对象的构造与析构,将主要围绕这些私有变量和数据区的初始化与销毁展开。
2.2.1 默认构造方法
其中默认的构造方法是,首先根据创建者指定的初始容量,向系统申请空间,以创建内部私有数组_elem[];若容量未明确指定,则使用默认值DEFAULT_CAPACITY。接下来,鉴于初生的向量尚不包含任何元素,故将指示规模的变量_size初始化为0。
整个过程顺序进行,没有任何迭代,故若忽略用于分配数组空间的时间,共需常数时间。
2.2.2 基于复制的构造方法:
template <typename T> //元素类型
void Vector<T>::copyFrom(T const* A, Rank lo, Rank hi) { //以数组区间A[lo, hi)为蓝本复制向量

  _elem = new T[_capacity = 2 * (hi - lo)]; _size = 0; //分配空间,规模清零

  while (lo < hi) //A[lo, hi)内的元素逐一

  _elem[_size++] = A[lo++]; //复制到_elem[0, hi - lo)

}
copyFrom()首先根据待复制区间的边界,换算出新向量的初始规模;再以双倍的容量,为内部数组_elem[]申请空间。最后通过一趟迭代,完成区间A[lo, hi)内各元素的顺次复制。若忽略开辟新空间所需的时间,运行时间应正比于区间宽度,即O(hi - lo) = O(_size)
2.2.3重载的赋值运算符:
重载向量的赋值运算符如下:
template <typename T> Vector<T>& Vector<T>::operator=(Vector<T> const& V ) { //重载赋值操作符

  if (_elem)  delete [] _elem; //释放原有内容

  copyFrom(V._elem, , V.size()); //整体复刢

  return *this; //返回当前对象的引用,以便于链式赋值
}
2.2.4 析构函数:
与所有对象一样,不再需要的向量,应借助析构函数(destructor)及时清理(cleanup),以释放其占用的系统资源。与构造函数不同,同一对象只能有一个析构函数,不得重载。向量对象的析构过程,如代码2.1中的方法~Vector()所示:只需释放用于存放元素的内部数组_elem[],将其占用的空间交还操作系统。_capacity和_size之类的内部变量无需做任何处理,它们将作为向量对象自身的一部分被系统回收,此后既无需也无法被引用。
若不计系统用于空间回收的时间,整个析构过程只需O(1)时间。
同样地,向量中的元素可能不是程序语言直接支持的基本类型。比如,可能是指向动态分配对象的指针或引用,故在向量析构之前应该提前释放对应的空间。出于简化的考虑,这里约定并遵照“谁申请谁释放”的原则。究竟应释放掉向量各元素所指的对象,还是需要保留这些对象,以便通过其它指针继续引用它们,应由上层调用者负责确定。
2.3 动态空间管理:
向量实际规模与其内部数组容量的比值(即_size/_capacity),亦称作装填因子(loadfactor),它是衡量空间利用率的重要指标。如何保证向量的装填因子既不至于超过1,也不至于太接近0.需要改用动态空间管理策略。其中一种有效的方法,即使用所谓的可扩充向量。
2.3.1 可扩充向量:
扩充的原理如同金蝉脱壳,就动态地扩大内部数组的容量。这里的难点及关键在于:如何实现扩容?新的容量选取多少合适?一种可行的方法,如图2.1(c~e)所示。我们需要另行申请一个容量更大的数组B[](图(c)),并将原数组中的成员集体搬迁至新的空间(图(d)),此后方可顺利地插入新元素e而不致溢出(图(e))。当然,原数组所占的空间,需要及时释放并归还操作系统。

2.3.2 扩容:
基于以上策略的扩容算法expand(),可实现如下所示:
template <typename T> void Vector<T>::expand() { //向量空间丌足时扩容

  if (_size < _capacity) return; //尚未满员时,不必扩容

  if (_capacity < DEFAULT_CAPACITY) _capacity = DEFAULT_CAPACITY; //不低于最小容量

  T* oldElem = _elem; _elem = new T[_capacity <<= ]; //容量加倍 elem是一个指向新堆内存的指针了

  for (int i = ; i < _size; i++)

    _elem[i] = oldElem[i]; //复制原向量内容(T为基本类型,戒已重载赋值操作符'=')

  delete [] oldElem; //释放原空间

}
实际上,在调用insert()接口插入新元素之前,都要先调用该算法,检查内部数组的可用容量。一旦当前数据区已满(_size == _capacity),则将原数组替换为一个更大的数组。
这种情况下,若直接引用数组,往往会导致共同指向原数组的其它指针失效,成为野指针(wild pointer);而经封装为向量之后,即可继续准确地引用各元素,从而有效地避免野指针的风险。
2.3.2 分摊时间:
虽然每次扩容,就要把向量元素从当前内存复制到另一内存处,其时间复杂度为O(n),但这只是最坏情况下。
假定数组的初始容量为某一常数N。既然是估计复杂度的上界,故不妨设向量的初始规模也为N——即将溢出。另外不难看出,除插入操作外,向量其余的接口操作既不会直接导致溢出,也不会增加此后溢出的可能性,因此不妨考查最坏的情况,假设在此后需要连续地进行n次insert()操作,n >> N。首先定义如下函数:
size(n) = 连续插入n个元素后向量的规模

capacity(n) = 连续插入n个元素后数组的容量

T(n) = 为连续插入n个元素而花费于扩容的时间
其中,向量规模从N开始随着操作的进程逐步递增,故有:size(n) = N + n。既然不致溢出,故装填因子绝不会超过100%。同时,这里的扩容采用了“懒惰”策略——只有在的确即将发生溢出时,才不得不将容量加倍——因此装填因子也始终不低于50%。
概括起来始终有:
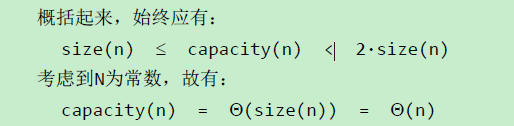
容量以2为比例按指数速度增长,在容量达到capacity(n)之前,共做过(log2n)次扩容,每次扩容所需时间线性正比于当时的容量(或规模),且同样以2为比例按指数速度增长。因此,消耗于扩容的时间累计不过:

将其分摊到其间的连续n次操作,单次操作所需的分摊运行时间应为O(1)。而其他追加固定数目单元的扩容方案,无论采用的固定常数是多大,在最坏情况下,此类数组单词操作的分摊时间复杂度都是O(n).
2.3.3 缩小容量:
当装填因子低于某一阈值时,我们称数组发生了下溢(underflow)。尽管下溢不属于必须解决的问题,但是在格外关注空间利用率的场合,发生下溢也有要必要的适当缩减内部数组容量。如下给出了一个动态缩容shrink()算法:
template <typename T> void Vector<T>::shrink() { //装填因子过小时压缩向量所占空间

  if (_capacity < DEFAULT_CAPACITY << ) return; //不至于收缩到DEFAULT_CAPACITY以下

  if (_size <<  > _capacity) return; //以25%为界 说明size不是很小 左移2位就是乘以4,4倍size是大于容量的

  T* oldElem = _elem; _elem = new T[_capacity >>= ]; //容量减半

  for (int i = ; i < _size; i++) _elem[i] = oldElem[i]; //复制原向量内容

  delete [] oldElem; //释放原空间

}
就单次扩容或缩容操作而言,所需时间的确会高达O(n),因此在对单次操作的执行速度极其敏感的应用场合以上策略并不适用,其中缩容操作甚至可以完全不予考虑。
2.4 常规向量:
2.4.1 直接引用元素(循秩访问):
在经过封装之后,对向量元素的访问可以沿用数组的方式,方法就是重载操作符"[]":T&代表是类型T的引用,使用它是因为返回值可以作为左值。
template <typename T> T& Vector<T>::operator[](Rank r) const //重载下标操作符

{ return _elem[r]; } // assert: 0 <= r < _size
2.4.2 置乱器:
经重载后操作符“[]”返回的是对数组元素的引用,这就意味着它既可以取代get()操作(通常作为赋值表达式的右值),也可以取代set()操作(通常作为左值)。例如,采用这
种形式,可以简明清晰地描述和实现如代码2.7所示的向量置乱算法。
template <typename T> void permute(Vector<T>& V) { //随机置乱向量,使各元素等概率出现亍殏一位置

  for (int i = V.size(); i > ; i--) //自后向前

  swap(V[i - ], V[rand() % i]); //V[i - 1]不V[0, i)中某一随机元素交换

}
该算法从待置乱区间的末元素开始,逆序地向前逐一处理各元素。对每一个当前元素V[i - 1],先通过调用rand()函数在[0, i)之间等概率地随机选取一个元素,再令二者互换位置。注意,这里的交换操作swap(),隐含了三次基于重载操作符“[]”的赋值。每经过一步这样的迭代,置乱区间都会向前拓展一个单元。因此经过O(n)步迭代之后,即实现了整个向量的置乱。
在软件测试、仿真模拟等应用中,随机向量的生成都是一项至关重要的基本操作,直接影响到测试的覆盖面或仿真的真实性。从理论上说,使用这里的算法permute(),不仅可以枚举出同一向量所有可能的排列,而且能够保证生成各种排列的概率均等。
将以上permute()算法封装至向量ADT中,对外提供向量的置乱操作接口Vector::unsort()。
template <typename T> void Vector<T>::unsort(Rank lo, Rank hi) { //等概率随机置乱向量匙间[lo, hi)

  T* V = _elem + lo; //将子向量_elem[lo, hi)规作另一向量V[0, hi - lo)

  for (Rank i = hi - lo; i > ; i--) //自后向前

  swap(V[i - ], V[rand() % i]); //将V[i - 1]不V[0, i)中某一元素随机交换

}
通过该接口,可以均匀地置乱任一向量区间[lo, hi)内的元素,故通用性有所提高。可见,只要将该区间等效地视作另一向量V,即可从形式上完整地套用以上permute()算法的流程。尽管如此,还请特别留意代码2.7与代码2.8的细微差异:后者是通过下标,直接访问内部数组的元素;而前者则是借助重载的操作符“[]”,通过秩间接地访问向量的元素。
从算法的角度来看,“判断两个对象是否相等”与“判断两个对象的相对大小”都是至关重要的操作,它们直接控制着算法执行的分支方向,因此也是算法的“灵魂”所在。在本书中为了以示区别,前者多称作“比对”操作,后者多称作“比较”操作。
算法实现的简洁性与通用性,在很大程度上体现于:针对整数等特定数据类型的某种实现,可否推广至可比较或可比对的任何数据类型,而不必关心如何定义以及判定其大小或相等关系。
若能如此,我们就可以将比对和比较操作的具体实现剥离出来,直接讨论算法流程本身。为此,通常可以采用两种方法。其一,将比对操作和比较操作分别封装成通用的判等器和比较器。其二,在定义对应的数据类型时,通过重载"<"和"=="之类的操作符,给出大小和相等关系的具体定义及其判别方法。
 template <typename T> static bool lt(T* a, T* b) { return lt(*a, *b); } //less than

 template <typename T> static bool lt(T& a, T& b) { return a < b; } //less than

 template <typename T> static bool eq(T* a, T* b) { return eq(*a, *b); } //equal

 template <typename T> static bool eq(T& a, T& b) { return a == b; } //equal
2.4.3 无序查找:
在无序向量中查找任意指定元素e时,因为没有更多的信息可以借助,故在最坏情况下,比如向量中并不包含e时,只有在访遍所有元素之后,才能得出查找结论。
因此不妨如图2.3所示,从末元素起自后向前,逐一取出各个元素并与目标元素e进行比对,直至发现与之相等者(查找成功),或者直至检查过所有元素之后仍未找到相等者(查找失败)。这种依次逐个比对的查找方式,称作顺序查找(sequential search)。
 template <typename T>

 Rank Vector<T>::find (T const &,Rank lo,Rank hi) const {

     while((lo < hi--))&&(e != _elem[hi]); //从后往前顺序查找

     return hi; //若hi < lo,则意味着失败,否则hi即命中元素的秩

 }
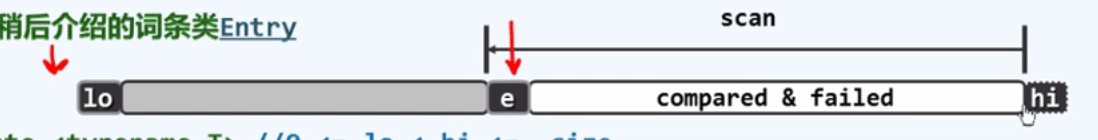
其中若干细微之处,需要体会。比如,当同时有多个命中元素时,本书统一约定返回其中秩最大者,稍后介绍的查找接口find()亦是如此故这里采用了自后向前的查找次序。如此,一旦命中即可立即返回,从而省略掉不必要的比对。另外,查找失败时约定统一返回-1。这不仅简化了对查找失败情况的判别,同时也使此时的返回结果更加易于理解,只要假想着在秩为-1处植入一个与任何对象都相等的哨兵元素,则返回该元素的秩当且仅当查找失败。最后还有一处需要留意。while循环的控制逻辑由两部分组成,首先判断是否已抵达通配符,再判断当前元素与目标元素是否相等。得益于C/C++语言中逻辑表达式的短路求值特性,在前一判断非真后循环会立即终止,而不致因试图引用已越界的秩(-1)而出错。
最坏情况下,查找终止于首元素_elem[lo],运行时间为O(hi - lo) = O(n)。最好情况下,查找命中于末元素_elem[hi - 1],仅需O(1)时间。对于规模相同、内部组成不同的输入,渐进运行时间却有本质区别,故此类算法也称作输入敏感的(input sensitive)算法。
2.4.4 插入:
插入操作insert(r, e)负责将任意给定的元素e插到任意指定的秩为r的单元。代码如下:
template <typename T> //将e作为秩为r元素插入

  Rank Vector<T>::insert(Rank r, T const& e) { //assert: 0 <= r <= size

  expand(); //若有必要,扩容

  for (int i = _size; i > r; i--) _elem[i] = _elem[i-]; //自后向前,后继元素依次后移一个单元

  _elem[r] = e; _size++; //置入新元素, 更新容量

  return r; //返回秩

}
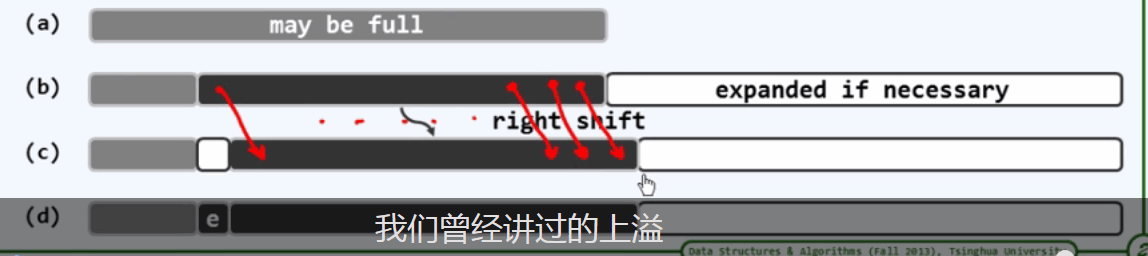
如果采用从r处移动,原向量中秩大于r的元素的都会被覆盖。就是只能从后往前移动。
插入之前必须首先调用expand()算法,核对是否即将溢出;若有必要,则加倍扩容。为保证数组元素物理地址连续的特性,随后需要将后缀_elem[r, _size)(如果非空)整体后移一个单元(图(c))。这些后继元素自后向前的搬迁次序不能颠倒,否则会因元素被覆盖
而造成数据丢失。在单元_elem[r]腾出之后,方可将待插入对象e置入其中。
复杂度:
时间主要消耗于后继元素的后移,线性正比于后缀的长度,故总体为O(_size - r + 1)。可见,新插入元素越靠后(前)所需时间越短(长)。特别地,r取最大值_size时为最好情况,只需O(1)时间;r取最小值0时为最坏情况,需要O(_size)时间。一般地,若插入位置等概率分布,则平均运行时间为O(_size) = O(n)(习题[2-9]),线性正比于向量的实际规模。
2.4.5 删除:
应将单元素删除视作区间删除的特例,并基于后者来实现前者。
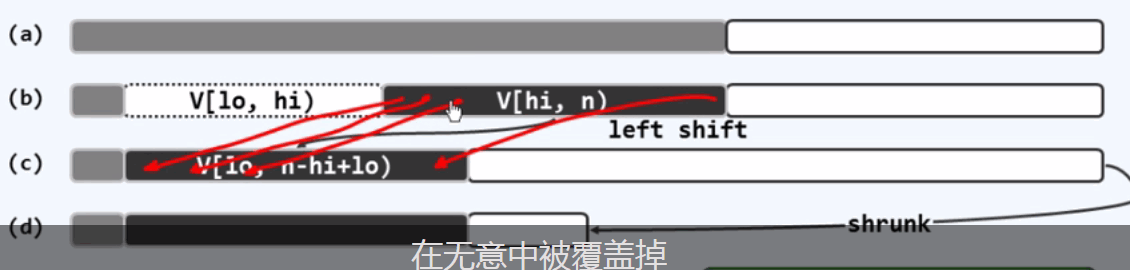
区间删除:romove(lo,hi)
template <typename T> int Vector<T>::remove(Rank lo, Rank hi) { //删除区间[lo, hi)
if (lo == hi) return ; //出校效率考虑,单独处理退化情况,比如remove(0, 0)
  while (hi < _size) _elem[lo++] = _elem[hi++]; //[hi, _size)依次前移hi - lo个单元

  _size = lo; //更新规模,直接丢弃尾部[lo, _size = hi)

  shrink(); //若有必要,则缩容

  return hi - lo; //返回被删除元素的数目
}
单个元素删除:romove(r)
将[r] = [ r , r+1)
 template <typename T> T Vector<T>::remove(Rank r) { //删除向量中秩为r的元素,0 <= r < size

 T e = _elem[r]; //备份被删除元素

 remove(r, r + ); //调用区间删除算法,等效亍对匙间[r, r + 1)的删除

 return e; //返回被删除元素

 }
复杂度:
remove(lo, hi)的计算成本,主要消耗于后续元素的前移,线性正比于后缀的长度,总体不过O(m + 1) = O(_size - hi + 1)。这与此前的预期完全吻合:区间删除操作所需的时间,应该仅取决于后继元素的数目,而与被删除区间本身的宽度无关。特别地,基于该接口实现的单元素删除接口remove(r)需耗时O(_size - r)。也就是说,被删除元素在向量中的位置越靠后(前)所需时间越短(长),最好为O(1),最坏为O(n) = O(_size)。
如果调用单元素删除来实现区间删除:那么就会实现

每删除一个,r的后继将整体前移一次,耗时为O(n),总共要删除n次。所以复杂度是O(n方)
2.4.6 唯一化(去除重复元素):
所谓向量的唯一化处理,就是剔除其中的重复元素,即表2.1所列deduplicate()接口的功能。
 template <typename T> int Vector<T>::deduplicate() { //剔除无序向量中重复元素(高效版)

 int oldSize = _size; //记录原规模

 Rank i = ; //从_elem[1]开始 从1号元素开始

 while (i < _size) //自前向后逐一考查各元素_elem[i]

   (find(_elem[i], , i) < ) ? i++ : remove(i); //在前缀中查找与i雷同的元素,若无雷同则继续查找其后继,否则删除雷同者

 return oldSize - _size;//向量规模变化,即被删除元素的综述
 }
挖掘算法的单调性和不变性:
不变性:
在当前V[i]的前缀v[0,i]中,各元素彼此互异。
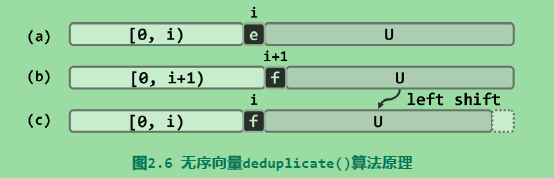
针对该元素的一步迭代之后,无非两种结果:
1)若元素e的前缀_elem[0, i)中不含与之雷同的元素,则如图(b),在做过i++之后,新的前缀_elem[0, i)将继续满足不变性,而且其规模增加一个单位。
2)反之,若含存在与e雷同的元素,则由此前一直满足的不变性可知,这样的雷同元素不超过一个。因此如图(c),在删除e之后,前缀_elem[0, i)依然保持不变性。
复杂度:
这里所需的时间,主要消耗于find()和remove()两个接口。根据2.5.4节的结论,前一部分时间应线性正比于查找区间的宽度,即前驱的总数;根据2.5.6节的结论,后一部分时间应线性正比于后继的总数。因此,每步迭代所需时间为O(n),总体复杂度应为O(n2)。
2.4.6 遍历:
在很多算法中,往往需要将向量作为一个整体,对其中所有元素实施某种统一的操作,比如输出向量中的所有元素,或者按照某种运算流程统一修改所有元素的数值(习题[2-13])。针对此类操作,可为向量专门设置一个遍历接口traverse()
 template <typename T> void Vector<T>::traverse(void (*visit)(T&)) //利用函数指针机制的遍历

 { for (int i = ; i < _size; i++) visit(_elem[i]); }

 template <typename T> template <typename VST> //元素类型、操作器

 void Vector<T>::traverse(VST& visit) /利用函数对象机制遍历

 { for (int i = ; i < _size; i++) visit(_elem[i]); }
- 前一种方式借助函数指针*visit()指定某一函数,该函数只有一个参数,其类型为对向量元素的引用,故通过该函数即可直接访问或修改向量元素。
- 另外有可以以函数对象的形式,指定具体的遍历操作,。这类对象的操作符“()”经重载之后,在形式上等效于一个函数接口,故此得名。
三、有序向量:
有序向量各元素之间必须能够比较大小。这一条件构成了有序向量中“次序”概念的基础,否则所谓的“有序”将无从谈起
3.1 甄别有序算法(判断是不是有序向量)
 template <typename T> int Vector<T>::disordered() const { //返回向量中逆序相邻元素对的总数

   int n = ; //计数器

3   for (int i = ; i < _size; i++) //逐一检查_size -1 对相邻元素

   if (_elem[i - ] > _elem[i]) n++; //逆序则计数

 return n; //当且仅当n = 0,向量有序

 }
3.2、唯一化(去重)
 template <typename T> int Vector<T>::uniquify() { //有序向量重复元素剔除算法(高效版)

   Rank i = , j = ; //各对互异“相邻”元素的秩

   while (++j < _size) //逐一扫描,直至末元素

     if (_elem[i] != _elem[j]) //跳过雷同者

       _elem[++i] = _elem[j]; //发现不同元素时,向前移至紧邻于前者右侧

   _size = ++i; shrink(); //直接截除尾部多余元素

   return j - i; //向量规模化变量,即被删除元素总数

 }

复杂度:
while循环的每一步迭代,仅需对元素数值做一次比较,向后移动一到两个位置指针,并至多向前复制一个元素,故只需常数时间。而在整个算法过程中,每经过一步迭代秩j都必然加一,鉴于j不能超过向量的规模n,故共需迭代n次。由此可知,uniquify()算法的时间复杂度应为O(n),较之uniquifySlow()的O(n2),效率整整提高了一个线性因子。反过来,在遍历所有元素之前不可能确定是否有重复元素,故就渐进复杂度而言,能在O(n)时间内完成向量的唯一化已属最优。当然,之所以能够做到这一点,关键在于向量已经排序。
3.3、查找
为区别于无序向量的查找接口find(),有序向量的查找接口将统一命名为search()。
 template <typename T> //在有序向量的区间[lo, hi)内,确定不大于e的最后一个节点的秩

   Rank Vector<T>::search(T const& e, Rank lo, Rank hi) const { //assert: 0 <= lo < hi <= _size

   return (rand() % ) ? //按%50的概率随机使用

   binSearch(_elem, e, lo, hi) : fibSearch(_elem, e, lo, hi); //二分查找或Fibonacci查找

 }
3.3.1.二分查找(版本A)
 // 二分查找算法(版本A):在有序向量区间[lo, hi)内查找元素e,0 <= lo <= hi <= _size

 template <typename T> static Rank binSearch(T* A, T const& e, Rank lo, Rank hi) {

   while (lo < hi) { //每步迭代要做两次判断,有三个分支

     Rank mi = (lo + hi) >> ; //以中点为轴点

     if (e < A[mi]) hi = mi; //深入前半段[lo, mi)继续查找

6     else if (A[mi] < e) lo = mi + ; //深入后半段(mi, hi)继续查找

     else return mi; //在mi处命中

   } //成功查找可以提前终止

 return -; //查找失败

} //如有多个命中元素时,不能保证返回秩最大者;查找失败时,简单的返回-1,而不能只是失败的位置。
以上算法采取的策略可概括为,以“当前区间内居中的元素”作为目标元素的试探对象。从应对最坏情况的保守角度来看,这一策略是最优的每一步迭代之后无论沿着哪个方向深入,新问题的规模都将缩小一半。因此,这一策略亦称作二分查找(binary search)。也就是说,随着迭代的不断深入,有效的查找区间宽度将按1/2的比例以几何级数的速度递减。于是,经过至多log2(hi - lo)步迭代后,算法必然终止。鉴于每步迭代仅需常数时间,故总体时间复杂度不超过:O(log2(hi - lo)) = O(logn)与代码2.10中顺序查找算法的O(n)复杂度相比,O(logn)几乎改进了一个线性因子。
查找长度:
以上迭代过程所涉及的计算,主要分为两类:元素的大小比较、秩的算术运算及其赋值。虽然二者均属于O(1)复杂度的基本操作,但元素的秩无非是(无符号)整数,而向量元素的类型则通常更为复杂,甚至复杂到未必能够保证在常数时间内完成(习题[2-17])。因此就时间复杂度的常系数而言,前一类计算的权重远远高于后者,而查找算法的整体效率也更主要地取决于其中所执行的元素大小比较操作的次数,即所谓查找长度(search length)。通常,可针对查找成功或失败等情况,从最好、最坏和平均情况等角度,分别测算查找长度,并凭此对查找算法的总体性能做一评估。
二分查找的不足:

比较是向左一次,向右两次。
成功查找长度和失败查找长度如下所示:
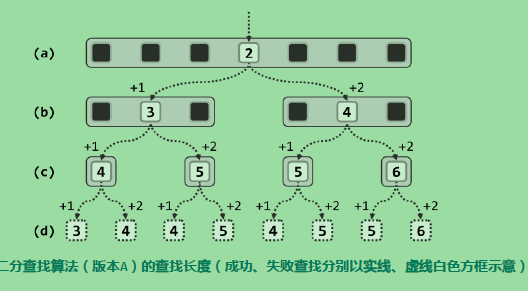
尽管二分查找算法(版本A)即便在最坏情况下也可保证O(logn)的渐进时间复杂度,但就其常系数1.5而言仍有改进余地。以成功查找为例,即便是迭代次数相同的情况,对应的查找长度也不尽相等。究其根源在于,在每一步迭代中为确定左、右分支方向,分别需要做1次或2次元素比较,从而造成不同情况所对应查找长度的不均衡。尽管该版本从表面上看完全均衡,但我们通过以上细致的分析已经看出,最短和最长分支所对应的查找长度相差约两倍。
与递归版本的二分查找相比:由于每次递归的次数和深度都是log2 n,所以每次需要的辅助空间都是常数级别的:时间复杂度是log2n,空间复杂度也是log2n。而迭代版本的二分查找其时间复杂度是O(log2n) ,由于不需要开辟新的空间,其空间复杂度是O(1).
3.3.2. Fibonacci(斐波那契)查找
按照二分查找存在均衡性方面的缺陷,根源在于这两项的大小不相匹配(向左侧成本低,右侧成本高)解决思路如下:
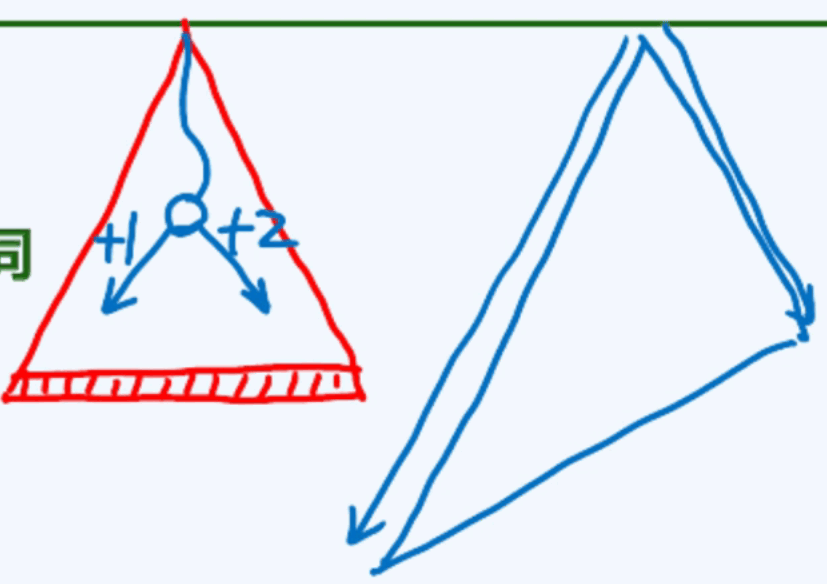
做成左侧是更深的,右侧是更浅的,这样看似的不平衡,但是由于和成本低做一个合适的补偿,可以在整体上达到最优。使得整体查找平均成本最短。
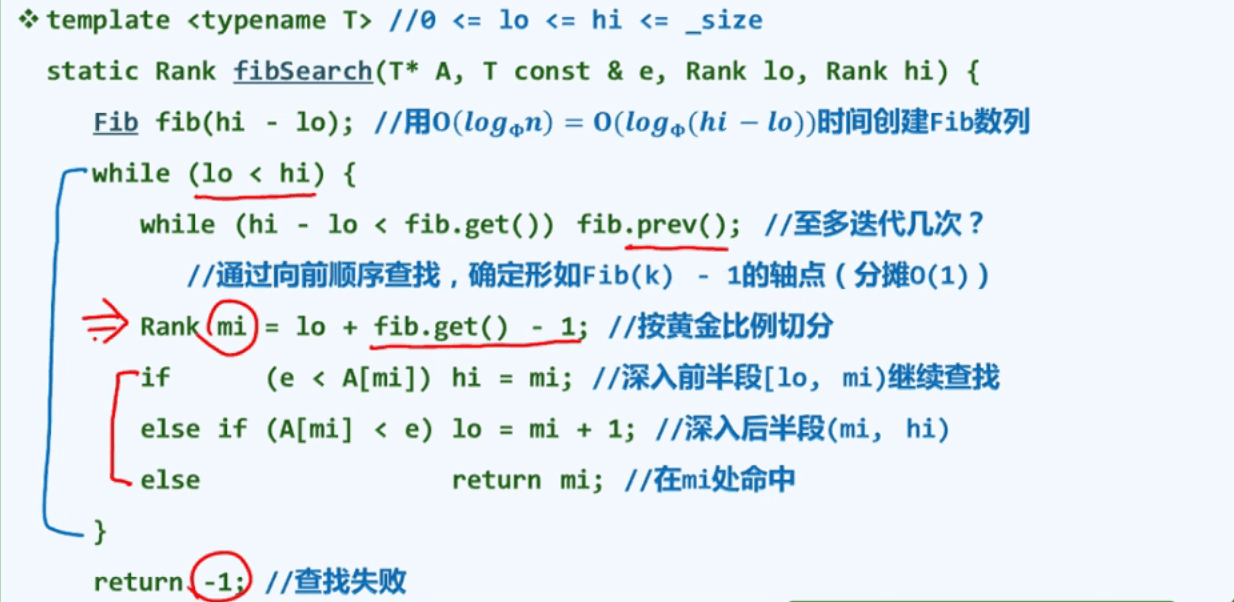
fibsearch()查找算法的实现如上所述:binsearch()与fibsearch()的区别在于中间点mi的选取,如果按照黄金分割来取,就是fibsearch(),如果是按照中点来取就是binsearch()。中点是fib(k- 1) -1;

斐波那契查找举例:
V = [2,3,7,14,22,33,55,75,89,123]
- v.size() = 10;
- 下标区间[lo,hi]为lo = 0,hi = 9;
- 初始化斐波那契数列要满足,斐波那契数列的最后一位要比size-1大。所以Fib = [1,1,2,3,5,8,13];
- 如果查找值比mid处的值大,则向右查找并减小2个斐波那契区间。
- 如果查找值比mid处的值小,则向左查找并减小1个斐波那契区间。
- block0 = 6; Fib(6) -1 > size,此时选择的6刚好是Fib序列的最后一位的序列值6.
- mid0 = lo0 + Fib(block0 - 1) -1 = 7; 对应的mid0值是75;
- 此时查找值比mid0处的值小,则向左查找并减小一个斐波那契区间。此时block1 = block0 - 1 = 5;
- 区间范围变成:lo1 = lo0 = 0;hi1 = mid0 - 1= 6;
- mid1 = lo1 + Fib(block1 -1 ) -1 = 4; 对应的mid1值是22;此时查找值44 >22,所以向右查找并减小两个斐波那契区间。block2 = block1 -2 = 3;
- lo2 = mid1 +1 = 5; hi2 = hi1 = 6;
- mid3 = lo2 + Fib(block2 -1 ) -1= 6; 对应的mid3值是55,此时查找值44<55;向左查找,并减小一个斐波那契数列 block3 = block2 -1 = 2;
- 依次往下

3.3.3.二分查找(版本B)
版本A是因为左右分支的转向代价不平衡导致的,在版本B中我们将其改成平衡的。
同样的轴点mi取做中点,所有分支只有2个方向,原来是3个方向(在轴点处要判断是否等于目标值),现在是将轴点归到右侧区间上。

具体实现如下:
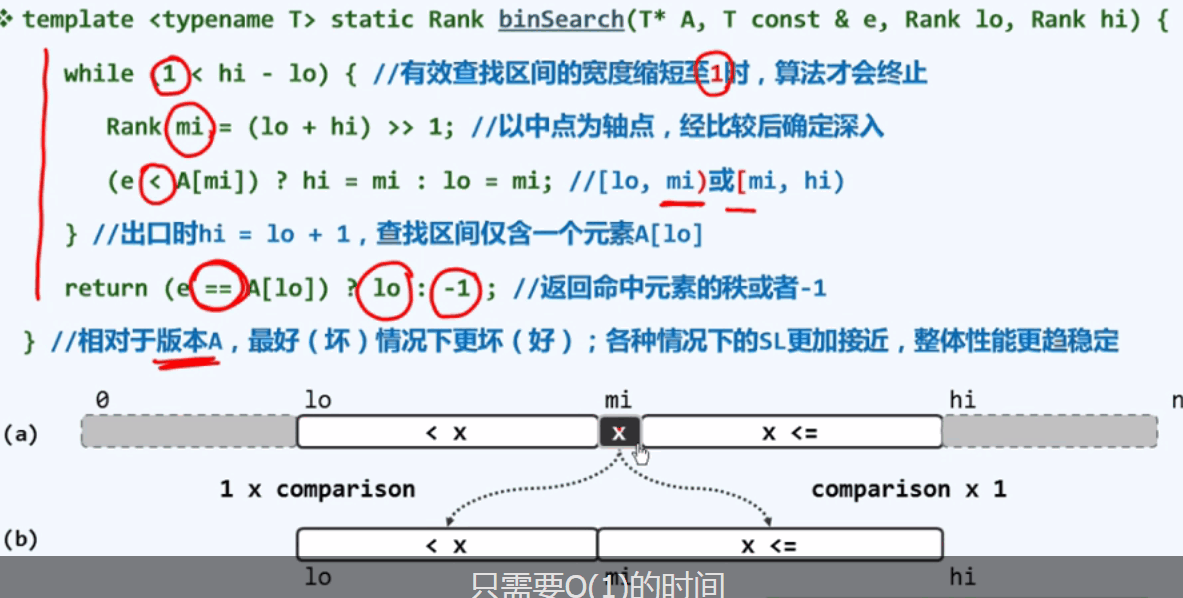
A版本和B版本的最优时间复杂度不一样:A是O(1),B是O(log2n)。
满足语义的代码:

最终得到版本C:
3.3.4.二分查找(版本C)


3.4 插值查找:

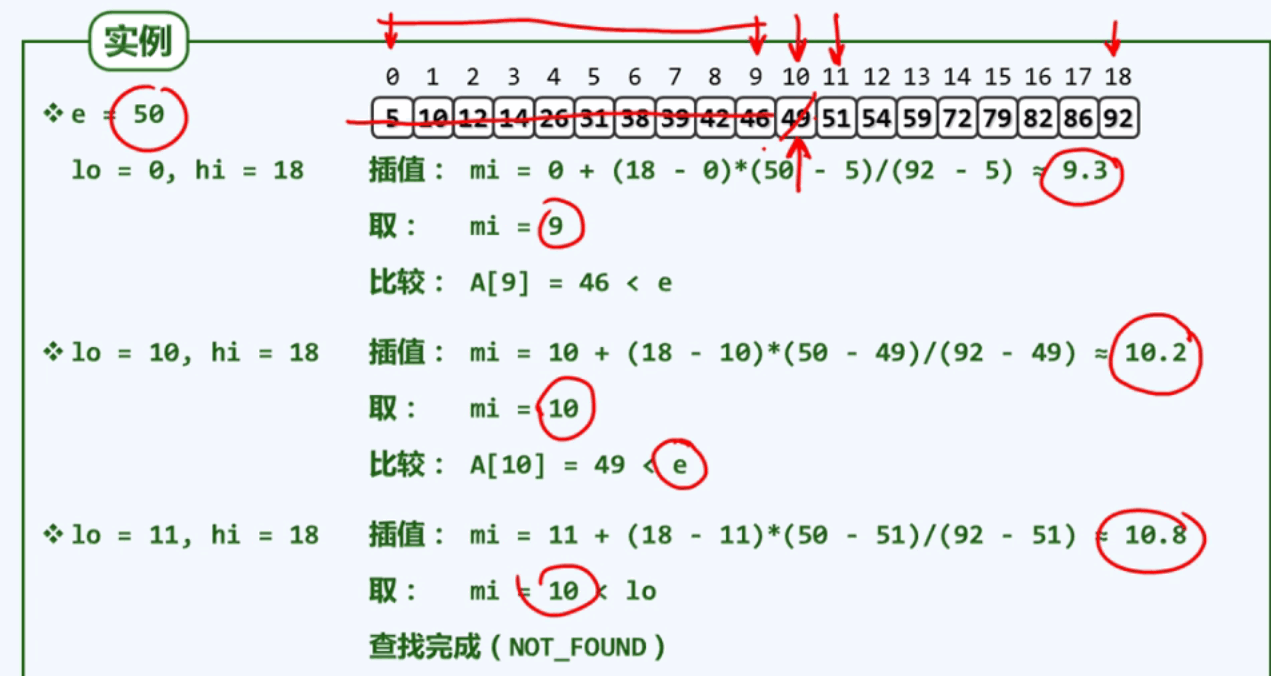
分析性能:平均情况,每经一次比较,插值查找算法就可以将查找范围n缩短至根号下n.
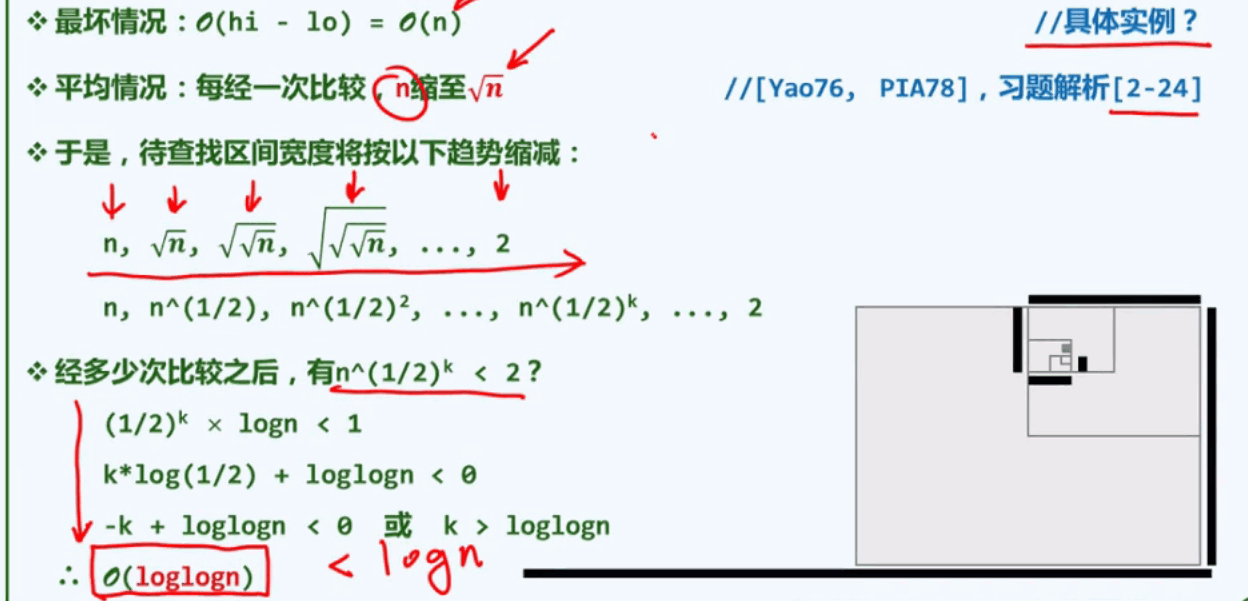
插值是对n的二进制宽度作二分查找。
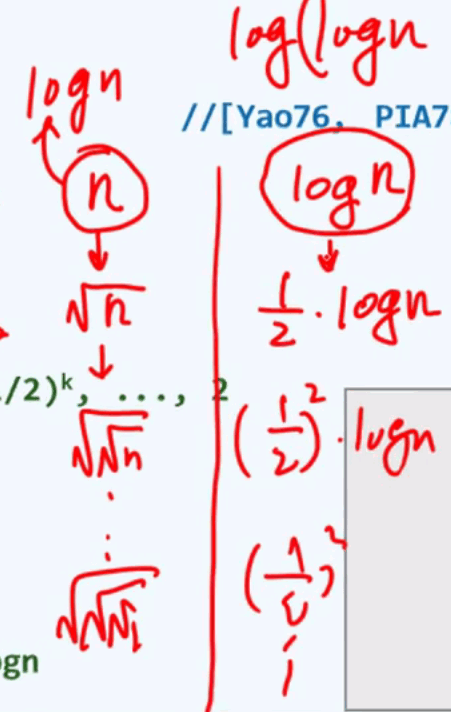
所以每次需要的次数是O(loglogn)
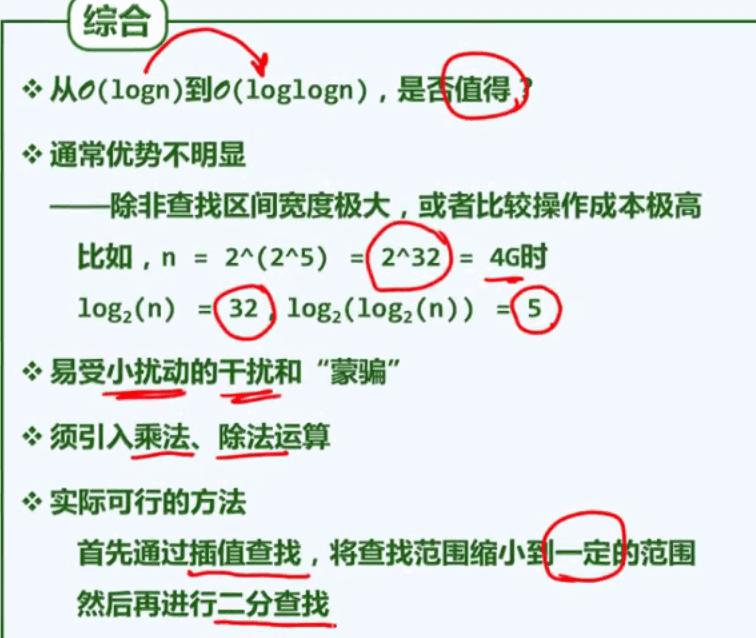
四、综合比对: 大规模:插值查找 中规模:折半查找 小规模:顺序查找
链表vector的更多相关文章
- STL中vector、list、map、set区别(转载)
list封装了链表,vector封装了数组, list和vector得最主要的区别在于vector使用连续内存存储的,他支持[]运算符,而list是以链表形式实现的,不支持[].vector对于随机访 ...
- c++ list, vector, map, set 区别与用法比较
http://blog.csdn.net/alex_xhl/article/details/37692297 List封装了链表,Vector封装了数组, list和vector得最主要的区别在于ve ...
- 剑指offer——从尾到头打印链表节点的值
输入一个链表,从尾到头打印链表每个节点的值. 输入描述:输入为链表的表头 输出描述:输出为需要打印的“新链表”的表头 一.问题分析 初拿到这个题目时,这应该是考察单向链表这一数据结构.单向链表的遍历总 ...
- list vector map set (转)
List封装了链表,Vector封装了数组, list和vector得最主要的区别在于vector使用连续内存存储的,他支持[]运算符,而list是以链表形式实现的,不支持[]. Vector对于随机 ...
- stl vector、红黑树、set、multiset、map、multimap、迭代器失效、哈希表(hash_table)、hashset、hashmap、unordered_map、list
stl:即标准模板库,该库包含了诸多在计算机科学领域里所常用的基本数据结构和基本算法 六大组件: 容器.迭代器.算法.仿函数.空间配置器.迭代适配器 迭代器:迭代器(iterator)是一种抽象的设计 ...
- [剑指offer] 14. 链表中倒数第K个节点+翻转+逆序打印+合并两个排序链表 + 链表相交(第一个公共节点) (链表)
题目描述 输入一个链表,输出该链表中倒数第k个结点. 思路: 两个指针,起始位置都是从链表头开始,第一个比第二个先走K个节点,当第一个走到链表尾时,第二个指针的位置就是倒数第k个节点.(两指针始终相 ...
- list, vector, map, set 区别与用法比较
List封装了链表,Vector封装了数组, list和vector得最主要的区别在于vector使用连续内存存储的,他支持[]运算符,而list是以链表形式实现的,不支持[]. Vector对于随机 ...
- 剑指offer46:圆圈中最后剩下的数字(链表,递归)
1 题目描述 每年六一儿童节,牛客都会准备一些小礼物去看望孤儿院的小朋友,今年亦是如此.HF作为牛客的资深元老,自然也准备了一些小游戏.其中,有个游戏是这样的:首先,让小朋友们围成一个大圈.然后,他随 ...
- 3)Java容器
3)Java容器 Java的集合框架核心主要有三种:List.Set和Map.这里的 Collection.List.Set和Map都是接口(Interface). List lst = new ...
随机推荐
- LeetCode Array Easy169. Majority Element
Description Given an array of size n, find the majority element. The majority element is the element ...
- 无法启动此程序 ,因为计算机中丢失MSVCP120.dll
1.文件丢失问题 无法启动此程序 ,因为计算机中丢失MSVCP120.dll 具体如下图所示: 等dll文件丢失,可以去下载 DirectX修复工具去修复即可 http://www.pc6.com/s ...
- Stm32CubeMX5 创建LED控制工程 - 基于stmf051k8u6
一. 创建一个控制LED的工程 1. 安装好 Stm32CubeMX5 后 打开软件 选择 “ File--> New Project...” 创建一个新工程 2. 之后会出现一个选择芯片的窗 ...
- JS window对象 Location对象 location用于获取或设置窗体的URL,并且可以用于解析URL。 语法: location.[属性|方法]
Location对象 location用于获取或设置窗体的URL,并且可以用于解析URL. 语法: location.[属性|方法] location对象属性图示: location 对象属性: lo ...
- Codeforces - 1139D - Steps to One (概率DP+莫比乌斯反演)
蒟蒻数学渣呀,根本不会做. 解法是参考 https://blog.csdn.net/xs18952904/article/details/88785210 这位大佬的. 状态的设计和转移如上面博客一样 ...
- 【网页布局基础】css布局学习总结
三种定位机制 1.标准文档流:从上到下,从左到右输出文档内容 2.浮动 3.绝对定位 需要注意的是块级元素如div p ul 等 行级元素如span strong img input等 块级元素与行级 ...
- Qt 【关于跳转页面后当前页面(委托delegate)数据丢失的问题】
这个是一个很低级的错误,之前po主急着完成任务,也是没注意看,窗口跳窗如下图所示: 这个过程中都是click促发槽然后B*pB,pB->show,同理A*pA,pA->show,这个过程中 ...
- Java——抽象:abstract
3.4抽象:abstract 3.4.1什么是抽象类? 随着继承层次中一个个新子类的定义,类变得越来越具体,而父类则更一般,更通用.类的设计应该保证父类和子类能够共享特征.有时将一个父类设计得非常抽象 ...
- spring AOP (使用AspectJ的注解方式 的aop实现) (6)
目录 一.在 Spring 中启用 AspectJ 注解支持 二.AspectJ 支持 5 种类型的通知注解: 2.1.使用之前的 计算器接口和实现类 ArithmeticCalculator.jav ...
- spring--Springmvc中@Autowired注解与@Resource注解的区别
Spring不但支持自己定义的@Autowired注解,还支持几个由JSR-250规范定义的注解,它们分别是@Resource.@PostConstruct以及@PreDestroy. @Resour ...