
Fluent_Python_Part2数据结构,04-text-byte,文本和字节序列
文本和字节序列
人使用文本,计算机使用字节序列
1. 大纲:
- 字符、码位和字节表述
- bytes、bytearray和memoryview等二进制序列的独特特性
- 全部Unicode和陈旧字符集的编解码器
- 避免和处理编码错误
- 处理文本文件的最佳实践
- 默认编码的陷阱和标准I/O的问题
- 规范化Unicode文本,进行安全的比较
- 规范化、大小写折叠和暴力移除音调符号的实用函数
- 使用locale模块和PyUCA库正确地排序Unicode文本
- Unicode数据库中的字符元数据
- 能处理字符串和字节序列的双模式API
2. 字符
从Python3的str对象获取的元素是Unicode字符
str1 = 'café'

#café字符串有4个Unicode字符

print(len(str1))

#使用UTF-8把str编码成bytes对象

byte_str1 = str1.encode('utf-8')

#bytes字面量以b开头

print(byte_str1)

#字节序列有5个字节(在UTF-8中,é的码位编码成两个字节)

print(len(byte_str1))

#使用UTF-8把bytes对象解码成str对象

print(byte_str1.decode('utf-8'))
3. 字节
例子1. bytes和bytearray
#bytes对象可以从str对象使用给定的编码构建

cafe = bytes('café', encoding='UTF-8')

print(cafe)

#各个元素是range(256)内的整数

print(cafe[0])

#这里注意,bytes对象的切片还是bytes对象

print(cafe[:1])

cafe_arr = bytearray(cafe)

#bytearray对象没有字面量句法,而是以bytearray()和字节序列字面量参数的形式显示

print(cafe_arr)

#各个元素是range(256)内的整数

print(cafe_arr[0])

#bytearray对象的切片还是bytearray对象

print(cafe_arr[-1:])
例子2. 可以用str类型的方法去处理二进制序列。但二进制序列独有fromhex方法,它的作用是解析十六进制数字对,构建二进制序列:
print(bytes.fromhex('31 4B CE A9'))
例子3. memoryview类不是用于创建或存储字节序列,而是共享内存,让你访问二进制序列、打包的数组和缓冲中的数据切片,而无需复制字节序列,Python Imaging Library(PIL)就是这么处理图像的。其中PIllow为PIL最活跃的派生库。
4. 处理UnicodeEncodeError,UnicodeDecodeError,SyntaxError
处理UnicodeEncodeError和UnicodeDecodeError在encode()和decode()时用errors参数处理。处理SyntaxError在文件头部添加注释,指出编码。
编解码器(codec, encoder/decoder)
用于在文本和字节之间相互转换。
Python自带超过100多种codec, 如'utf_8','latin_1'。这些名称可以传给open()、str.encode()、bytes.decode()等函数。例如3个编码器可以的到3个不同的字节序列。
例子1. encode和decode时errors的使用
octets = b'Montr\xe9al'

#print(octets.decode('utf_8')

#编码时制定errors='relpace',把无法编码的字符替换成"?",官方上表示未知编码

print(octets.decode('utf_8', errors='replace'))
5. 检测文本的编码
一个Python库Chardet, 还有它的一个命令行工具chardetect。
在命令行里输入chardetect * 可以检测当前目录所有文件的编码
文件以b'\xef\xbb\xbf'开头的,这是BOM(bye-order-mark).
UTF-8的一大优势是不需要BOM,因为生成的字节序列保持一致。但是Windows应用(尤其是NotePad)会在UTF-8编码中添加BOM,Excel会根据有没有BOM确定是不是UTF-8编码。
文件如果以b'\xef\xbb\xbf'开头,则有可能是带有BOM的UTF-8编码。但是Python不会以这样的BOM就认为文件是UTF-8。
6. 处理文本文件
Unicode三明治方法:
- 对输入来说,尽早把bytes->str。
- 只能处理字符串对象,在其他处理过程中,不要encode或者decode。
- 对输出来说,尽晚把str->bytes。
多数Web框架都是这样做,使用框架时很少接触字节序列。例如Django中,视图应该输出Unicode字符串,Django会负责把响应编码成bytes,而且默认使用UTF-8编码。
在Python3中轻松应用Unicode三明治的建议,因为内置的open函数在读取文件时做必要的解码,以文本模式写入文件时还会做必要的编码,所以my_file.read()和my_file.write(text)方法得到的都是字符串对象。
例子1. 获取编码默认值
import sys, locale

expressions = """

        locale.getpreferredencoding()

        type(my_file)

        my_file.encoding

        sys.stdout.isatty()

        sys.stdout.encoding

        sys.stdin.isatty()

        sys.stdin.encoding

        sys.stderr.isatty()

        sys.stderr.encoding

        sys.getdefaultencoding()

        sys.getfilesystemencoding()

"""

print(expressions)

my_file = open('dummy', 'w')

for expression in expressions.split():

    #eval() 函数用来执行一个字符串表达式,并返回表达式的值。

    value = eval(expression)

    print(expression.rjust(30), '->', repr(value))
7. Unicode规范化字符串
有两种组合方式
例如‘é’和''e\u0301(组合字符),是标准等价物(canonical equivalent),应视作相同的字符。len('café')字节数为4,len('cafe\u0301')字节数为5,但码位序列不同(长度不同),所以s1 == s2为False。
此时需要规范化。解决方案是使用unicodedata.normalize函数提供的Unicode规范化。有NFC、NFD、NFKC、NFKD四种。
用户输入默认的是NFC形式。不过,安全起见,保存文本之前,最好是使用normalize('NFC', user_text)清洗字符串。
NFKC和NFKD在特殊情况下使用,例如搜索和索引,而不能用持久存储,因为这种转换会导致数据损失。NFC和NFD可以放心使用。
例子1. NFC(Normalization Form C)使用最少的码位构成等价字符串
from unicodedata import normalize

s1 = 'café'

s2 = 'cafe\u0301'

print(len(s1), len(s2)) #4 5

print('s1 == s2: ',s1 == s2) #False

#规范化

s3 = normalize('NFC', s1)

s4 = normalize('NFC', s2)

print(len(s3), len(s4)) #4 4

print(s3 == s4) #True
例子2. NFD是组合字符(例如e加上音节变成é)。
from unicodedata import normalize

s1 = 'café'

s2 = 'cafe\u0301'

print(len(s1), len(s2)) #4 5

print('s1 == s2: ',s1 == s2) #False

#规范化

s3 = normalize('NFD', s1)

s4 = normalize('NFD', s2)

print(len(s3), len(s4)) #5 5

print(s3 == s4) #True
Note: str.casefold() 可以把文本变成小写。和str.lower()差不多,具体差别看StackOverFlow的提问和文档。从Python3.4起,两个函数得到不同的只占Unicode命名的字符的0.11%。
例子3. 如果要处理多语言文本,工具箱应该有nfc_equal和fold_equal函数。
#比较规范化Unicode字符串

from unicodedata import normalize

def nfc_equal(str1, str2):

    return normalize('NFC', str1) == normalize('NFC', str2)

def fold_equal(str1, str2):

    return (normalize('NFC', str1).casefold() ==

            normalize('NFC', str2).casefold())
8. 极端规范化:去掉变音符号
例如'á'变成'a'。 在某些情况下会用到这个技术,例如Google搜索。另外,
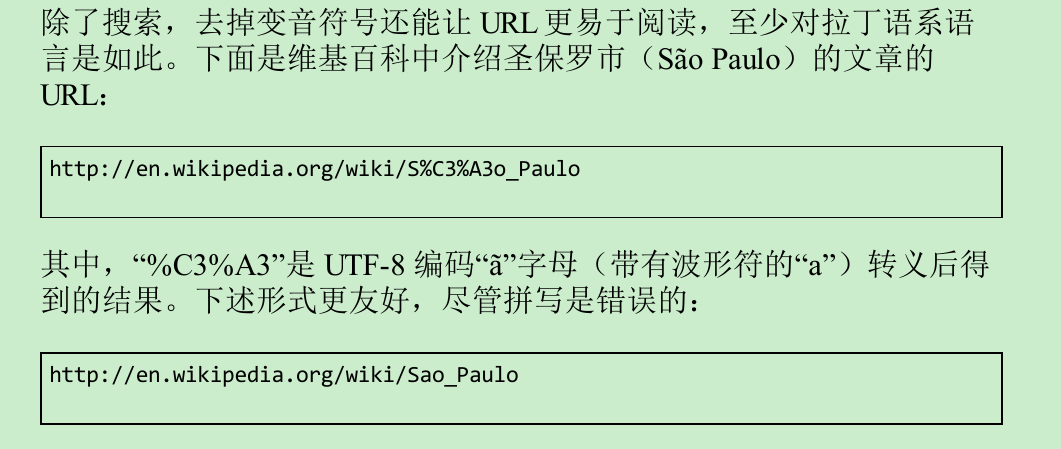
去掉全部变音符号音符)的函数
def shave_marks(txt):

    """Remove all diacritic marks"""

    norm_txt = unicodedata.normalize('NFD', txt)

    shaved = ''.join(c for c in norm_txt

                     if not unicodedata.combining(c))

    return unicodedata.normalize('NFC', shaved)
9. 支持字符串和字节序列的双模式API
双模式API,即提供的函数能接受字符串或字节序列为参数,然后根据类型进行处理。例如,re和os模块就有这种函数。
import os

print(os.listdir('.'))

print(os.listdir(b'.'))
Fluent_Python_Part2数据结构,04-text-byte,文本和字节序列的更多相关文章
- 《流畅的Python》第二部分 数据结构 【序列构成的数组】【字典和集合】【文本和字节序列】
第二部分 数据结构 第2章 序列构成的数组 内置序列类型 序列类型 序列 特点 容器序列 list.tuple.collections.deque - 能存放不同类型的数据:- 存放的是任意类型的对象 ...
- python高级(四)—— 文本和字节序列(编码问题)
本文主要内容 字符 字节 结构体和内存视图 字符和字节之间的转换——编解码器 BOM鬼符 标准化Unicode字符串 Unicode文本排序 python高级——目录 文中代码均放在github上: ...
- Python 文本和字节序列
p.p1 { margin: 0.0px 0.0px 0.0px 0.0px; font: 15.0px Helvetica } Python 3 明确区分了人类可读的文本字符串和原始的字节序列.隐式 ...
- 流畅的python第四章文本和字节序列学习记录
字符问题 把码位转化成字节序列的过程是编码,把字节序列转化成码位的过程是解码 把unicode字符串当成人类可读的文本,码位当成机器可读的, 将字节序列编程人类可读是解码,把字符串编码成字节序列是编码 ...
- Python的文本和字节序列
一.字符串的表示和存储 字符串是字符的序列,每个字符都有有一个数字作为标识,同时会有一个将标识转换为存储字节的编码方案: s = 'hello world python' for c in s: pr ...
- Python文本和字节序列
ASCII码 早期人们用8位二进制来编码英文字母(最前面的一位是0) 也就是说,将英文字母和一些常用的字符和这128种二进制0.1串一一对应起来, 比如:大写字母“A”所对应的二进制位“0100000 ...
- 压缩文本、字节或者文件的压缩辅助类-GZipHelper
下面为大家介绍一.NET下辅助公共类GZipHelper,该工具类主要作用是对文本.字符.文件等进行压缩与解压.该类主要使用命名空间:System.IO.Compression下的GZipStream ...
- 压缩文本、字节或者文件的压缩辅助类-GZipHelper 欢迎收藏
压缩文本.字节或者文件的压缩辅助类-GZipHelper 欢迎收藏 下面为大家介绍一.NET下辅助公共类GZipHelper,该工具类主要作用是对文本.字符.文件等进行压缩与解压.该类主要使用命名空间 ...
- SQL Text Literals 文本
Text Literals 文本 Use the text literal notation to specify values whenever string appears in the synt ...
随机推荐
- Bootstrap框架学习
Bootstrap框架个人总结 https://blog.csdn.net/To_Front_End/article/details/51142716 Bootstrap 教程 https://www ...
- Java爬虫学习(1)之爬取新浪微博博文
本次学习采用了webmagic框架,完成的是一个简单的小demo package com.mieba.spiader; import us.codecraft.webmagic.Page; impor ...
- 5.springboot-------Yaml
springboot配置文件: Yaml是什么玩意? Yaml的基本语法 编写规则 1.大小写敏感,同json: 2.通过缩进表示层级关系:符号含义 注意事项:字符串默认不需要加上单引号或双引号. # ...
- [POI2011]ROT-Tree Rotations 线段树合并|主席树 / 逆序对
题目[POI2011]ROT-Tree Rotations [Description] 现在有一棵二叉树,所有非叶子节点都有两个孩子.在每个叶子节点上有一个权值(有\(n\)个叶子节点,满足这些权值为 ...
- Iris_MVC
2. MVC包使用 在Iris框架中,封装了mvc包作为对mvc架构的支持,方便开发者遵循mvc的开发原则进行开发. iris框架支持请求数据.模型.持久数据分层处理,并支持各层级模块代码绑定执行. ...
- gerp 查找, sed 编辑, awk 根据内容分析并处理.的作用
awk(关键字:分析&处理) 一行一行的分析处理 awk '条件类型1{动作1}条件类型2{动作2}' filename, awk 也可以读取来自前一个指令的 standard input相对 ...
- win10图标变白的解决办法(亲测有用)
1.首先,随便打开一个文件夹点击[查看]菜单,然后勾选[隐藏的项目]: 2.同时按下快捷键[Win]+[R],在打开的[运行]窗口中输入%localappdata%: 3.在打开的文件夹中,找到[Ic ...
- jmeter的使用---控制器
1.如果(If)控制器.Switch Controller if控制语句,判断字段是否存在,或者符合,执行不同的逻辑 2.简单控制器 一次进件流程,需要不同模块的数据,例如登陆,提交个人信息,信用认证 ...
- jquery点击添加样式,再次点击移除样式
$("#divSetting").on("click", function () { $(this).toggleClass("open") ...
- java 实体类 时间格式字段注解
@DatetimeFormat是将String转换成Date,一般前台给后台传值时用 @JsonFormat(pattern="yyyy-MM-dd") 将Date转换成Strin ...