
用python做推荐系统(二)
一、简介
继上一篇基于用户的推荐算法,这一篇是要基于商品的,基于用户的好处是可以根据用户的评价记录找出跟他兴趣相似的用户,再推荐这些用户也喜欢的电影,但是万一这个用户是新用户呢?或是他还没有对任何电影做评价,那我们要怎么去推荐他可能会有兴趣的东西呢?这边就是要介绍基于商品的相似度,我们打开豆瓣随便查看一部电影,会看到下面有一个栏位是喜欢这部电影的人也喜欢哪些电影,就是利用了商品相似度的概念。商品相似度还有一个好处,就是可以“事先”计算好,由于商品相似度每个用户看到的结果都会是一样的,他可以事先就先算好放在那,等有一批新商品进入时再计算,比较不需要为每个用户都计算一遍,这是他的一个很大的优势。原理也很简单,就是找出喜欢这个电影的用户,他们也喜欢哪些电影,下面就是利用pyhton来做示范。
二、数据预处理
这次我们还是沿用之前在movielens下载的数据,但由于我们的“目标”变了,所以数据预处理的方式也要做些调整,之前我们是以人为键值(key),后面跟了他评价的电影和评分,现在我们要改成以电影为键值,后面跟了评价他的人和给出的评分,这样做是方便到时候算法代码比较好写,下面是数据读取和预处理的代码。
def load_data():

    f = open('u.data')

    movie_list={}

    for line in f:

        (user,movie,rating,ts) = line.split('\t')

        movie_list.setdefault(movie,{})

        movie_list[movie][user] = float(rating)

    return movie_list
用print查看movie_list的样子
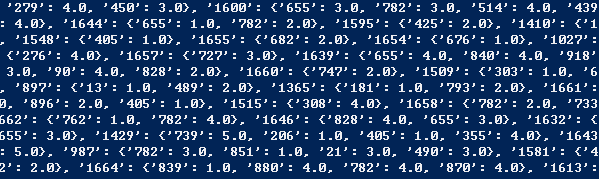
可以看到,与前面以人为主的相比,很多电影的评分人数都只有一个,所以数据量的不足也会影响到最后算出来的结果。
三、数据分析
这边跟前面以人为主的推荐有点不一样,上一篇我挑了7号用户作为我们的推荐对象,但商品我要对‘’所有商品‘’都找出他们的相似商品,计算量就会大很多,下面为代码
def calculate():

    list = load_data()

    movie_diff = {}

    for movie1 in list.keys():

        movie_diff.setdefault(movie1,{})

        for movie2 in list.keys():

            if movie1 != movie2:

                a = 0

                b=0

                for name1 in list[movie1].keys():

                    for name2 in list[movie2].keys():

                        if name1 == name2:

                            diff = sqrt(pow(list[movie1][name1] -list[movie2][name2],2))

                            b += 1

                            a += diff

                if b != 0:

                    movie_diff[movie1][movie2] = 1/(1+(a/b))

    print(movie_diff)
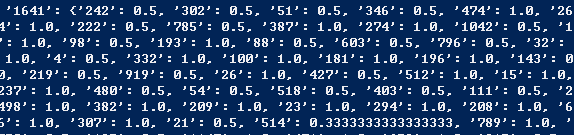
这次跑的时间长了很多,因为要拿所有电影跟其他所有电影进行比较,而且是要比评价电影的所有人,所以计算量大很多,以下是跑完出来的结果,可以看到其实很多的相关性都是1,代表其实由于数据量太少,所以出来的结果参考价值并不大。
四、后续改进
以下是经过这两次的演练的心得
1、欧几里得虽然简单快速,但他出来的结果并不好,下次可以试试其他的算法
2、for循环可以用矩阵来代替,效率会更好
3、可以尝试跑数据量大数据,出来的效果会比较好
用python做推荐系统(二)的更多相关文章
- 用python做推荐系统(一)
一.简介: 推荐系统是最常见的数据分析应用之一,包含淘宝.豆瓣.今日头条都是利用推荐系统来推荐用户内容.推荐算法的方式分为两种,一种是根据用户推荐,一种是根据商品推荐,根据用户推荐主要是找出和这个用户 ...
- What exactly can you do with Python? Here are Python’s 3 main applications._你能用Python做什么?下面是Python的3个主要应用程序。
原文链接 Github地址 一.陈述 1,我到底能用Python做什么? 我观察注意到Python三个主要流行的应用: 网站开发: 数据科学——包括机器学习,数据分析和数据可视化: 做脚本语言. 二. ...
- python排序之二冒泡排序法
python排序之二冒泡排序法 如果你理解之前的插入排序法那冒泡排序法就很容易理解,冒泡排序是两个两个以向后位移的方式比较大小在互换的过程好了不多了先上代码吧如下: 首先还是一个无序列表lis,老规矩 ...
- 12岁的少年教你用Python做小游戏
首页 资讯 文章 频道 资源 小组 相亲 登录 注册 首页 最新文章 经典回顾 开发 设计 IT技术 职场 业界 极客 创业 访谈 在国外 - 导航条 - 首页 最新文章 经典回顾 开发 ...
- Python 基础语法(二)
Python 基础语法(二) --------------------------------------------接 Python 基础语法(一) ------------------------ ...
- Python 数据分析(二 本实验将学习利用 Python 数据聚合与分组运算,时间序列,金融与经济数据应用等相关知识
Python 数据分析(二) 本实验将学习利用 Python 数据聚合与分组运算,时间序列,金融与经济数据应用等相关知识 第1节 groupby 技术 第2节 数据聚合 第3节 分组级运算和转换 第4 ...
- 初学 Python(十二)——高阶函数
初学 Python(十二)--高阶函数 初学 Python,主要整理一些学习到的知识点,这次是高阶函数. #-*- coding:utf-8 -*- ''''' 话说高阶函数: 能用函数作为参数的函数 ...
- python做量化交易干货分享
http://www.newsmth.NET/nForum/#!article/Python/128763 最近程序化交易很热,量化也是我很感兴趣的一块. 国内量化交易的平台有几家,我个人比较喜欢用的 ...
- Python爬虫利器二之Beautiful Soup的用法
上一节我们介绍了正则表达式,它的内容其实还是蛮多的,如果一个正则匹配稍有差池,那可能程序就处在永久的循环之中,而且有的小伙伴们也对写正则表达式的写法用得不熟练,没关系,我们还有一个更强大的工具,叫Be ...
随机推荐
- saltStack_安装和使用
服务端: yum install -y salt-master 客服端: yum install -y salt-minion 服务端启动: systemctl restartsalt-master ...
- poj 2442 Sequence (Priority Queue)
2442 -- Sequence 真郁闷,明明方法是对的,为什么我的代码老是那么的慢._(:з」∠)_ 这题要想考虑两列的情况,然后逐列拓展. 代码如下: #include <cstdio> ...
- Fish Shell使用心得
Fish的官网宣传语是 Finally, a command line shell for the 90s. 翻译过来就是 Fish shell 是一个为90后准备的 shell. 有人说:" ...
- 手把手教你用Python实现自动特征工程
任何参与过机器学习比赛的人,都能深深体会特征工程在构建机器学习模型中的重要性,它决定了你在比赛排行榜中的位置. 特征工程具有强大的潜力,但是手动操作是个缓慢且艰巨的过程.Prateek Joshi,是 ...
- php页面最大执行时间 set_time_limit函数不起作用
作者: default|标签:PHP set_time_limit 执行时间|2017-3-21 15:03 set_time_limit 不生效或者无效解决方法 <?php globa ...
- html5在微信中不允许放大缩小页面
在头部添加 <meta name="viewport" content="width=device-width, initial-scale=1, maximum- ...
- Django OMR QuerySet的特性/存在意义
QuerySet存在的意义主要在惰性机制和缓存两点 ---------->惰性机制: 所谓惰性机制:Publisher.objects.all()或者.filter()等都只是返回了一个Quer ...
- Python--day26--面向对象思维导图
- jackson中的@JsonBackReference和@JsonManagedReference,以及@JsonIgnore
jackson中的@JsonBackReference和@JsonManagedReference,以及@JsonIgnore均是为了解决对象中存在双向引用导致的无限递归(infinite recur ...
- 2018-7-31-C#-判断两条直线距离
title author date CreateTime categories C# 判断两条直线距离 lindexi 2018-07-31 14:38:13 +0800 2018-05-08 10: ...