
python15正则表达式
------------恢复内容开始------------
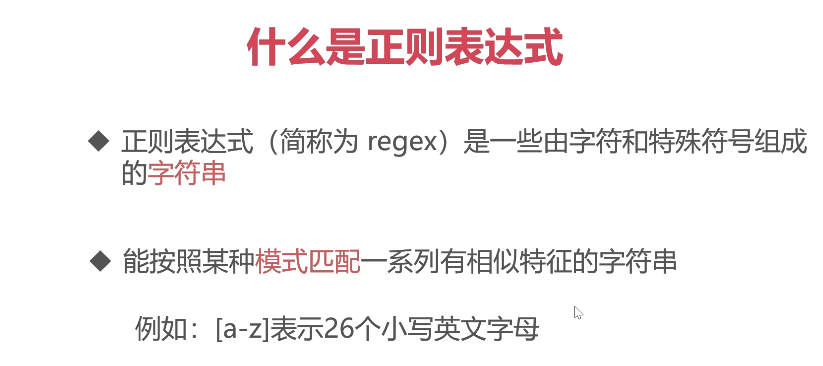
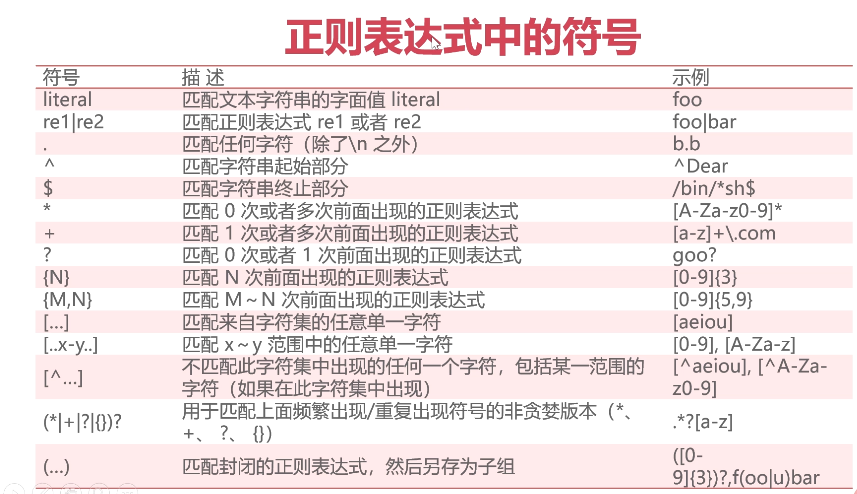
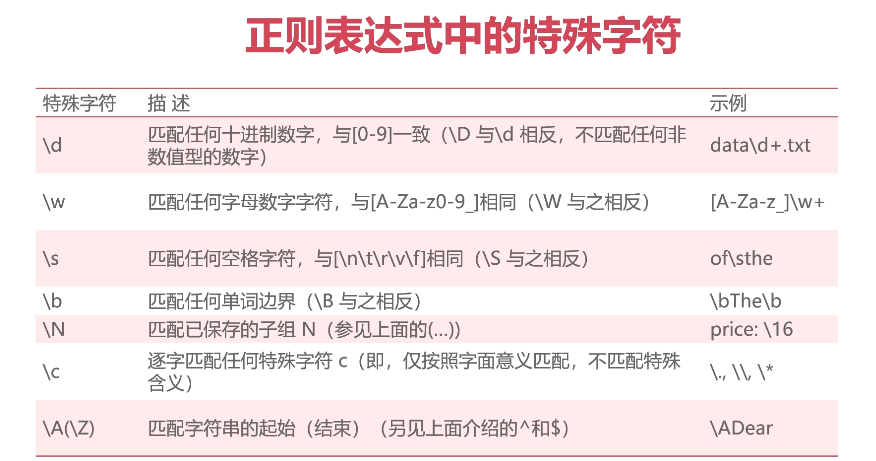
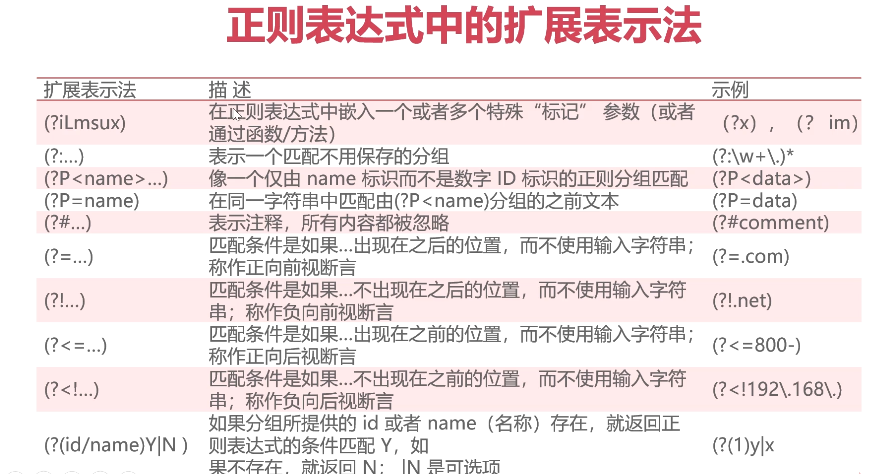
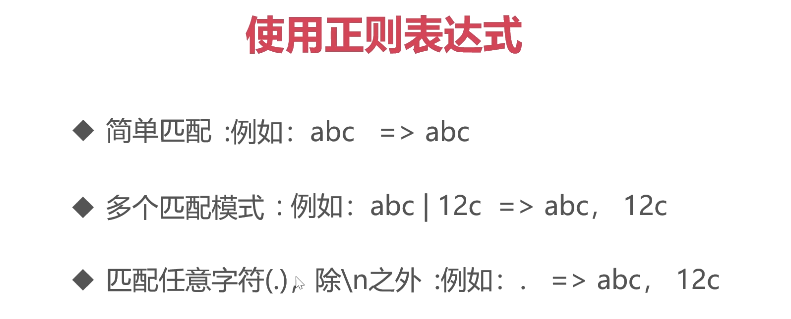
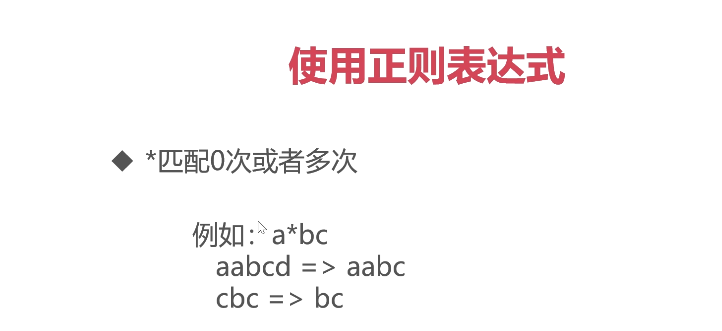
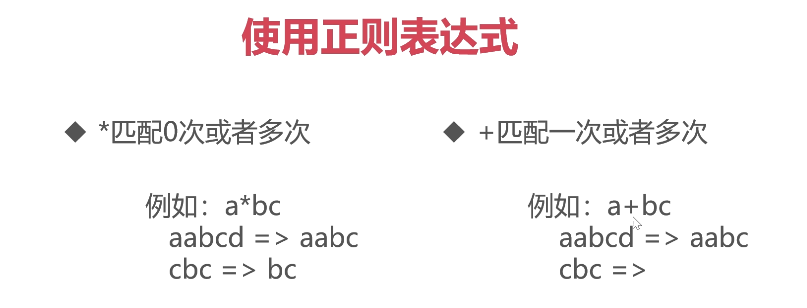
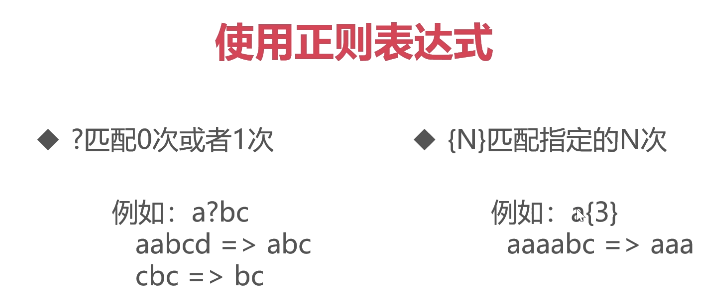
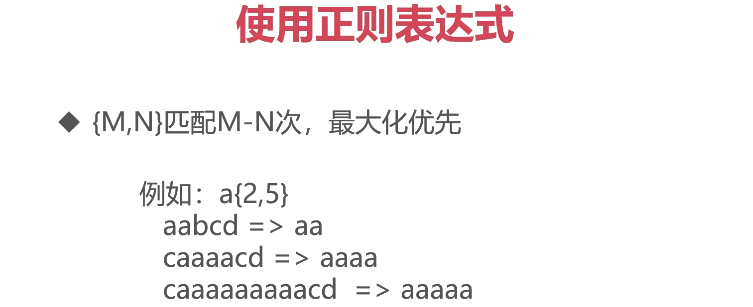
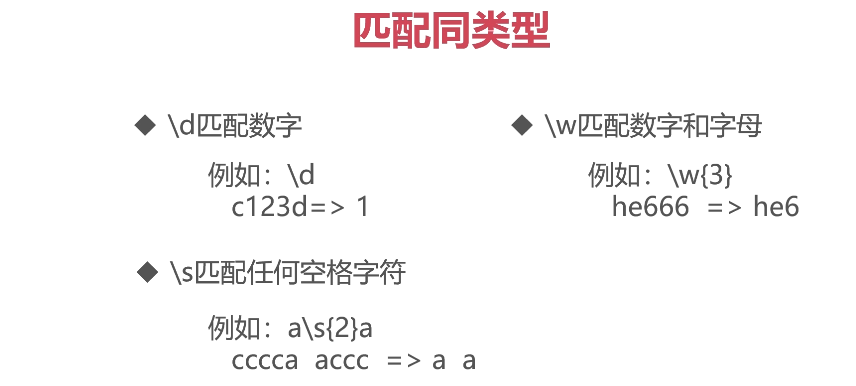
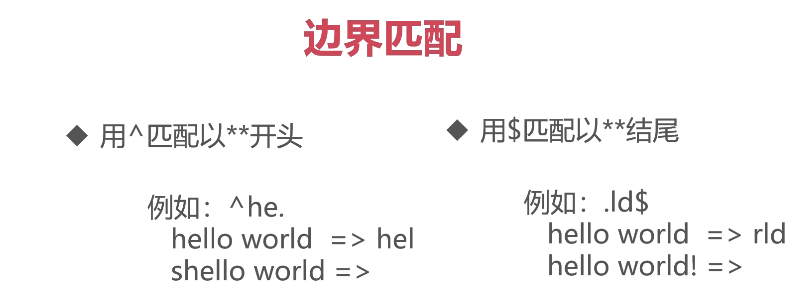
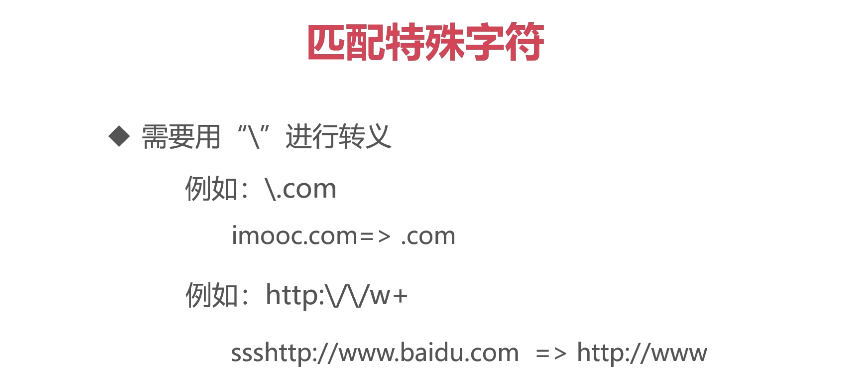
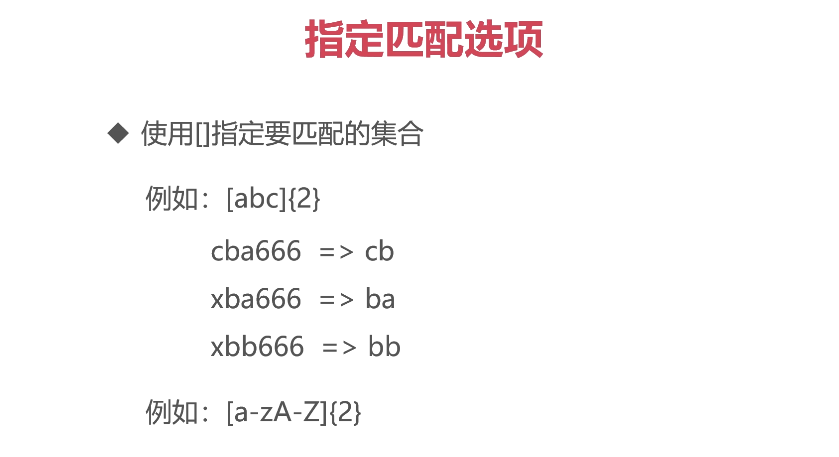
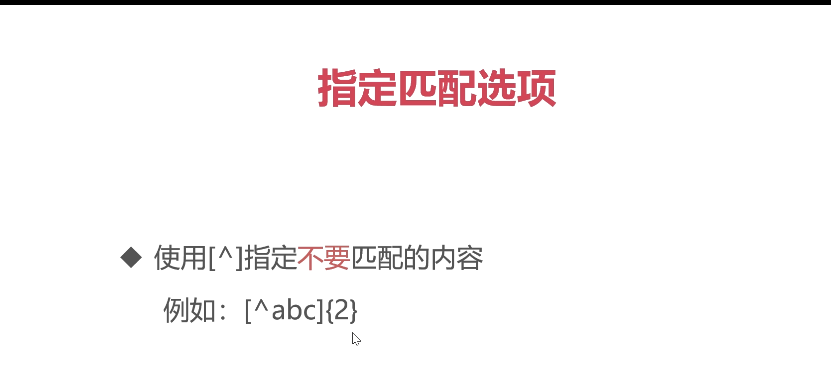
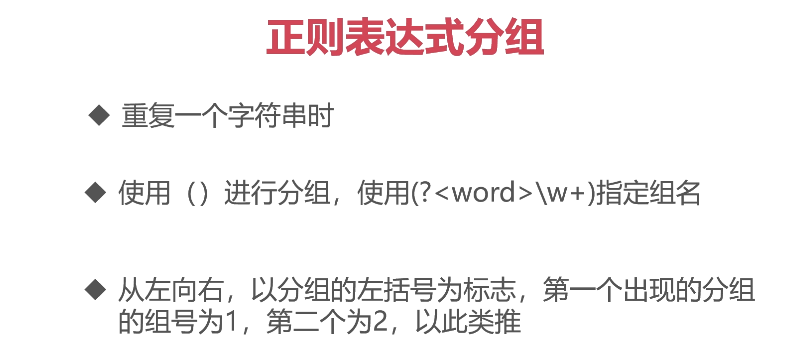
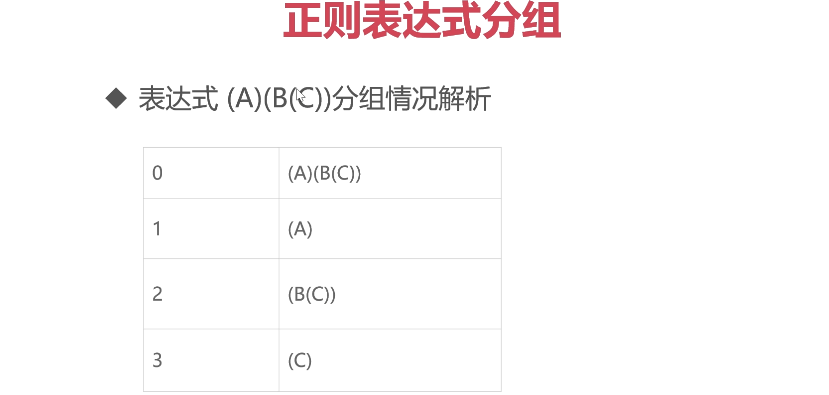
python实现实现实现实现
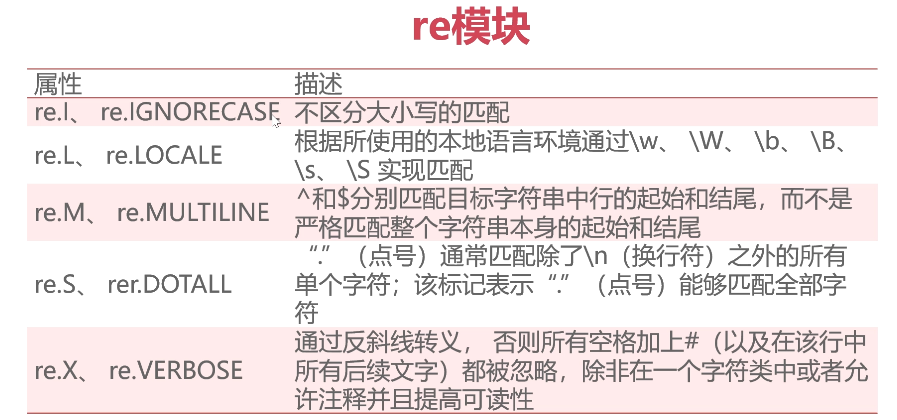
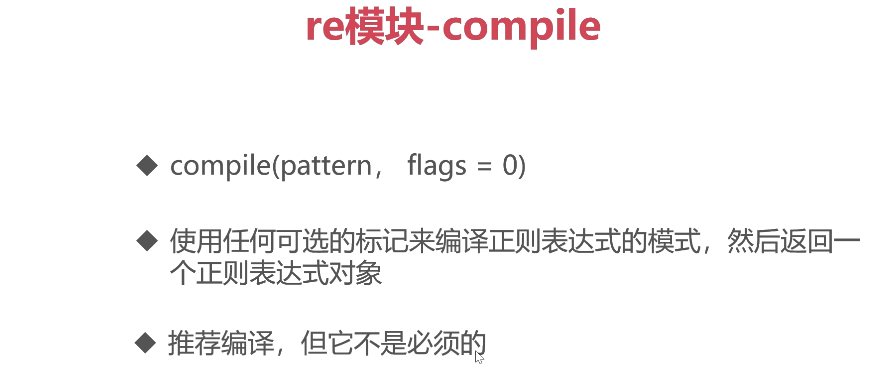
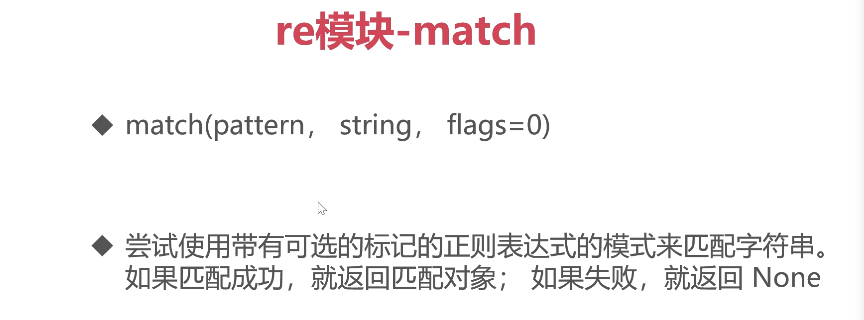
import re

#将表达式编译,返回一个对象,

pattern = re.compile(r"hello",re.I)#re.I忽略大小写

print(dir(pattern))

#使用对象的方法,通过match匹配

rest = pattern.match("hellossss")

print(rest)

rest1 = pattern.match("Hellossss")

print(rest1)

print(dir(rest1))

结果:

['__class__', '__copy__', '__deepcopy__', '__delattr__', '__dir__', '__doc__', '__eq__',

'__format__', '__ge__', '__getattribute__', '__gt__', '__hash__', '__init__',
 '__init_subclass__', '__le__', '__lt__', '__ne__', '__new__', '__reduce__',

'__reduce_ex__', '__repr__', '__setattr__', '__sizeof__', '__str__', '__subclasshook__',

'findall', 'finditer', 'flags', 'fullmatch', 'groupindex', 'groups', 'match', 'pattern',

'scanner', 'search', 'split', 'sub', 'subn']

<re.Match object; span=(0, 5), match='hello'>

<re.Match object; span=(0, 5), match='Hello'>

['__class__', '__copy__', '__deepcopy__', '__delattr__', '__dir__', '__doc__',

'__eq__', '__format__', '__ge__', '__getattribute__', '__getitem__', '__gt__', '__hash__',

'__init__', '__init_subclass__', '__le__', '__lt__', '__ne__', '__new__', '__reduce__',

'__reduce_ex__', '__repr__', '__setattr__', '__sizeof__', '__str__', '__subclasshook__',
 'end', 'endpos', 'expand', 'group', 'groupdict', 'groups', 'lastgroup', 'lastindex',

'pos', 're', 'regs', 'span', 'start', 'string']
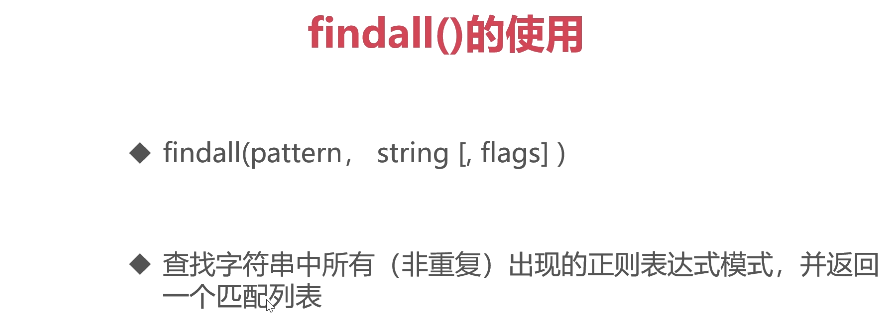
浏览全部字符串,匹配所有合规则的字符串,匹配到的字符串放到一个列表中,未匹配成功返回空列表

一旦匹配成,再次匹配,是从前一次匹配成功的,后面一位开始的,也可以理解为匹配成功的字符串,不在参与下次匹配

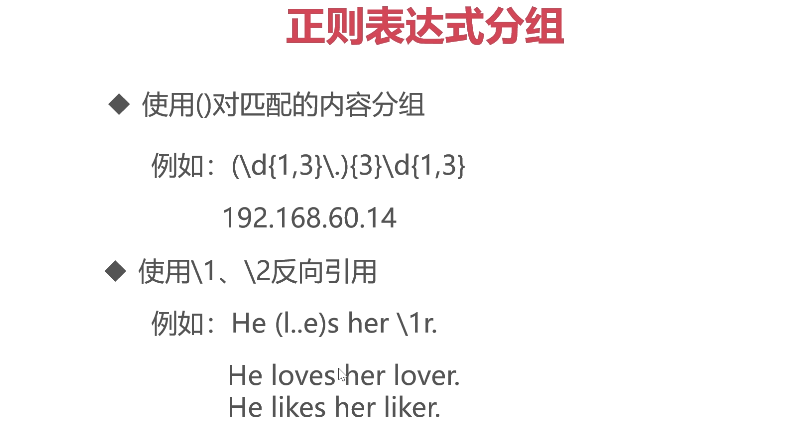
无分组:匹配所有合规则的字符串,匹配到的字符串放到一个列表中

有分组:只将匹配到的字符串里,组的部分放到列表里返回,相当于groups()方法

多个分组:只将匹配到的字符串里,组的部分放到一个元组中,最后将所有元组放到一个列表里返

相当于在group()结果里再将组的部分,分别,拿出来放入一个元组,最后将所有元组放入一个列表返回

分组中有分组:只将匹配到的字符串里,组的部分放到一个元组中,先将包含有组的组,看作一个整体也就是一个组,把这个整体组放入一个元组里,然后在把组里的组放入一个元组,最后将所有组放入一个列表返回
import re

#使用编译

coent = "Oone1twoT2three3"

p = re.compile(r"[a-z]+",re.I)#r表示其后的字符串按原样表示,不使用转义字符

rest = p.findall(coent) #一列表的额形式返回

print(rest)

#不编译直接使用方法

print(re.findall(r"[a-z]+",coent,re.I))
结果:
['Oone', 'twoT', 'three']

['Oone', 'twoT', 'three']
import re

content = "quan zhiqiang"

p = re.compile(r"zhi")

rest = p.search(content)

print(rest)

print("QQQQQQQQQQQQQQQQ")

rest1 = p.match(content)

print(rest1)

#因为match从第一个字符开始寻找,第一个字符不匹配直接不寻找了,

#search会继续下一个查找

print("不编译,不编译")

no_rest = re.search("zhi",content)

print(no_rest)
结果:
<re.Match object; span=(5, 8), match='zhi'>

QQQQQQQQQQQQQQQQ

None

不编译,不编译

<re.Match object; span=(5, 8), match='zhi'>
import re

def test_g():

    content = "quanzhiqiang"

    p = re.compile(r"zhi")

    rest = p.search(content)

    print(rest)#注意,当匹配不到的时候,需要对if rest 进行判断,不然直接

    if rest:

        #使用group打印会出错

        print(rest.group())

        #如果前面使用分株,可以group(1)

        print(rest.groups())#因为没有进行分组,所以为空的元组

def test_id():

    p = re.compile(r"(\d{6})(\d{4})((\d{2})(\d{2}))\d{2}\d{1}([0-9]|X)")

    id1 = "440882199904142235"

    id2 = "44088219990214228X"

    rest1 = p.search(id2)

    print(rest1.group(1))

    print(rest1.groups())#放回说有的组

    print("#######################")

    print(rest1.groupdict())

if __name__ == "__main__":

    test_g()

    test_id()

结果:

<re.Match object; span=(4, 7), match='zhi'>

zhi

()

440882

('440882', '1999', '0214', '02', '14', 'X')

#######################

{}
import re

def test_g():

    content = "quanzhiqiang"

    p = re.compile(r"zhi")

    rest = p.search(content)

    print(rest)#注意,当匹配不到的时候,需要对if rest 进行判断,不然直接

    if rest:

        #使用group打印会出错

        print(rest.group())

        #如果前面使用分株,可以group(1)

        print(rest.groups())#因为没有进行分组,所以为空的元组

def test_id():

    #p = re.compile(r"(\d{6})(\d{4})((\d{2})(\d{2}))\d{2}\d{1}([0-9]|X)")

    p = re.compile(r"(\d{6})(?P<year>\d{4})((?P<month>\d{2})(?P<day>\d{2}))\d{2}\d{1}([0-9]|X)")

    id1 = "440882199904142235"

    id2 = "44088219990214228X"

    rest1 = p.search(id2)

    print(rest1.group(1))

    print(rest1.groups())#放回说有的组

    print("#######################")

    print(rest1.groupdict())

if __name__ == "__main__":

    test_g()

    test_id()

结果;

<re.Match object; span=(4, 7), match='zhi'>

zhi

()

440882

('440882', '1999', '0214', '02', '14', 'X')

#######################

{'year': '1999', 'month': '02', 'day': '14'}
import re

s = "one1two2three333four"

p = re.compile(r"\d+")

rest = p.split(s)

print(rest)

结果:

['one', 'two', 'three', 'four']
import re

s = "one1two2three333four"

p = re.compile(r"\d+")

rest = p.split(s,2)#只分割前两个

print(rest)

结果:

['one', 'two', 'three333four']
import re

s = "one1two2three333four"

#s = "one@two@three@four"

p = re.compile(r"\d+")

rest = p.sub("@",s)

print(rest)

#原始的替换方法:

print("@@@@@@@@@@@@@@@@@@@@@@@@@@@")

rest1 = s.replace("1","@").replace("2","@").replace("333","@")

print(rest1)

#更换位置

s2 = "hello world"

p2 = re.compile(r"(\w+) (\w+)")

rest3 = p2.sub(r"\2 \1",s2)

print(rest3)

#使用函数进行替换更换并大写:

def f(m):

    return m.group(2).upper() + " " + m.group(1)

print("HHHHHHHHHHHHHHHHHHHHHHH")

rest4 = p2.sub(f,s2)

print(rest4)

#使用匿名函数替换

print("QQQQQQQQQQQQQQQQQQQQQQ")

rest6 = p2.sub(lambda m :m.group(2).upper() + " " + m.group(1),s2)

print(rest6)

结果:

one@two@three@four

@@@@@@@@@@@@@@@@@@@@@@@@@@@

one@two@three@four

world hello

HHHHHHHHHHHHHHHHHHHHHHH

WORLD hello

QQQQQQQQQQQQQQQQQQQQQQ

WORLD hello
------------恢复内容结束------------
python15正则表达式的更多相关文章
- JS正则表达式常用总结
正则表达式的创建 JS正则表达式的创建有两种方式: new RegExp() 和 直接字面量. //使用RegExp对象创建 var regObj = new RegExp("(^\\s+) ...
- Python高手之路【五】python基础之正则表达式
下图列出了Python支持的正则表达式元字符和语法: 字符点:匹配任意一个字符 import re st = 'python' result = re.findall('p.t',st) print( ...
- C# 正则表达式大全
文章导读 正则表达式的本质是使用一系列特殊字符模式,来表示某一类字符串.正则表达式无疑是处理文本最有力的工具,而.NET提供的Regex类实现了验证正则表达式的方法.Regex 类表示不可变(只读)的 ...
- C#基础篇 - 正则表达式入门
1.基本概念 正则表达式(Regular Expression)就是用事先定义好的一些特定字符(元字符)或普通字符.及这些字符的组合,组成一个“规则字符串”,这个“规则字符串”用来判断我们给定的字符串 ...
- JavaScript正则表达式,你真的知道?
一.前言 粗浅的编写正则表达式,是造成性能瓶颈的主要原因.如下: var reg1 = /(A+A+)+B/; var reg2 = /AA+B/; 上述两个正则表达式,匹配效果是一样的,但是,效率就 ...
- Python 正则表达式入门(中级篇)
Python 正则表达式入门(中级篇) 初级篇链接:http://www.cnblogs.com/chuxiuhong/p/5885073.html 上一篇我们说在这一篇里,我们会介绍子表达式,向前向 ...
- 【JS基础】正则表达式
正则表达式的() [] {}有不同的意思. () 是为了提取匹配的字符串.表达式中有几个()就有几个相应的匹配字符串. (\s*)表示连续空格的字符串. []是定义匹配的字符范围.比如 [a-zA-Z ...
- JavaScript 正则表达式语法
定义 JavaScript定义正则表达式有两种方法. 1.RegExp构造函数 var pattern = new RegExp("[bc]at","i"); ...
- [jquery]jquery正则表达式验证(手机号、身份证号、中文名称)
数字判断方法:isNaN()函数 test()方法 判断字符串中是否匹配到正则表达式内容,返回的是boolean值 ( true / false ) // 验证中文名称 function isChin ...
随机推荐
- Beta Scrum Meeting汇总
第0次Alpha Scrum Meeting 第1次Alpha Scrum Meeting 第2次Alpha Scrum Meeting 第3次Alpha Scrum Meeting 第4次Alpha ...
- Spring的Ioc与DI
一.前言 Spring框架的核心基于控制反转的原理. IoC是一种将组件依赖关系的创建和管理外部化的技术. 考虑一个示例,其中Foo类依赖于Bar类的实例来执行某种处理. 传统上,Foo使用new运算 ...
- C++实现红黑树
红黑树的应用: 利用key_value对,快速查找,O(logn) socket与客户端id之间,形成映射关系(socket, id) 内存分配管理 一整块内存,不断分配小块 每分配一次,就加入到红黑 ...
- 对JavaScript中局部变量、全局变量和闭包的理解
对js中局部变量.全局变量和闭包的理解 局部变量 对于局部变量,js给出的定义是这样的:在 JavaScript函数内部声明的变量(使用 var)是局部变量,所以只能在函数内部访问它.(该变量的作用域 ...
- 『学了就忘』Linux基础 — 13、Linux系统的分区和格式化
目录 1.Linux系统的分区 (1)磁盘分区定义 (2)两种分区表形式 (3)MBR分区类型 2.Linux系统的格式化 (1)格式化定义 (2)格式化说明 1.Linux系统的分区 (1)磁盘分区 ...
- 种类并查集(维护敌人的敌人是朋友)、并行-poj1182-食物链 笔记
题意 输入若干组数据,代表着不同动物在食物链的位置(A,B,C),要求出在输入的过程中有多少组数据会与之前矛盾. 思路(借鉴挑战程序设计竞赛) 这题是学并查集时的题,所以用了并查集. 一开始我想的是, ...
- hdu 1058 Humble Numbers(构造?枚举?)
题意: 一个数的质因子如果只是2,3,5,7中的若干个.则这个数叫做humble number. 例如:1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 12, 14, 15, 16, 1 ...
- buff/cache 占用过高解决方法
cache 读磁盘时,数据从磁盘读出后,暂留在缓冲区(cache),为后续程序的使用做准备 buffer 写磁盘时,先保存到磁盘缓冲区(buffer),然后再写入到磁盘 三条命令: #echo 1 & ...
- Cobar SQL审计的设计与实现
背景介绍 Cobar简介 Cobar 是阿里开源的一款数据库中间件产品. 在业务高速增长的情况下,数据库往往成为整个业务系统的瓶颈,数据库中间件的出现就是为了解决数据库瓶颈而产生的一种中间层产品. 在 ...
- aardio 开发桌面应用,这几点必须要掌握!
1. 前言 大家好,我是安果! 上一篇文章写到可以通过 aardio 结合 Python 开发桌面应用,有些小伙伴后台给我留言,说 Aardio 资料太少,希望我能补充一些实用的功能 实用 | 利用 ...