
pandas(3):索引Index/MultiIndex
一、索引概念
“索引”类似一本书的目录(页码),通过目录(页码),让我们能快速找到想看的位置。对于一个DataFrame数据框,其中:
- 行索引(Label index),是一条完整数据的索引,通过这个索引,能快速取出对应的某条数据记录。
- 列索引(Columns Names),指向的是每一个Series。
- 行是一条完整信息记录,索引在业务上一般不允许重复,好的索引能方便处理数据,重复的索引导入数据库可能出现限制,可以设置默认配置。
- 无论是行索引还是列索引,在 Pandas 里其实都是一个** Index 对象,都有类似的属性和方法**。
- pandas的索引有不同的类型,目的都是为更方便处理数据。
二、创建索引
源Excel文件index.xlsx:
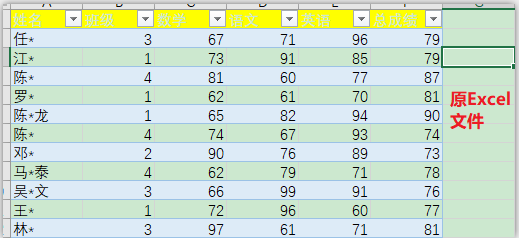
①导入数据时指定索引
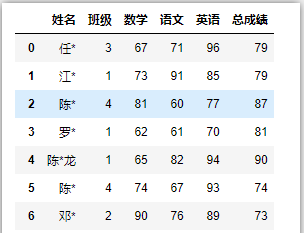
- 未指定时,python会自动生成从0开始的行索引,列名默认为第1行
pandas不知道你实际业务情况,所以只能自动生成0-N的自然索引。
df = pd.read_excel('C:/Users/asus/Desktop/index.xlsx')

df
- 自定义指定
# 指定’姓名‘或’班级‘这一列为行索引

df = pd.read_excel('C:/Users/asus/Desktop/index.xlsx',index_col='姓名')

# df = pd.read_excel('C:/Users/asus/Desktop/index.xlsx',index_col='班级')

df
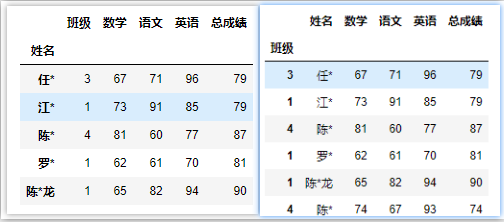
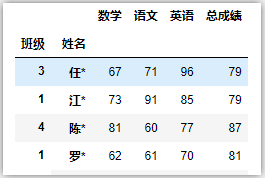
# 指定’班级‘、’姓名‘这两列为层级索引MultiIndex

df = pd.read_excel('C:/Users/asus/Desktop/index.xlsx',index_col=[1,0])

df
也可以根据header参数指定哪行作为列名,或根据names参数自定义列名,具体见:https://www.cnblogs.com/xiaoshun-mjj/p/14538695.html
②导入数据后指定索引df.set_index()
DataFrame.set_index(keys, drop=True, append=False,

                    inplace=False, verify_integrity=False)
参数说明:
- keys:列标签或列标签/列表/series,需要设置为索引的列;
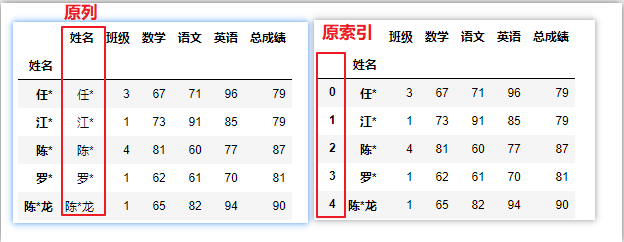
- drop:是否保留设置索引的原列。默认为True,不保留;
- append:是否保留原索引。默认为False,不保留;
- inplace:输入布尔值,表示当前操作是否对原数据生效,默认为False。
- verify_integrity:检查新索引的副本。否则,请将检查推迟到必要时进行。将其设置为false将提高该方法的性能,默认为false。
# 导入数据时,未指定索引

df = pd.read_excel('C:/Users/asus/Desktop/index.xlsx')

df.set_index('姓名') # 设置姓名为索引

df.set_index(['班级','姓名']) # 设置班级和姓名为索引
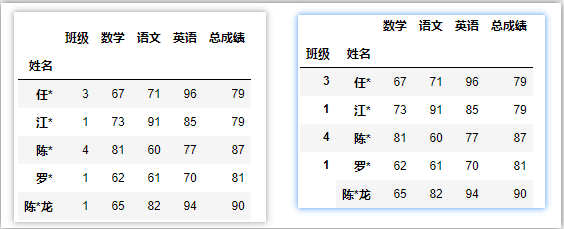
df.set_index('姓名',drop=False)  # 保留原列

df.set_index('姓名',append=True) # 保留原索引
三、常用的索引属性
以df.index为例,也适用于 df.columns, 因为两者都是 index 对象
df = pd.read_excel('C:/Users/asus/Desktop/index.xlsx') # 导入数据时,未指定索引

df.set_index('姓名',drop=False,inplace=True)  # 保留原列,对原数据生效

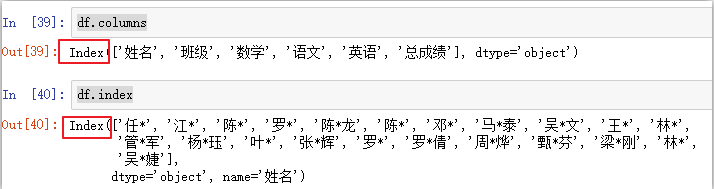
# 查看索引信息(值和类型,还有可能有名称)

df.columns

df.index
df.index.name # 行索引名称

df.index.dtype # 索引数据类型

df.index.shape # 形状

df.index.size # 元素数量,行记录条数

# df.columns.size

df.index.values # 索引的值,array 数组

# df.index.value_counts() # 去重统计

# df.index.values.tolist() # array 数组转换成列表list

df.index.is_unique # 判断是否有重复,业务上原则一般不会重复,有重复返回False
四、常用索引方法
一样适用于 df.columns。
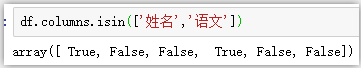
df.columns.isin(['姓名','语文']) # 是否存在,快速查看是否有该列名或行
df.index.nunique() # 不重复值的数量

df.index.sort_values(ascending=False) # 排序,倒序

df.index.to_frame(index=False) # 转成 DataFrame

df.index.unique() # 去重

df.index.value_counts() # 去重分组统计

df.index.where(df.index=='林*') # 筛选,查看是否由该行记录

df.index.max() # 最大值

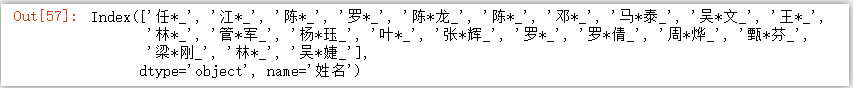
df.index.map(lambda x:x+'_') # 批量处理索引
五、索引重置reset_index()
列可以变成索引,索引也能回复成列。
DataFrame.reset_index(level=None, drop=False,

                    inplace=False, col_level=0, col_fill='')
参数说明:
- level:数值类型可以为:int、str、tuple或list,默认无,仅从索引中删除给定级别。默认情况下移除所有级别。控制了具体要还原的那个等级的索引 。
- drop:当指定drop=False时,则索引列会被还原为普通列;否则,经设置后的新索引值被会丢弃。默认为False。
- inplace:输入布尔值,表示当前操作是否对原数据生效,默认为False。
- col_level:数值类型为int或str,默认值为0,如果列有多个级别,则确定将标签插入到哪个级别。默认情况下,它将插入到第一级。
- col_fill:对象,默认‘’,如果列有多个级别,则确定其他级别的命名方式。如果没有,则重复索引名。
df = pd.read_excel('C:/Users/asus/Desktop/index.xlsx') # 导入数据时,未指定索引

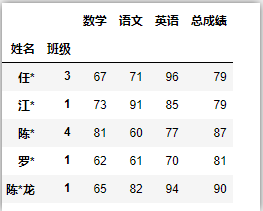
df = df.set_index(['姓名','班级']) # 设置MultiIndex

df
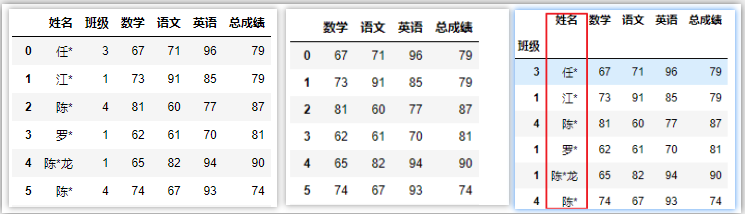
df.reset_index() # 移除所有层级索引,并把索引还原成列

df.reset_index(drop=True) # 移除所有层级索引,舍弃原索引

df.reset_index(['姓名']) # 只把姓名这一层索引还原层列
六、修改索引值(修改列名)
# 一对一对应修改

df.rename(columns={'数学': 'maths'})

# 也可以通过一些函数进行批量修改

df.rename(lambda x:'t_' + x, axis=1) # 通过lambda表达式批量给列名加前缀
pandas(3):索引Index/MultiIndex的更多相关文章
- pandas层级索引1
层级索引(hierarchical indexing) 下面创建一个Series, 在输入索引Index时,输入了由两个子list组成的list,第一个子list是外层索引,第二个list是内层索引. ...
- pandas层级索引
层级索引(hierarchical indexing) 下面创建一个Series, 在输入索引Index时,输入了由两个子list组成的list,第一个子list是外层索引,第二个list是内层索引. ...
- (三)pandas 层次化索引
pandas层次化索引 1. 创建多层行索引 1) 隐式构造 最常见的方法是给DataFrame构造函数的index参数传递两个或更多的数组 Series也可以创建多层索引 import numpy ...
- Python数据科学手册-Pandas:层级索引
一维数据 和 二维数据 分别使用Series 和 DataFrame 对象存储. 多维数据:数据索引 超过一俩个 键. Pandas提供了Panel 和 Panel4D对象 解决三维数据和四维数据. ...
- SQL Server 索引(index) 和 视图(view) 的简单介绍和操作
--索引(index)和视图(view)-- --索引(index)----概述: 数据库中的索引类似于书籍的目录,他以指针形式包含了表中一列或几列组合的新顺序,实现表中数据库的逻辑排序.索引创建在数 ...
- Handlebars.js循环中索引(@index)使用技巧(访问父级索引)
使用Handlebars.js过程中,难免会使用循环,比如构造数据表格.而使用循环,又经常会用到索引,也就是获取当前循环到第几次了,一般会以这个为序号显示在页面上. Handlebars.js中获取循 ...
- 关于分区技术的索引 index
关于分区技术---索引 Index 一. 分区索引分类: 本地前缀分区索引(local prefixedpartitioned index) 全局分区索引(global partitionedin ...
- Mysql数据库学习笔记之数据库索引(index)
什么是索引: SQL索引有两种,聚集索引和非聚集索引,索引主要目的是提高了SQL Server系统的性能,加快数据的查询速度与减少系统的响应时间. 聚集索引:该索引中键值的逻辑顺序决定了表中相应行的物 ...
- 使用jQuery+huandlebars循环中索引(@index)使用技巧(访问父级索引)
兼容ie8(很实用,复制过来,仅供技术参考,更详细内容请看源地址:http://www.cnblogs.com/iyangyuan/archive/2013/12/12/3471227.html) & ...
随机推荐
- 教你玩转CSS 伪元素
一.CSS 伪元素 CSS伪元素是用来添加一些选择器的特殊效果. 语法 伪元素的语法: selector:pseudo-element {property:value;} CSS类也可以使用伪元素: ...
- Elasticsearch---DSL搜索实践
Domain Specific Language 特定领域语言,基于JSON格式的数据查询,查询更灵活,有利于复杂查询 一.普通url路径参数搜索 数据准备 1.建立名字为 shop 的索引 2.手动 ...
- 开源OA办公平台搭建教程:O2OA表单中的事件
1. 概述 我们设计表单的时候经常会有这样的需求:在表单或者组件加载前/加载后,能够执行一些脚本来改变表单或组件的样式和行为.或者用户在点击组件的时候能够执行脚本.表单的事件就是为这样的场景而设计. ...
- JSON的stringify和parse方法
一.JSON.parse() 方法用于将一个 JSON 字符串转换为对象. 以下代码为将字符串解析为对象,然后再赋值给对象 //页面初始化完成加载,option是传递的参数 onLoad: funct ...
- springboot项目打包成jar包在Linux服务器默认80端口运行
springboot项目端口设置 在application.properties文件 server.port=80 在application.yml文件 server: port: 80 然后在ide ...
- Django批量插入数据和分页器
目录 一.ajax结合sweetalert实现删除按钮动态效果 二.bulk_create批量插入数据 1. 一条一条插入 2. 批量插入 三.自定义分页器 一.ajax结合sweetalert实现删 ...
- 阿里云CentOS8.0服务器配置Django3.0+Python 3.7 环境
---恢复内容开始--- 1. 下载并安装python # 安装Python3.7.6 wget https://www.python.org/ftp/python/3.7.6/Python-3.7. ...
- 一文讲通.NET Core部署到Windows IIS最全解决方案
回顾之前的ASP.NET的经典托管 在经典ASP.NET应用程序中,所有一切都托管在IIS工作进程中(w3wp.exe),这也被称为IIS应用程序池.ASP.NET程序被托管在应用程序池中,并且被按照 ...
- 【老孟Flutter】Flutter 2.0 重磅更新
老孟导读:昨天期待已久的 Flutter 2.0 终于发布了,Web 端终于提正了,春季期间我发布的一篇文章,其中的一个预测就是 Web 正式发布,已经实现了,还有一个预测是:2021年将是 Flut ...
- Linux下基础命令
(1)ls(查看列表) (2)ls -l(查看列出文件详细信息) (3)ls -al (查看全部列出文件详细信息) (4)ls -dl(查看目录信息) (5)pwd(查看当前工作的目录) ...