
HashMap 原理?jdk1.7 与 1.8区别
HashMap 结构 以及 1.7 与 1.8
一、区别
01. jdk 1.7 用的是头插法,而jdk1.8以后使用的是尾插法?为什么这样做呢?因为 JDK 1.7 是用单链表进行纵向延伸,采用头插法时会出现逆序循环链表死循环的问题,在 jdk 1.8 之后是
因为加入了红黑树,使用尾插法,能够避免出现逆序且链表死循环的问题。
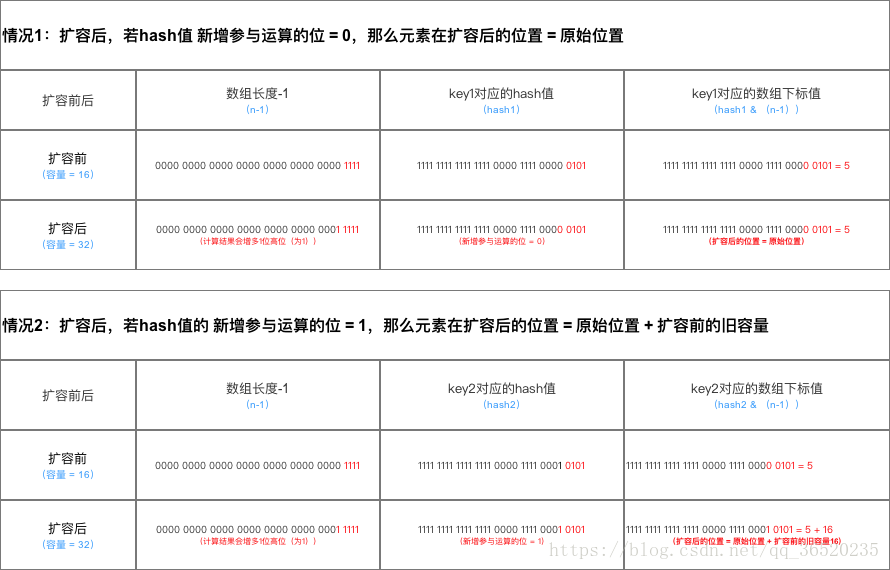
02.扩容后数据存储位置的计算方式也不一样,在 jdk1.7 的时候是直接用 hash 值和需要扩容的二进制数进行,()
03.jdk1.8 的时候直接使用了 jdk1.7 的时候计算的规律,也就是扩容前的原始位置+扩容的大小值 = jdk1.8 的计算方式,而不再是 jdk1.7 的那种异或方式。
但这种方式就相当于只需要判断 hash 值的新增参与运算的位置是0 还是1 就直接迅速计算出扩容后的存储方式
在计算 hash 值的时候, jdk1.7 用了9次扰动处理 = 4次位运算+5次异或,而jdk1.8 只用了2次扰动处理 = 1次位运算+1 次异或
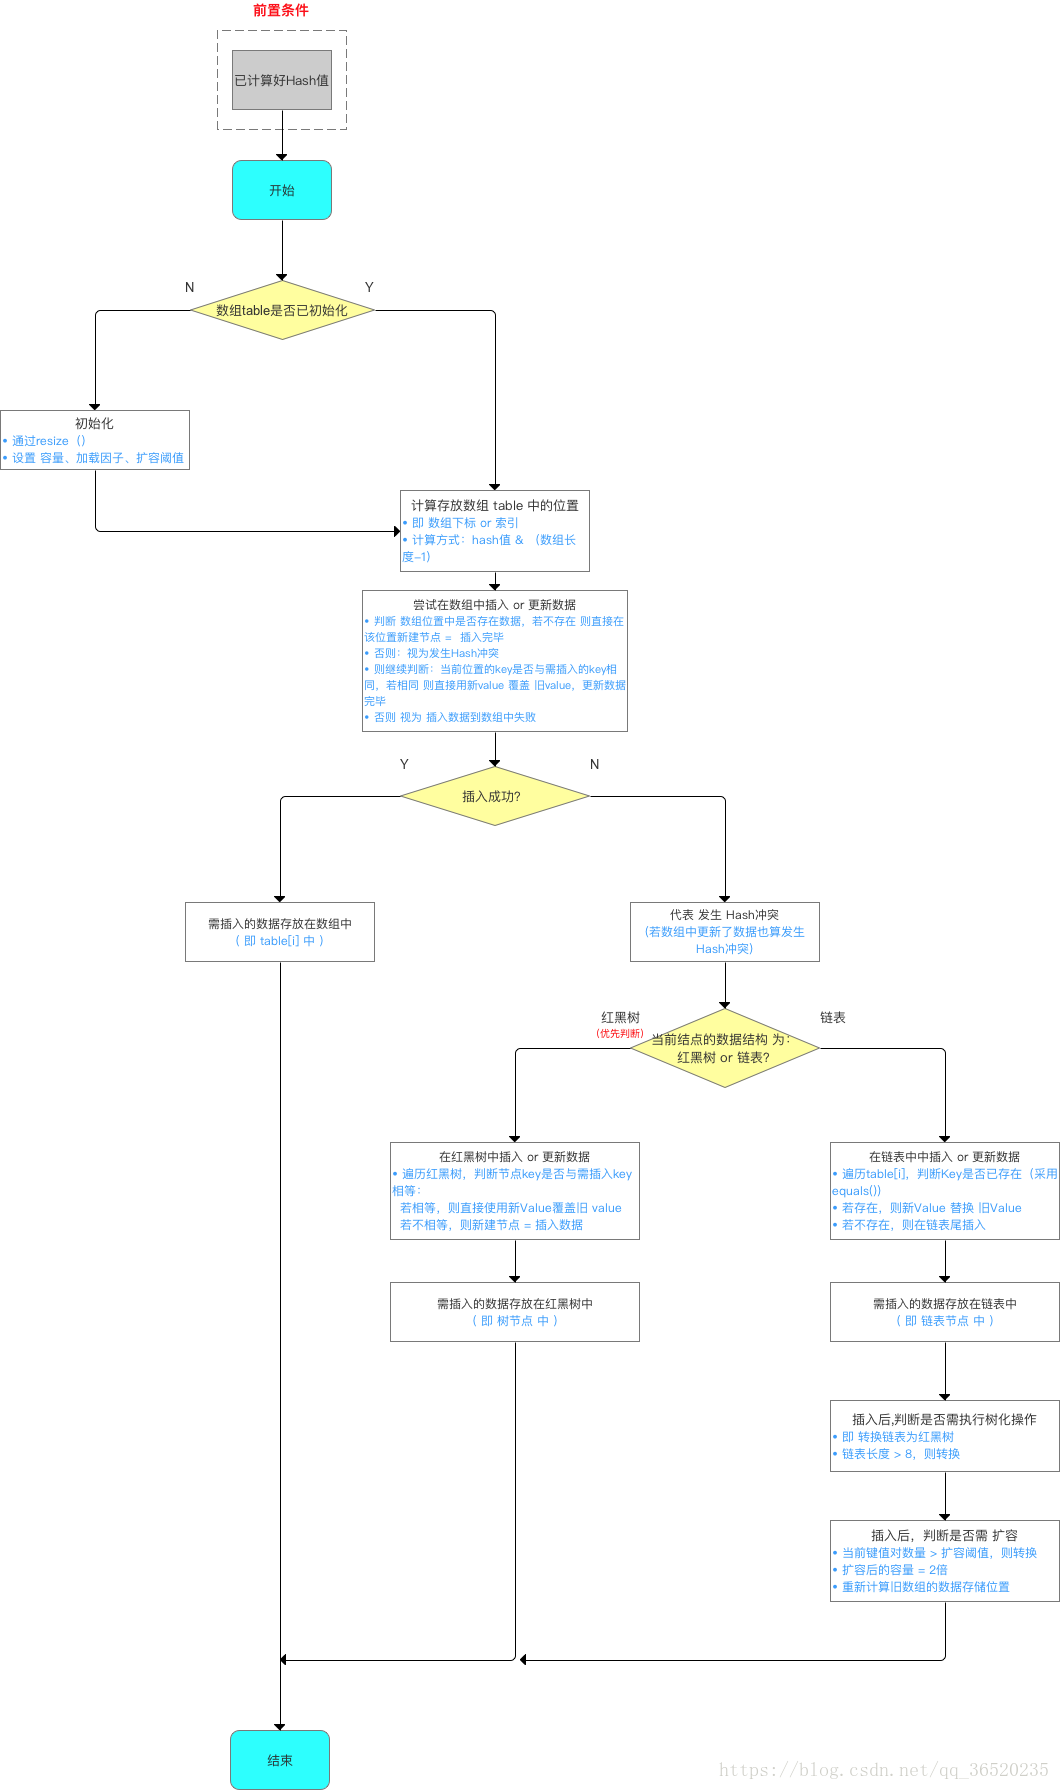
扩容流程对比:

JDK1.7 的时候使用的是数组+单链表的数据结构。但是在 jdK1.8 之后时,使用的是数组+链表+红黑树的数据结构,当链表深度达8的时候,也就是默认伐值,就会自动扩容把链表转换成红黑树的
数据结构把时间复杂度从O(n) 变成 O(logN),提高效率
补充:
01.为什么在 JDK1.7 的时候是先进行扩容后进行插入,而在 jdk1.8 的时候是先插入再进行扩容呢?
//其实就是当这个Map中实际插入的键值对的值的大小如果大于这个默认的阈值的时候(初始是16*0.75=12)的时候才会触发扩容,

//这个是在JDK1.8中的先插入后扩容

if (++size > threshold)

            resize();
其实这个问题也是 jdk8 对 hashMap 中,主要是因为对链表转化为红黑树进行的优化,因为插入这个节点的时候有可能是普通链表节点,也有可能是红黑树节点,但是为社么1.8之后HashMap 变为先插入后扩容的原因?,,
但是在 jdK1.7中的话是先扩容后进行插入的,就是当你发现你插入的桶是不是为空,如果不为空说明存在的值发生了hash 冲突,那么必须得扩容,但是如果不发生 hash 冲突的话,说明当前桶是空的,那就等到下次hash
冲突的时候扩容。
为社么 jdk 1.8 在进行对 HashMap 优化的时候,把链表转换为红黑树的阈值是8,而不是7 或者20等等?
二、哈希表如何解决 Hash 冲突?

三、为什么 HashMap 具备如下特点: 键值都运行为空,线程不安全,不保证有序,存储位置随时间变化

四、为什么 Hashmap 中 String 、Integer 这样的包装类适合作为 key 键

参考:https://blog.csdn.net/qq_36520235/article/details/82417949
参考:https://www.jianshu.com/p/8324a34577a0?utm_source=oschina-app
HashMap 原理?jdk1.7 与 1.8区别的更多相关文章
- 牛客网Java刷题知识点之HashMap的实现原理、HashMap的存储结构、HashMap在JDK1.6、JDK1.7、JDK1.8之间的差异以及带来的性能影响
不多说,直接上干货! 福利 => 每天都推送 欢迎大家,关注微信扫码并加入我的4个微信公众号: 大数据躺过的坑 Java从入门到架构师 人工智能躺过的坑 ...
- HashMap实现原理(jdk1.7),源码分析
HashMap实现原理(jdk1.7),源码分析 HashMap是一个用来存储Key-Value键值对的集合,每一个键值对都是一个Entry对象,这些Entry被以某种方式分散在一个数组中,这个数 ...
- 超详细的HashMap解析(jdk1.8)
目录 一.预备知识 时间复杂度 基本数据结构 基本位运算 二.HashMap实现原理 结构 速度 三.源码分析 基本常量 基本成员变量 构造方法 put方法 remove 四.日常使用注意事项 五.总 ...
- java中HashMap原理?
参考:https://www.cnblogs.com/yuanblog/p/4441017.html(推荐) https://blog.csdn.net/a745233700/article/deta ...
- HashMap在JDK1.8中并发操作,代码测试以及源码分析
HashMap在JDK1.8中并发操作不会出现死循环,只会出现缺数据.测试如下: package JDKSource; import java.util.HashMap; import java.ut ...
- ==和equasl、hashmap原理(***)
public class String01 { public static void main(String[] args) { String a="test"; String b ...
- Java集合类源码解析:HashMap (基于JDK1.8)
目录 前言 HashMap的数据结构 深入源码 两个参数 成员变量 四个构造方法 插入数据的方法:put() 哈希函数:hash() 动态扩容:resize() 节点树化.红黑树的拆分 节点树化 红黑 ...
- Java:HashMap原理与设计缘由
前言 Java中使用最多的数据结构基本就是ArrayList和HashMap,HashMap的原理也常常出现在各种面试题中,本文就HashMap的设计与设计缘由作出一一讲解,并解答面试常见的一些问题. ...
- Java基础-hashMap原理剖析
Java基础-hashMap原理剖析 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 一.什么是哈希(Hash) 答:Hash就是散列,即把对象打散.举个例子,有100000条数 ...
- HashMap,Hashset,ArrayList以及LinkedList集合的区别,以及各自的用法
基础内容 容器就是一种装其他各种对象的器皿.java.util包 容器:Set, List, Map ,数组.只有这四种容器. Collection(集合) 一个一个往里装,Map 一对一对往里装. ...
随机推荐
- 唠唠C++二级指针、二维数组、指针数组、数组指针等的区分
今天看c++primer第六章,有这部分的内容,脑子有点糊涂了,看了几篇博客,自己敲了下,记录一下备忘. 二级指针: int **p; 二维数组: int p[10][10]; char q[10][ ...
- Java连载82-Set、Collection、List、Map的UML演示
一.UML演示Collection集合的继承结构图 二.Set集合 1.List存储元素的特点:有序可重复.有序,存进去是什么顺序,拿出来还是什么顺序. 2.Set存储元素的特点:无序不可重复,存进去 ...
- 集合转换为数组toArray(),数组转换为集合asList()
package seday12; import java.util.ArrayList;import java.util.Arrays;import java.util.Collection; /** ...
- Spring Boot框架 - 数据访问 - JDBC&自动配置
一.新建Spring Boot 工程 特殊勾选数据库相关两个依赖 Mysql Driver — 数据库驱动 Spring Data JDBC 二.配置文件application.properties ...
- celery task - 2
# celery task 前言 讨论一个定时任务,一般而言,需要的功能如下: 封装成对象,独立执行: 对象有一些接口,便于了解它的状态: 定时调用: 行为控制,包括重试,成功/失败回调等: 下面分别 ...
- ${var}与$var的区别,个人总结的看法
${var} set variable 123 ${var}类似于变量值,相当于123 $var类似于变量名,指向对应的存储位置,相当于“123”,一般只有在rf关键字为断言的如“should be ...
- LVS+Keepalived -----> 效率最高的负载均衡器
一. 简介 1. 负载均衡的类型 负载均衡可以采用硬件设备(例如常常听见的 F5),也可以采用软件负载 商用硬件负载设备成本通常较高(一台几十万甚至上百万),所以一般 情况下会采用软件负载 软件负 ...
- P1067
这题没什么好说的,就是判断,需要考虑仔细一点. AC代码: #include <bits/stdc++.h> using namespace std; const int N = 712; ...
- C++实现对MySQL数据库的连接,以及增删改查
安装好MySQL,建好数据表的前提下. 如果只是想简单实现添加数据或者其他一个操作数据,可以参考另一篇博客. https://www.cnblogs.com/ming-4/p/11544514.htm ...
- Bugku-CTF加密篇之散乱的密文(lf5{ag024c483549d7fd@@1} 一张纸条上凌乱的写着2 1 6 5 3 4)
散乱的密文 lf5{ag024c483549d7fd@@1} 一张纸条上凌乱的写着2 1 6 5 3 4