
Elasticsearch之常见问题
一. 聚合操作时,报Fielddata is disabled on text fields by default
GET /megacorp/employee/_search

{

  "aggs": {

    "all_interests": {

      "terms": {"field": "interests" }

    }

  }

}

{ "error": { "root_cause": [ { "type": "illegal_argument_exception", "reason": "Fielddata is disabled on text fields by default. Set fielddata=true on [interests] in order to load fielddata in memory by uninverting the inverted index. Note that this can however use significant memory. Alternatively use a keyword field instead." } ], "type": "search_phase_execution_exception", "reason": "all shards failed", "phase": "query", "grouped": true, "failed_shards": [ { "shard": 0, "index": "megacorp", "node": "sNvWT__lQl6p0dMTRaAOAg", "reason": { "type": "illegal_argument_exception", "reason": "Fielddata is disabled on text fields by default. Set fielddata=true on [interests] in order to load fielddata in memory by uninverting the inverted index. Note that this can however use significant memory. Alternatively use a keyword field instead." } } ], "caused_by": { "type": "illegal_argument_exception", "reason": "Fielddata is disabled on text fields by default. Set fielddata=true on [interests] in order to load fielddata in memory by uninverting the inverted index. Note that this can however use significant memory. Alternatively use a keyword field instead.", "caused_by": { "type": "illegal_argument_exception", "reason": "Fielddata is disabled on text fields by default. Set fielddata=true on [interests] in order to load fielddata in memory by uninverting the inverted index. Note that this can however use significant memory. Alternatively use a keyword field instead." } } }, "status": 400 }
text类型的字段在查询时使用的是在内存中的称为fielddata的数据结构。这种数据结构是在第一次将字段用于聚合/排序/脚本时基于需求建立的。
它通过读取磁盘上每个segmet上所有的倒排索引来构建,反转term和document的关系(倒排),并将结果存在Java堆上(内存中)。(因此会耗费很多的堆空间,特别是在加载很高基数的text字段时)。一旦fielddata被加载到堆中,它在segment中的生命周期还是存在的。
因此,加载fielddata是一个非常消耗资源的过程,甚至能导致用户体验到延迟.这就是为什么 fielddata 默认关闭。
PUT megacorp/_mapping/employee/

{

  "properties": {

    "interests": {

      "type":     "text",

      "fielddata": true

    }

  }

}
二.Too many dynamic script compilations within, max: [75/5m]
需要设置索引允许最大编译速度
curl -X PUT "localhost:9200/_cluster/settings" -H 'Content-Type: application/json' -d'{ "transient": { "script.max_compilations_rate": "100000/1m"}}'
三. max virtual memory areas vm.max_map_count [65530] is too low, increase to at least [262144]
在root用户下
临时修改:
sysctl -w vm.max_map_count=262144

sysctl -p

# 重启恢复原值
永久修改:
echo "vm.max_map_count=262144" > /etc/sysctl.conf

sysctl -p
四. the default discovery settings are unsuitable for production use; at least one of [discovery.seed_hosts, discovery.seed_providers, cluster.initial_master_nodes] must be configured
cluster.name: "docker-cluster"

network.host: 0.0.0.0

# custom config

node.name: "node-1"

discovery.seed_hosts: ["127.0.0.1", "[::1]"]

cluster.initial_master_nodes: ["node-1"]

# 开启跨域访问支持,默认为false

http.cors.enabled: true

# 跨域访问允许的域名地址,(允许所有域名)以上使用正则

http.cors.allow-origin: /.*/

重点: node.name 和 cluster.initial_master_nodes 设置
rm -rf /elasticsearch/data/*
同一个index新增type报错 Rejecting mapping update to [website] as the final mapping would have more than 1 type: [blog2, blog]
7之后, 已经不推荐使用type,所以在添加数据的时候可以不指定type即可
七.
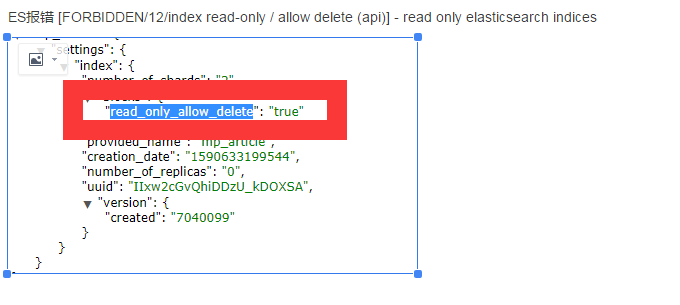
原因: 磁盘空间不足, 超过95%, 则开启只读模式, 可以进行数据删除 ( df -h 查看)
{

  "index": {

    "blocks": {

      "read_only_allow_delete": "false"

    }

  }

}
八. Can't update non dynamic settings [[index.analysis.filter
场景: 在为索引添加分词器的时候, 发生报错
解决方案: 先关闭索引, 再进行设置, 设置完成之后, 重新打开索引即可
# 关闭索引

POST mp_account2/_close

# 设置分词器

PUT mp_account2/_settings

{

  "index": {

    "analysis": {

      "analyzer": {

        "ik_pinyin_analyzer": {

          "type": "custom",

          "tokenizer": "ik_smart",

          "filter": "pinyin_filter"

        }

      },

      "filter": {

        "pinyin_filter": {

          "type": "pinyin",

          "keep_first_letter": false

        }

      }

    }

  }

}

# 开启索引

POST mp_account2/_open
9. docker启动elasticsearch异常Exception in thread "main" java.nio.file.NoSuchFileException: /usr/share/elasticsearch/config/jvm.options
由于我的elasticsearch启动时使用的是docker-compose方式,并配置了config目录的挂载数据卷,而启动时宿主机的挂载数据文件夹中并没有jvm.options文件,因此出现该文件找不到的情况。
解决办法:
先将挂载数据卷配置注释,启动elasticsearch后将elasticsearch容器中的config/文件夹下的文件拷出到宿主机,重新启动即可。
1).将容器中文件拷出到宿主机挂载卷文件夹下
docker cp [容器ID]:容器文件路径 要拷贝的宿主机路径
例如我的:
docker cp 2a202fa:/usr/share/elasticsearch/plugins/ ./es/es-with-ik-plugins/
2).开启挂载卷配置,重新启动elasticsearch
Elasticsearch之常见问题的更多相关文章
- elasticsearch启动常见问题
原文:https://blog.csdn.net/qq_22211217/article/details/80740873 一.Exception in thread "main" ...
- ELK学习003:Elasticsearch启动常见问题
一.Caused by: java.lang.RuntimeException: can not run elasticsearch as root 这个错误,是因为使用root用户启动elastic ...
- Elasticsearch 5
Elasticsearch 5常见问题解决方案 安装运行 1.前置安装java8 jdk-8u112-linux-x64.rpm 下载地址:http://www.oracle.com/tech ...
- ELK Stack 笔记
ELK Stack ELK Stack ELK Stack ELK 介绍 架构 Elasticsearch 安装 常见问题 关闭 Elasticsearch Elasticsearch-head Ki ...
- ES 02 - 部署Elasticsearch单机服务 + 部署中的常见问题
目录 1 准备工作 1.1 安装JDK 1.2 下载安装包 1.3 创建elastic用户 2 启动ES服务 2.1 修改配置文件 2.2 启动服务 3 验证ES服务是否可用 4 关闭与重启服务 4. ...
- Elasticsearch 常见问题的解决思路
本文为es性能监控基础的扩展,大家可以先看下性能监控基础,熟悉下es的基本原理.为翻译性质文档,感谢原作者,原始文档地址 类似于汽车的运行方式,Elasticsearch旨在让用户快速上手和运行,而无 ...
- ElasticSearch 常见问题
ElasticSearch 常见问题 丈夫有泪不轻弹,只因未到伤心处. 1.说说 es 的一些调优手段. 仅索引层面调优手段: 1.1.设计阶段调优 (1)根据业务增量需求,采取基于日期模板创建索引, ...
- 搭建Elasticsearch集群常见问题
一.ES安装方法: Linux用户登录(bae),我们用的是5.3版本的包.从官网下载: curl -L -O https://artifacts.elastic.co/downloads/elast ...
- 安装elasticsearch 5.x, 6.x 常见问题(坑)的解决
本人在elasticsearch 5.x, 6.x 安装过程中遇到了一些问题: 警告提示 [2016-11-06T16:27:21,712][WARN ][o.e.b.JNANatives ] una ...
- 内存吞金兽(Elasticsearch)的那些事儿 -- 常见问题痛点及解决方案
1.大数据量的查询效率如何保证: 查询的流程:往 ES 里写的数据,实际上都写到磁盘文件里去了,查询的时候,操作系统会将磁盘文件里的数据自动缓存到 Filesystem Cache 里面去 最佳的情况 ...
随机推荐
- Mongodb入门2
$push 修饰符:用于往数组中追加元素 db.workmates.update({name:'xiaowang'},{$push:{interseta:"PHP"}}) ...
- SQL Server – 冷知识 (新手)
前言 没有系统化学一本语言或技术, 那便会被一些冷知识坑. 这里做些记入. 变量作用域 SQL 是远古语法, 声明变量在最顶部就是一条上古法则. 如果我看见有了用这个法则写 C# 或 JS 我就会杀了 ...
- Vue3.5中解构props,让父子组件通信更加丝滑
前言 在Vue3.5版本中响应式 Props 解构终于正式转正了,这个功能之前一直是试验性的.这篇文章来带你搞清楚,一个String类型的props经过解构后明明应该是一个常量了,为什么还没丢失响应式 ...
- QT疑难杂症之如何使用自定义模型实现文件系统模型?类似QFileSystemModel,却比QFileSystemModel更好用
简介 本文讨论了QT文件系统模型QFileSystemModel的不足之处,并且讨论了改进目标,如何实现自定义文件系统模型,以及进一步改进的空间. 目录 QFileSystemModel的不足之处 改 ...
- 组件传参v-model语法糖只能写一次的解决办法
v-model 的使用 解决只能使用一次v-model的问题:使用 sync 修饰符
- C#中测试普通方法和对象类型以及泛型所需要的时间
using System; using System.Collections.Generic; using System.Linq; using System.Text; using System.T ...
- 2024年开源API工具盘点,覆盖API全生命周期
2024年经济持续低迷,本文整理一些免费的开源工具,旨在帮助企业组织降低工具的支出成本,能用免费的何必用付费的呢(狗头)? 如何高效地管理API的全生命周期--从设计.开发.测试.部署到监控和优化,已 ...
- k8s的pod的理解
pod共享相同的IP地址和端口空间. 这意味着在同一 pod中的容器运行的 多个进程需要注意不能绑定到相同的端口号, 否则会导致端口冲突, 但这只涉及同一pod中的容器. 由于每个pod都有独立的端口 ...
- 还在使用昂贵的虚拟机?来试试 Devbox,便宜 6 倍!
这篇小短文来介绍一下用虚拟机的场景是怎么被 Devbox 全方位碾压的. Devbox 唯一弱点是公网出口的地方不分配独立的 IP 地址,但是这对我们绝大多数场景是没有影响的,通过域名和端口访问我们的 ...
- Windows刷机-记录UltraSO工具安装错误
安装镜像刻录U盘工具UltralSO:UltraISO - ISO CD/DVD image creator, editor, burner, converter and virtual CD/DVD ...