
kaldi运行thchs30例子
首先,thchs30有两种数据库,kaldi运行的数据库最好是 thchs30-openslr。
修改run.sh里面的语音库路径 thchs30=...
修改nj线程数 等于CPU的核心数
修改cmd.sh queue.pl 改为run.pl本地机器跑
运行出现错误:
lexicon.txt验证出错
里面binary file matches
这是grep的问题,grep -v -a '<s>' | grep -v -a '</s>' | sort -u > data/dict/lexicon.txt || exit 1;
---------------------------------------------------------------------------------------------------------------------------
在线识别部分:
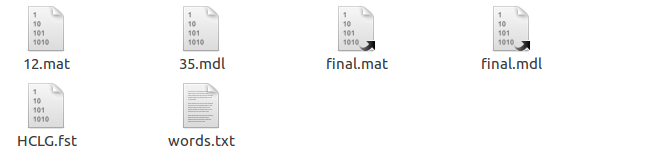
去egs下,打开voxforge,里面有个online_demo,直接考到thchs30下。在online_demo里面建2个文件夹online-data work,在online-data下建两个文件夹audio和models,audio下放你要回放的wav,models建个文件夹tri1,把s5下的exp下的tri1下的final.mdl和35.mdl(final.mdl是快捷方式)考过去。把s5下的exp下的tri1下的graph_word里面的words.txt,和HCLG.fst,考到models的tri1下。
类似处理,包括tri2b,tri3b,tri4b,不过后者需要添加转移矩阵,final.mat以及所指的mat文件。
如下所示,例如 tri2b文件夹下,
打开online_demo的run.sh
a)将下面这段注释掉:(这段是voxforge例子中下载现网的测试语料和识别模型的。我们测试语料自己准备,模型就是tri1了)
if [ ! -s ${data_file}.tar.bz2 ]; then
echo "Downloading test models and data ..."
wget -T 10 -t 3 $data_url;
if [ ! -s ${data_file}.tar.bz2 ]; then
echo "Download of $data_file has failed!"
exit 1
fi
fi
b) 然后再找到如下这句,将其路径改成tri1
ac_model_type=tri2b
if [ -s $ac_model/final.mat ]; then
trans_matrix=$ac_model/final.mat
echo "set matrix"
fi
online-gmm-decode-faster --rt-min=0.5 --rt-max=0.7 --max-active=4000 \
--beam=12.0 --acoustic-scale=0.0769 --left-context=3 --right-context=3 $ac_model/final.mdl $ac_model/HCLG.fst \
$ac_model/words.txt '1:2:3:4:5' $trans_matrix;;
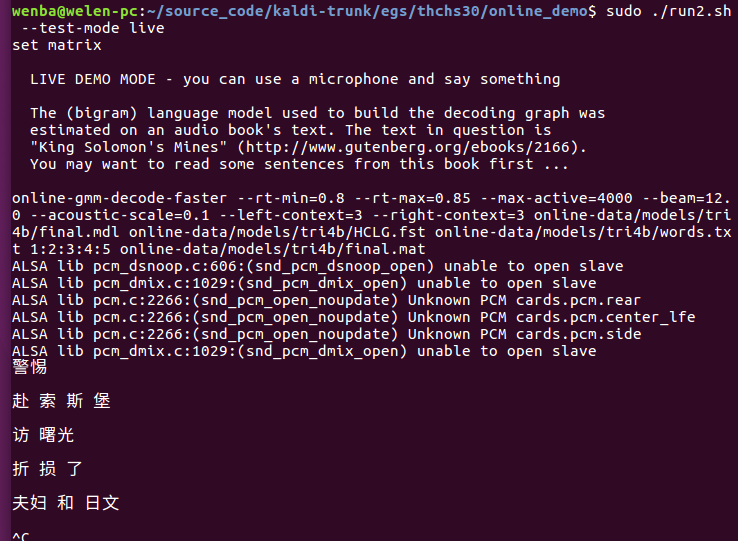
识别效果很差
kaldi运行thchs30例子的更多相关文章
- kaldi 运行voxforge例子
---------------------------------------------------------------------------------------------------- ...
- kaldi使用thchs30数据进行训练并执行识别操作
操作系统 : Ubutu18.04_x64 gcc版本 :7.4.0 数据准备及训练 数据地址: http://www.openslr.org/18/ 在 egs/thchs30/s5 建立 thch ...
- [Linux][Hadoop] 运行WordCount例子
紧接上篇,完成Hadoop的安装并跑起来之后,是该运行相关例子的时候了,而最简单最直接的例子就是HelloWorld式的WordCount例子. 参照博客进行运行:http://xiejiangl ...
- caffe简易上手指南(一)—— 运行cifar例子
简介 caffe是一个友好.易于上手的开源深度学习平台,主要用于图像的相关处理,可以支持CNN等多种深度学习网络. 基于caffe,开发者可以方便快速地开发简单的学习网络,用于分类.定位等任务,也可以 ...
- sparkR的一个运行的例子
在sparkR在配置完成的基础上,本例采用Spark on yarn模式,介绍sparkR运行的一个例子. 在spark的安装目录下,/examples/src/main/r,有一个dataframe ...
- (四)伪分布式下jdk1.6+Hadoop1.2.1+HBase0.94+Eclipse下运行wordCount例子
本篇先介绍HBase在伪分布式环境下的安装方式,然后将MapReduce编程和HBase结合起来使用,完成WordCount这个例子. HBase在伪分布环境下安装 一. 前提条件 已经成功地安装 ...
- RedHat 安装Hadoop并运行wordcount例子
1.安装 Red Hat 环境 2.安装JDK 3.下载hadoop2.8.0 http://mirrors.tuna.tsinghua.edu.cn/apache/hadoop/common/had ...
- 八、VTK安装并运行一个例子
一.版本 win10 VS2019 VTK8.2.0 其实vtk的安装过程和itk的安装过程很是类似,如果你对itk的安装很是熟悉(也就是我的博客一里面的内容,那么自己就可以安装.) 如果不放心,可以 ...
- 配置RHadoop与运行WordCount例子
1.安装R语言环境 su -c 'rpm -Uvh http://download.fedoraproject.org/pub/epel/6/i386/epel-release-6-8.noarch. ...
随机推荐
- python-django(框架结构)
项目架构: 最外层myshop目录:项目的容器,没有实质性的作用 .idea:项目的配置信息.这个文件夹是自动生成,版本控制信息等,包括历史记录.无用 manage.py:(管理项目)一个实用的命令行 ...
- js实现接口隔离
昨天公司培训了接口隔离,简单说一下 接口隔离:类间的依赖关系应该建立在最小的接口上.接口隔离原则将非常庞大.臃肿的接口拆分成更小具体的接口,这样客户讲会只需要知道他们感兴趣的方法. 接口隔离原则的目的 ...
- 项目中的Launch_getSecurityEntitle_postlaunch
研究透彻这个launch和postlaunch的执行过程才能改进他: //AppVTTicket.js ,launch:function(){ Ticketing.inciTick={}; this. ...
- Java-HashMap、HashSet、hashTable
HashMap:key:可null,重复的key对应的value会出现后面覆盖前面的情况.value:可null; 引用:数组,数组中存链表. HashSet使用HashMap的实现存储数据,所以有H ...
- HTML5新规范和CSS3新特性
1.HTML5最新规范(HTML5是HTML.XHTML以及HTML.DOM的新标准) ①用于绘画canvas元素 ②用于媒介回放的video和audio元素 ③对本地离线存储的更好支持 ④新的特俗内 ...
- Python用HTMLTestRunner生成html测试报告
小编的主机:mac 一.引入HTMLTestRunner包 1.下载HTMLTestRunner.py,已上传到网盘,点击下载 2.将HTMLTestRunner.py复制到python安装目录的Li ...
- Vue.js 入门教程
Vue.js 入门教程:https://cn.vuejs.org/v2/guide/index.html
- python3 第三十三章 - 标准库概览Part II
第二部分提供了更高级的模块用来支持专业编程的需要.这些模块很少出现在小型的脚本里. 1. 输出格式化reprlib 模块提供了一个用来缩写显示大型或深层嵌套容器的 定制版repr() . >&g ...
- 最简单的struts应用
博客园 1.搭建一个简单的Struts2应用 具体为一下几个步骤: 1.引入Struts 2工程所需运行库文件. 2.创建并配置web.xml文件 3.创建一个Action类 4.创建并配置strut ...
- Oracle学习——dmp文件(表)导入与导出
Oracle学习——dmp文件(表)导入与导出 2014-12-28 0个评论 来源:张文康 廊坊师范学院信息技术提高班 第九期 收藏 我要投稿 前言 关于dmp文件我们用的 ...