
Scala-Unit4-Scala数组/集合
一、Scala数组
1.数组的定义:
方法一:val arr = new Array[String](3)
String代表数据的元素类型、3表示数组的长度
方法二:val arr = Array[Int](1,3,5,7)
修改数组某元素:arr(1) = 18
注意:数组的长度不可改变,arr += 9(错误,数组不可添加元素),在定义数组时数据类型可以省略
2.数组的方法
1)map(映射)
object MapTest {

  def main(args: Array[String]): Unit = {

    val arr = Array[Int](1,3,5,7)

    val arr1 = arr.map(x => x*5)

    println(arr1.toBuffer)

  }

}
注意:在Scala语言中,使用toBuffer来将堆地址转换为其对应数据信息。
2)flatten(扁平化)
命令行操作:val arr = Array("hello hunter henchou","hello reba henmei")
arr.map(_.split(" ")) //res1: Array[Array[String]] = Array(Array(hello, hunter, henchou), Array(hello, reba, henmei))
arr.map(_.split(" ")).flatten //res2: Array[String] = Array(hello, hunter, henchou, hello, reba, henmei)
3)flatMap(先做map映射,再做flatten扁平化)
命令行操作:arr.flatMap(_.split(" ")) //res3: Array[String] = Array(hello, hunter, henchou, hello, reba, henmei)
4)foreach(遍历数组)
命令行操作:val arr = Array(2,4,6,8)
arr.foreach(x => print(x)) //2468
5)groupBy(分组)
命令行操作:val arr = Array("hello hunter henchou","hello reba henmei")
需求1:将arr分解成一个包含arr所有单词的数组,然后根据单词进行分类
arr.flatMap(_.split(" ")).groupBy(x => x)
//结果:res9: scala.collection.immutable.Map[String,Array[String]] = Map(reba -> Array(reba), henmei -> Array(henmei), hunter -> Array(hunter), henchou -> Array(henchou), hello -> Array(hello, hello))
需求2:将arr进行单词计数wordcount
arr.flatMap(_.split(" ")).groupBy(x => x).map(x => (x._1,x._2.length))
//结果:res12: scala.collection.immutable.Map[String,Int] = Map(reba -> 1, henmei -> 1, hunter -> 1, henchou -> 1, hello -> 2)
6)sortBy(排序)
命令行操作:val arr = Array("hello hunter henchou","hello reba henmei")
需求:将arr进行单词计数并按照降序排序:
arr.flatMap(_.split(" ")).groupBy(x => x).map(x => (x._1,x._2.length)).toList.sortBy(x => x._2)
//结果:res16: List[(String, Int)] = List((reba,1), (henmei,1), (hunter,1), (henchou,1), (hello,2))
注意:arr数组进行完groupBy后时Map集合,而Map集合不支持sortBy方法,必须将其用toLis或toArrayt转为List集合或Array数组再进行排序。
二、集合
1.集合的分类:1)可变集合(mutable)
2)不可变集合(Immutable)
2.集合的定义:
1)定义不可变集合:val s = List(1,3,5)
不可变集合元素不可修改,长度也不能改变(即不能添加元素)

可以通过命令"scala.collection.immutable."查看所有不可变集合

2)定义可变集合:定义可变集合前必须导入可变集合的包
import scala.collection.mutable._
val s = ArrayBuffer(2,4,6)
可变集合可以修改集合元素,也可以添加元素

可以通过命令”scala.collection.mutable.“查看所有可变集合
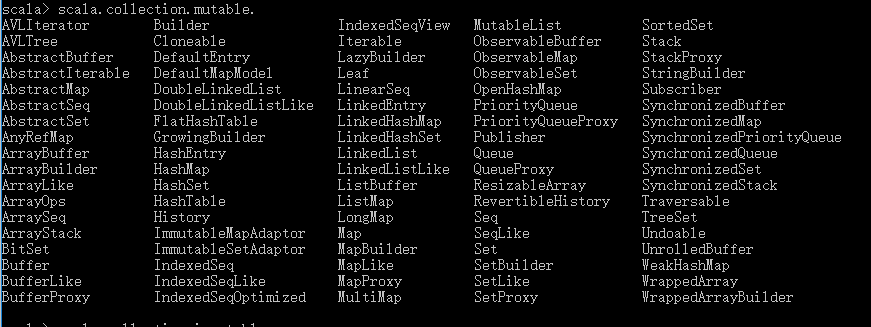
3.集合的部分方法
方法名 方法作用
head 取头元素
tail 取尾元素(除了头全是尾元素)
:: 在部分集合头部加入元素(如List,Nil,可以同时添加多个元素)
+ 字符串的拼接
.+: 在集合头部追加元素
.:+ 在集合尾部追加元素
++/++:/::: 两个集合相加合并
count 统计个数
filter 过滤
sortBy 排序(按照集合中某一个元素进行升序或降序排序)
sortWith 排序(按照条件给定的对应两个元素进行排序)
grouped 分组(按照条件数字将集合分组,如条件为2,则两两分组)
fold 折叠
foldLeft 左折叠(同fold)
foldRight 右折叠(初始值在右,按照从右到左的顺序进行计算)
reduce 聚合
aggregate 先局部聚合再全局聚合(分布式优化的方式,它底层调用的是flodLeft)
zip 拉链
sum 一个集合求和
**举例如下:
val l1 = List(4,3,5,1,9)
val l2 = List(("h",2),("r"4),("m",8))
val l3 = List(1,2,3,4,5)
var l4 = List(3)
1)取出集合l1中的头元素和尾元素
l1.head //4 l1.tail //3,5,1,9
2)算出集合l1与l3中大于4的元素个数
l1.count(x => x>4) //2
l3.count(x => x>4) //1
3)将集合l1中大于等于5的元素取出成为一个新的集合
l1.filter(x => x>=5) //(5,9)
4)新定义集合l5等于集合l4头部添加元素1,在尾部添加元素4
var l5 = l4.+:1 l5 = l4.:+4
5)将集合l2按照每个元素中的数字进行倒叙排序
l2.sortBy(x => - x._2) l2.sortWith((x,y) => x._2 > y._2)
6)将新的集合l5分别进行左折叠和右折叠相减,初始值都为2
l5.fold(2)(_ - _) //-6
l5.foldRight(2)(_ - _) //0
7)将集合l3与集合l1进行拉链
l3.zip(l1)
8)将集合l1、l3、l4进行相加形成新集合
l1:::l3:::l4
4.部分特殊集合
1)Nil:空列表
在空列表前加入多个元素: 1::2::3::Nil
2)Set集:无序的、不可重复的、不可变的集合
val s = Set(2,3,3,4) //=>得到的集合为s = (2,3,4)
s += 5 //先集合s添加元素5,语法错误
3)HashSet:可变的集合
val hs = collection.mutable.HashSet(2,3,4)
hs += 5
hs.remove(2) //删除的是元素2,而不是索引为2的元素
4)Map集:不可变
val m = Map[String,Int]("hello" -> 2,"reba" -> 8)
m("hello") //查看key为hello对应的value值
5)HashMap:可变
val hm = collection.mutable.HashMap[String,Int]()
hm.put("hunter",32) hm += "weight" -> 140 //添加元素kv对
hm.get("hunter") hm("hunter") //查看hunter对应的值
hm.remove("hunter") hm -= "hunter" //删除hunter对应的值
hm.getOrElse("hunter",28) //28 如果有值返回值,没有返回默认值,hunter对应的值被删除了
5.元祖tuple:元祖中可以是任意元素
val t = (2,"hunter",true,Unit)
t._1 //2,取出元祖中第一个元素
对偶元祖:有两个元素的元祖
val t1 = ("hunter",18)
t1.swap //(18,"hunter"),将两个元素换位
val t2 = Array(("reba",18),("hunter",32)) 用右折叠计算hunter比reba大几岁?
t2.swap
t2.foldRight(0)(_._2 - _)
Scala-Unit4-Scala数组/集合的更多相关文章
- Scala数组| 集合
arrays :+ 5尾部 头部5 +: arrays TODO 声明不可变数组,不能删; 默认情况下,scala中集合的声明全都是不可变的 val arrays: Array[Int] = Ar ...
- Scala基础:数组(Array)、映射(Map)、元组(Tuple)、集合(List)
数组 package com.zy.scala object ArrayDemo { def main(args: Array[String]): Unit = { //定长数组 val arr1 = ...
- [原创]Scala学习:数组的基本操作,数组进阶操作,多维数组
1.Scala中提供了一种数据结构-数组,其中存储相同类型的元素的固定大小的连续集合.数组用于存储数据的集合,但它往往是更加有用认为数组作为相同类型的变量的集合 2 声明数组变量: 要使用的程序的数组 ...
- 2. scala中的数组
一. 数组声明 定长数组 scala> new Array[String](5) res1: Array[String] = Array(null, null, null, null, null ...
- Scala学习(三)----数组相关操作
数组相关操作 摘要: 本篇主要学习如何在Scala中操作数组.Java和C++程序员通常会选用数组或近似的结构(比如数组列表或向量)来收集一组元素.在Scala中,我们的选择更多,不过现在我们先假定不 ...
- Scala详解---------数组、元组、映射
一.数组 1.定长数组 声明数组的两种形式: 声明指定长度的数组 val 数组名= new Array[类型](数组长度) 提供数组初始值的数组,无需new关键字 Scala声明数组时,需要带有Arr ...
- Scala具体解释---------数组、元组、映射
一.数组 1.定长数组 声明数组的两种形式: 声明指定长度的数组 val 数组名= new Array[类型](数组长度) 提供数组初始值的数组,无需newkeyword Scala声明数组时.须要带 ...
- Scala集合和Java集合对应转换关系
作者:Syn良子 出处:http://www.cnblogs.com/cssdongl 转载请注明出处 用Scala编码的时候,经常会遇到scala集合和Java集合互相转换的case,特意mark一 ...
- 【Scala】Scala之String
一.前言 大数据领域的Spark.Kafka.Summingbird等都是由Scala语言编写而成,相比Java而言,Scala更精炼.由于笔者从事大数据相关的工作,所以有必要好好学习Scala语言, ...
- 【Scala】Scala技术栈
快速了解Scala技术栈 我无可救药地成为了Scala的超级粉丝.在我使用Scala开发项目以及编写框架后,它就仿佛凝聚成为一个巨大的黑洞,吸引力使我不得不飞向它,以至于开始背离Java.固然Java ...
随机推荐
- 牛客网 python 求解立方根
•计算一个数字的立方根,不使用库函数 详细描述: •接口说明 原型: public static double getCubeRoot(double input) 输入:double 待求解参数 返回 ...
- tp5结合FormData实现ajax文件上传
或者使用: 下面使用jquery.form.js的表单插件来提交表单
- kotlin学习笔记-异常好玩的list集合总结
不积跬步无以至千里,不积小流无以成江海 先看看Kotlin中for循环的遍历 fun testList(){ var StringVal = "12_12_13_15_a_b_c_d_yu_ ...
- 在 Confluence 中启用 HTTP 响应压缩
Confluence 能够支持 HTTP 的 GZip 传输编码.这个意味着 Confluence 将可以把数据压缩后传输给用户,这种配置能够针对不稳定的互联网状态下的传输速度缓慢和不稳定并且能够降低 ...
- Confluence 6 配置推荐更新邮件通知默认的初始化设置
Confluence 为订阅者发送常规邮件报告,这个邮件报告中包含有用户具有查看权限的空间的最新的内容.这个被称为 推荐更新(Recommended Updates)通知. 如果你具有 Conflue ...
- 为什么在移动端用rem圆角不圆
rem是根据网页效果图的尺寸来计算的,当然还要借助媒体查询来完成.例如你的设计稿如果是宽720px的话,那你的文字就要以原始大小除以11.25,就是对应下面媒体查询720px:例如16px的话就要16 ...
- SpringBoot集成Shiro
Shiro是一个安全框架,控制登陆,角色权限管理(身份认证.授权.回话管理.加密) Shiro不会去维护用户,维护权限:这些需要通过realm让开发人员自己注入 1.在pom.xml中引入shiro的 ...
- Java并发编程基础-ReentrantLock的机制
同步锁: 我们知道,锁是用来控制多个线程访问共享资源的方式,一般来说,一个锁能够防止多个线程同时访问共享资源,在Lock接口出现之前,Java应用程序只能依靠synchronized关键字来实现同步锁 ...
- Django标签&迭代&循环&过滤
1.{% for Person in persons %}模板标签的替换,就是利用了基础模板的底层设计,嵌套了其他显示的内容.常见的内容替换标签{% block content %}{%endbloc ...
- Happiness
1575: Happiness 时间限制: 1 Sec 内存限制: 1280 MB 题目描述 Chicken brother is very happy today, because he atta ...