
python网络爬虫入门(一)
爬虫系列的第一篇文章,本篇帮助不大(只能教你利用requests库获取HTML),后续篇(二)会有案例讲解。
python版本:python 3.7.0b1
IDE:PyCharm 2016.3.2
涉及模块:requests & builtwith & whois
模块安装方法:Win+R 进入cmd, 进入文件夹Scripts
命令:pip install requests / pip install requests / pip install whois(如不能正确安装,请留言或自行百度解决)
如要在PyCharm中使用库,先添加一下(添加方法)。
话不多说,先上代码:
 #coding : utf-8

 import requests

 import builtwith    #引入所需python库

 print("开始爬取")

 url = "https://www.wenjiwu.com/doc/uqzlni.html"     #爬取对象网址

 r = requests.get(url)        #requests模块get方法

 print (r.status_code)        #xxx.status_code方法,返回值若为200,则爬取成功

 print (r.text)                  #xxx.text方法,得到URL对应HTML源码

 print (builtwith.parse(url)) #builtwith模块将URL作为参数,返回该网站使用的技术
(url网址随意,baidu, imooc...都可以)
脚本运行结果:
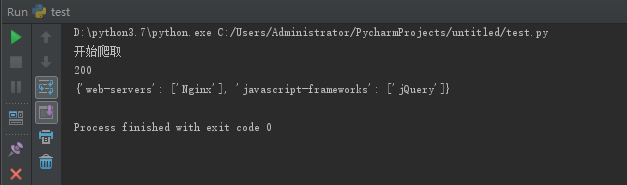
可以看到,程序正常运行,返回值200,爬取成功,builtwith模块得到了示例网站 web-servers: Nginx(服务器类型,详细了解),
使用了jQuery的javascript框架。但是碍于篇幅,其中HTML源码内容运行时注释掉了,不要惊讶!!!
r.text 结果(部分):

(内容无意中伤 Single Dog, Me too #_# )
补充:写成函数形式
 #coding : utf-8

 import requests

 import whois

 import builtwith

 def download(url, x):

     print ("downloading...")

     ans = requests.get(url)

     islink = ans.status_code        # '''通行码'''

     user = whois.whois(url)        #'''网站所有者'''

     pattern = builtwith.parse(url)  #'''网站类型'''

     result = ans.text               #'''网站内容HTML'''

     if islink == 200:

         print ("successfully link!")

     else:

         print ("Sorry, it is no found!")

     if x == 'y':

         print ('owner: ', user)

         print ('pattern: ', pattern)

         print ('text: ', result)

         return result

     else:

         return 000

 url = "https://www.baidu.com"

 download(url, 'y')
补充:把爬取的内容写入txt文件
  # 写入*.txt文件

 f = open("D:\python3.7\\testf.txt", mode='a', errors='ignore')

 for x in ans.text:

      f.write(x)

 f.close()
文件地址随意,errors=‘ignore’是为了防止诸如 ...'\xe7'..., illegal multibyte sequence转码问题的出现。
转载请注明出处,欢迎留言讨论。
python网络爬虫入门(一)的更多相关文章
- python网络爬虫入门范例
python网络爬虫入门范例 Windows用户建议安装anaconda,因为有些套件难以安装. 安装使用pip install * 找出所有含有特定标签的HTML元素 找出含有特定CSS属性的元素 ...
- Python网络爬虫入门篇
1. 预备知识 学习者需要预先掌握Python的数字类型.字符串类型.分支.循环.函数.列表类型.字典类型.文件和第三方库使用等概念和编程方法. 2. Python爬虫基本流程 a. 发送请求 使用 ...
- Python网络爬虫入门实战(爬取最近7天的天气以及最高/最低气温)
_ 前言 本文文字及图片来源于网络,仅供学习.交流使用,不具有任何商业用途,版权归原作者所有,如有问题请及时联系我们以作处理. 作者: Bo_wen 最近两天学习了一下python,并自己写了一个 ...
- python网络爬虫入门(二)
刚去看了一下,18年2月份写了第一篇关于爬虫的文章(仅仅介绍了使用requests库去获取HTML代码),一年多之后看来很稚嫩也没有多少参考的意义,但没想着要去修改它,留着也是一个回忆吧.至少证明着我 ...
- python网络爬虫-入门(二)
为什么要学网络爬虫 可以替代人工从网页中找到数据并复制粘贴到excel中,这种重复性的工作不仅浪费时间还一不留神还会出错----解决无法自动化和无法实时获取数据 对于这些公开数据的应用价值,我 ...
- python网络爬虫-入门(一)
前言 1.爬虫程序是Dt(Data Technology,数据技术)收集信息的基础,爬取到目标网站的资料后,就可以分析和建立应用了. 2.python是一个简单.有效的语言,爬虫所需要的获取.存储.整 ...
- Python网络爬虫实战(一)快速入门
本系列从零开始阐述如何编写Python网络爬虫,以及网络爬虫中容易遇到的问题,比如具有反爬,加密的网站,还有爬虫拿不到数据,以及登录验证等问题,会伴随大量网站的爬虫实战来进行. 我们编写网络爬虫最主要 ...
- python网络爬虫之入门[一]
目录 前言 一.探讨什么是python网络爬虫? 二.一个针对于网络传输的抓包工具fiddler 三.学习request模块来爬取第一个网页 * 扩展内容(爬取top250的网页) 后记 @(目录) ...
- python网络爬虫实战之快速入门
本系列从零开始阐述如何编写Python网络爬虫,以及网络爬虫中容易遇到的问题,比如具有反爬,加密的网站,还有爬虫拿不到数据,以及登录验证等问题,会伴随大量网站的爬虫实战来进行. 我们编写网络爬虫最主要 ...
随机推荐
- 数据库占用cpu较高的查询
近来看到别人的有关数据库查询cpu占用较高的sql语句(本人sql并不好),所以查询了一下资料,记录一下,便于理解和应用. 首先,将语句贴在这里 SELECT TOP 10 --平均cpu时间 tot ...
- flink-kafka-connector 的实现
简单介绍 flink-kafka-connector用来连接kafka,用于消费kafka的数据, 并传入给下游的算子. 使用方式 首先来看下flink-kafka-connector的简单使用, 在 ...
- react-native热更新之CodePush详细介绍及使用方法
react-native热更新之CodePush详细介绍及使用方法 2018年03月04日 17:03:21 clf_programing 阅读数:7979 标签: react native热更新co ...
- Prometheus 入门与实践
原文链接:https://www.ibm.com/developerworks/cn/cloud/library/cl-lo-prometheus-getting-started-and-practi ...
- Android中设置控件的背景颜色的方式整理
版权声明:本文为博主原创文章,未经博主允许不得转载. 前言 在Android开发中,经常需要设置控件的背景颜色或者图片的src颜色. 效果图 代码分析 根据使用的方法不同,划分为 setBackgro ...
- css自适应布局之“圣杯双飞翼”
首先,这个这么扯淡又装逼的名字不知道是谁起的,大意就是说:中间的内容随着浏览器宽度的不同,进行宽度自适应操作,而两边的内容固定宽度. 来,上个代码演示一下: <style> *{ marg ...
- 基本排序算法Golang
摘要 排序有内部排序和外部排序,内部排序是数据记录在内存中进行排序,而外部排序是因排序的数据很大,一次不能容纳全部的排序记录,在排序过程中需要访问外存. 冒泡排序 func BubbleSort(ve ...
- MySQL优化(2)--------常用优化
前言 之前已经简单介绍了MySQL的优化步骤,那么接下来自然而是就是常用的SQL优化,比如inseer.group by等常用SQL的优化,会涉及SQL语句内部细节(这正是我缺乏的).最后希望自己能记 ...
- spark之JDBC开发(实战)
一.概述 Spark Core.Spark-SQL与Spark-Streaming都是相同的,编写好之后打成jar包使用spark-submit命令提交到集群运行应用$SPARK_HOME/bin#. ...
- Handsontable Dropdown with key-value pair
在使用handsontable的时候,本身的下拉列表无法满足业务需求,需要使用key-value类型的dropdown. 找了半天终于找到了一个可以满足需求的 参考方案 此方案完美的解决了我的问题. ...