
用BERT做语义相似度匹配任务:计算相似度的方式
1. 自然地使用[CLS]
BERT可以很好的解决sentence-level的建模问题,它包含叫做Next Sentence Prediction的预训练任务,即成对句子的sentence-level问题。BERT也给出了此类问题的Fine-tuning方案:
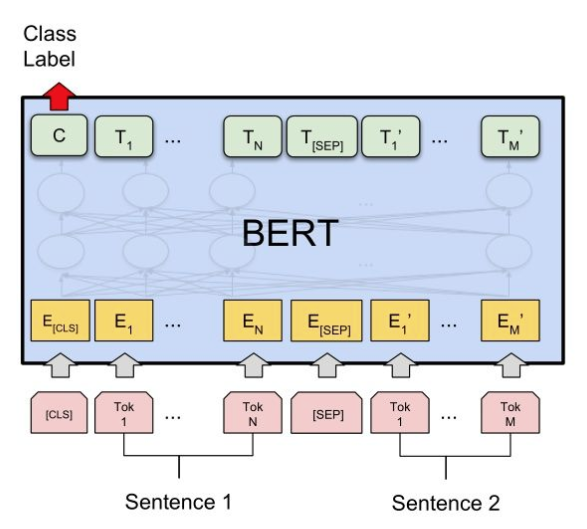
这一类问题属于Sentence Pair Classification Task.
计算相似度:
上图中,我们将输入送入BERT前,在首部加入[CLS],在两个句子之间加入[SEP]作为分隔。
然后,取到BERT的输出(句子对的embedding),取[CLS]即可完成多分类任务/相似度计算任务。
对应的:
假设我们取到的[CLS]对应的embedding为c,
多分类任务,需进行:P = softmax(cW')
相似度计算,需进行:P = sigmoid(cW')
然后,就可以去计算各自所需的loss了。
2. cosine similairity
单纯的做相似度匹配,这种方式需要优化。
在不finetune的情况下,cosine similairty绝对值没有实际意义。
bert pretrain计算的cosine similairty都是很大的,如果直接以cosine similariy>0.5之类的阈值来判断相似不相似那肯定效果很差。如果用做排序,也就是cosine(a,b)>cosine(a,c)->b相较于c和a更相似,是可以用的。
模型评价的标准应该使用auc,而不是accuracy。
3. 长短文本的区别
短文本(新闻标题)语义相似度任务用先进的word embedding(英文fasttext/glove,中文tencent embedding)mean pooling后的效果就已经不错;
而对于长文本(文章)用simhash这种纯词频统计的完全没语言模型的简单方法也可以。
4. sentence/word embedding
bert pretrain模型直接拿来用作 sentence embedding效果甚至不如word embedding,cls的emebdding效果最差(也就是pooled output)。把所有普通token embedding做pooling勉强能用(这个也是开源项目bert-as-service的默认做法),但也不会比word embedding更好。
5. siamese network 方式
除了直接使用bert的句对匹配之外,还可以只用bert来对每个句子求embedding,再通过向Siamese Network这样的经典模式去求相似度。
用siamese的方式训练bert,上层通过cosine做判别,能够让bert学习到一种适用于cosine作为最终相似度判别的sentence embedding,效果优于word embedding,但因为缺少sentence pair之间的特征交互,比原始bert sentence pair fine tune还是要差些。
参考Siamese bert:
用BERT做语义相似度匹配任务:计算相似度的方式的更多相关文章
- 转-------CNN图像相似度匹配 2-channel network
基于2-channel network的图片相似度判别 原文地址:http://blog.csdn.net/hjimce/article/details/50098483 作者:hjimce 一.相 ...
- Levenshtein计算相似度距离
使用Levenshtein计算相似度距离,装下模块,调用下函数就好. 拿idf还得自己去算权重,而且不一定准确度高,一般做idf还得做词性归一化,把动词形容词什么全部转成名词,很麻烦. Levensh ...
- 迷时师度,悟了自度(时间的边际效应),附VC参考书
12年前看过这篇文章,今天又看到了,还是有些感慨的.上课的时间虽然已经永远远去,用整块的时间去学习已经不可能,但道理还是要记着的,没准依然有用,自勉.------------------------- ...
- OSPF的特征、术语、包类型、邻居关系的建立、RID的选择、DR和BDR的选举、度量值的计算、默认路由、验证
链路状态路由协议OSPF的特征.术语.包类型.邻居关系的建立.RID的选择.DR和BDR的选举.度量值的计算.默认路由.验证等. 文章目录 [*1*].链路状态路由协议概述 工作过程 优缺点 [*2* ...
- 文本去重之MinHash算法——就是多个hash函数对items计算特征值,然后取最小的计算相似度
来源:http://my.oschina.net/pathenon/blog/65210 1.概述 跟SimHash一样,MinHash也是LSH的一种,可以用来快速估算两个集合的相似度.Mi ...
- C# Net 比较2个字符串的相似度(使用余弦相似度)
C# Net 比较2个字符串的相似度(使用余弦相似度) 复制代码使用: /// <summary> /// 比较2个字符串的相似度(使用余弦相似度) /// </summary> ...
- 双目立体匹配经典算法之Semi-Global Matching(SGM)概述:匹配代价计算之互信息(Mutual Information,MI)
半全局立体匹配算法Semi-Global Matching,SGM由学者Hirschmüller在2005年所提出1,提出的背景是一方面高效率的局部算法由于所基于的局部窗口视差相同的假设在很多情况 ...
- 基于MATLAB实现的云模型计算隶属度
”云”或者’云滴‘是云模型的基本单元,所谓云是指在其论域上的一个分布,可以用联合概率的形式(x, u)来表示 云模型用三个数据来表示其特征 期望:云滴在论域空间分布的期望,一般用符号Εx表示. 熵:不 ...
- Python 计算相似度
#计算相似度 #欧式距离 # npvec1, npvec2 = np.array(det_a), np.array(det_b) # similirity=math.sqrt(((npvec1 - n ...
随机推荐
- 使用 Java 创建聊天客户端-1
1.聊天客户端文本框的搭建. 项目截图:java project 代码: (1).ChatManager.java package com.nantian.javachatclient.main; i ...
- 变形和透视 perspective
前面介绍了css3 2D变形(transform)移动.缩放.旋转.倾斜 有2D 也有3D,例如3D transform中有下面这三个方法: rotateX( angle ) rotateY( ang ...
- AdvanceEast源码理解
目录 文章思路 源码理解 一. 标签点形式 按顺序排列四个点,逆时针旋转,且第一个点为左上角点(刚开始选择最左边的点, 二. 标签切边 三. loss计算 四. NMS 最后说明 文章思路 大神的gi ...
- 简述*args and **kwargs
为了能让一个函数接受任意数量的位置参数:* 为了接受任意数量的关键字参数:** *参数只能出现在函数定义中最后一个位置参数后面,而**参数只能出现在最后一个参数 解决的问题:构造一个可接受任意数量参数 ...
- Django基础之创建admin账号
1. 首先我们要新建一个用户名, 用来登录管理网站,可以使用如下命令: python manage.py createsuperuser 2. 输入想要使用的用户名: Username(leave b ...
- Hadoop namenode连接journalnode限制导致集群启动失败
错误1:刚搭建的新集群,启动journalnode以后,格式化namenode节点,出现如下错误 注意其中划红线的地方. 出现这个错误的原因是journalnode节点还没有准备好,而namenode ...
- Qt的插件开发
写代码都是从不会到会,那么写博客也是同样的道理.从不会到会最实用的办法就是模仿了.关于Qt的知识很多都是学习了CSDN的一位大神 一去二三里.关于Qt插件的开发,我们也从他的文章里面抽丝剥茧,把最本质 ...
- uiautomator代码例子--java
在androidtest下创建文件Ui2Test.java package com.example.myapplication; import android.app.Instrumentation; ...
- 胜利点 选题 Scrum立会报告+燃尽图 02
此作业要求参见[https://edu.cnblogs.com/campus/nenu/2019fall/homework/8683] 一.小组介绍 组长:贺敬文 组员:彭思雨 王志文 位军营 杨萍 ...
- Elasticsearch6.4.0-windows环境部署安装
Elasticsearch可以轻松的实现全文检索,本文主要介绍Elasticsearch(ES)环境的安装部署,该文及后续使用的ES版本为6.4.0.希望能够帮助到大家. 一.安装Elasticsea ...