
基于node.js制作爬虫教程
前言:最近想学习node.js,突然在网上看到基于node的爬虫制作教程,所以简单学习了一下,把这篇文章分享给同样初学node.js的朋友。
目标:爬取 http://tweixin.yueyishujia.com/webapp/build/html/ 网站的所有门店发型师的基本信息。
思路:访问上述网站,通过chrome浏览器的network对网页内容分析,找到获取各个门店发型师的接口,对参数及返回数据进行分析,遍历所有门店的所有发型师,直到遍历完毕,同事将信息存储到本地。
步骤一:安装node.js
下载并安装node,此步骤比较简单就不详细解释了,有问题的可以直接问一下度娘。
步骤二:建立工程
1)打开dos命令条,cd进入想要创建项目的路径(我将此项目直接放在了E盘,以下皆以此路径为例);
2)mkdir node (创建一个文件夹用来存放项目,我这里取名为node);
3)cd 进入名为node的文件夹,并执行npm init初始化工程(期间会让填写一些信息,我是直接回车的);
步骤三:创建爬取到的数据存放的文件夹
1)创建data文件夹用来存放发型师基本信息;
2)创建image文件夹用来存储发型师头像图片;
此时工程下文件如下:
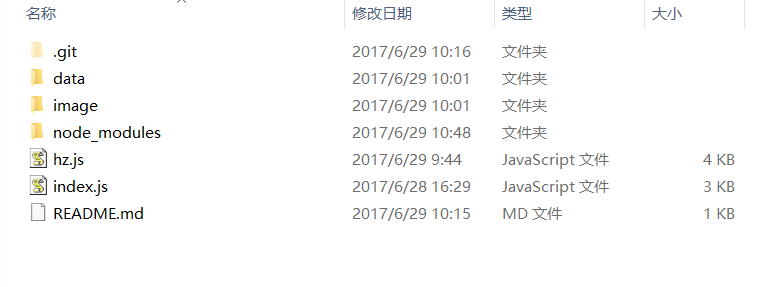
步骤四:安装第三方依赖包(fs是内置模块,不需要单独安装)
1)npm install cheerio –save
2)npm install superagent –save
3)npm install async –save
4)npm install request –save
分别简单解释一下上面安装的依赖包:
cheerio:是nodejs的抓取页面模块,为服务器特别定制的,快速、灵活、实施的jQuery核心实现,则能够对请求结果进行解析,解析方式和jQuery的解析方式几乎完全相同;
superagent:能够实现主动发起get/post/delete等请求;
async:async模块是为了解决嵌套金字塔,和异步流程控制而生,由于nodejs是异步编程模型,有一些在同步编程中很容易做到的事情,现在却变得很麻烦。Async的流程控制就是为了简化这些操作;
request:有了这个模块,http请求变的超简单,Request使用简单,同时支持https和重定向;
步骤五:编写爬虫程序代码
打开hz.js,编写代码:
var superagent = require('superagent');

var cheerio = require('cheerio');

var async = require('async');

var fs = require('fs');

var request = require('request');

var page=1; //获取发型师处有分页功能,所以用该变量控制分页

var num = 0;//爬取到的信息总条数

var storeid = 1;//门店ID

console.log('爬虫程序开始运行......');

function fetchPage(x) {     //封装函数

    startRequest(x);

}

function startRequest(x) {

    superagent

        .post('http://tweixin.yueyishujia.com/v2/store/designer.json')

        .send({

            // 请求的表单信息Form data

            page : x,

            storeid : storeid

        })

           // Http请求的Header信息

       .set('Accept', 'application/json, text/javascript, */*; q=0.01')

       .set('Content-Type','application/x-www-form-urlencoded; charset=UTF-8')

       .end(function(err, res){

            // 请求返回后的处理

            // 将response中返回的结果转换成JSON对象

            if(err){

                console.log(err);

            }else{

                var designJson = JSON.parse(res.text);

                var deslist =  designJson.data.designerlist;

                if(deslist.length > 0){

                    num += deslist.length;

                    // 并发遍历deslist对象

                    async.mapLimit(deslist, 5,

                        function (hair, callback) {

                        // 对每个对象的处理逻辑

                             console.log('...正在抓取数据ID:'+hair.id+'----发型师:'+hair.name);

                             saveImg(hair,callback);

                        },

                        function (err, result) {

                            console.log('...累计抓取的信息数→→' + num);

                        }

                    );

                    page++;

                    fetchPage(page);

                }else{

                    if(page == 1){

                        console.log('...爬虫程序运行结束~~~~~~~');

                        console.log('...本次共爬取数据'+num+'条...');

                        return;

                    }

                    storeid += 1;

                    page = 1;

                    fetchPage(page);

                }

            }

        });

}

fetchPage(page);

function saveImg(hair,callback){

    // 存储图片

    var img_filename = hair.store.name+'-'+hair.name + '.png';

    var img_src = 'http://photo.yueyishujia.com:8112' + hair.avatar; //获取图片的url

    //采用request模块,向服务器发起一次请求,获取图片资源

    request.head(img_src,function(err,res,body){

        if(err){

            console.log(err);

        }else{

                request(img_src).pipe(fs.createWriteStream('./image/' + img_filename));     //通过流的方式,把图片写到本地/image目录下,并用发型师的姓名和所属门店作为图片的名称。

                console.log('...存储id='+hair.id+'相关图片成功!');

        }

    });

    // 存储照片相关信息

    var html = '姓名:'+hair.name+'<br>职业:'+hair.jobtype+'<br>职业等级:'+hair.jobtitle+'<br>简介:'+hair.simpleinfo+'<br>个性签名:'+hair.info+'<br>剪发价格:'+hair.cutmoney+'元<br>店名:'+hair.store.name+'<br>地址:'+hair.store.location+'<br>联系方式:'+hair.telephone+'<br>头像:<img src='+img_src+' style="width:200px;height:200px;">';

    fs.appendFile('./data/' +hair.store.name+'-'+ hair.name + '.html', html, 'utf-8', function (err) {

        if (err) {

            console.log(err);

        }

    });

    callback(null, hair);

}
步骤六:运行爬虫程序
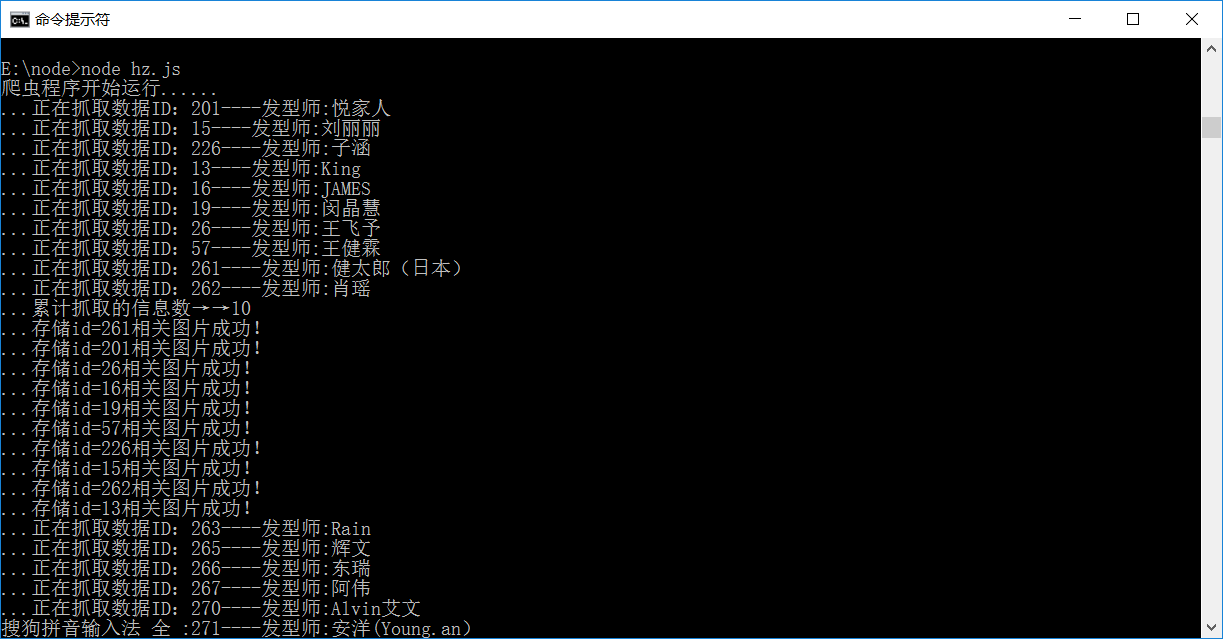
输入node hz.js命令运行爬虫程序,效果图如下:
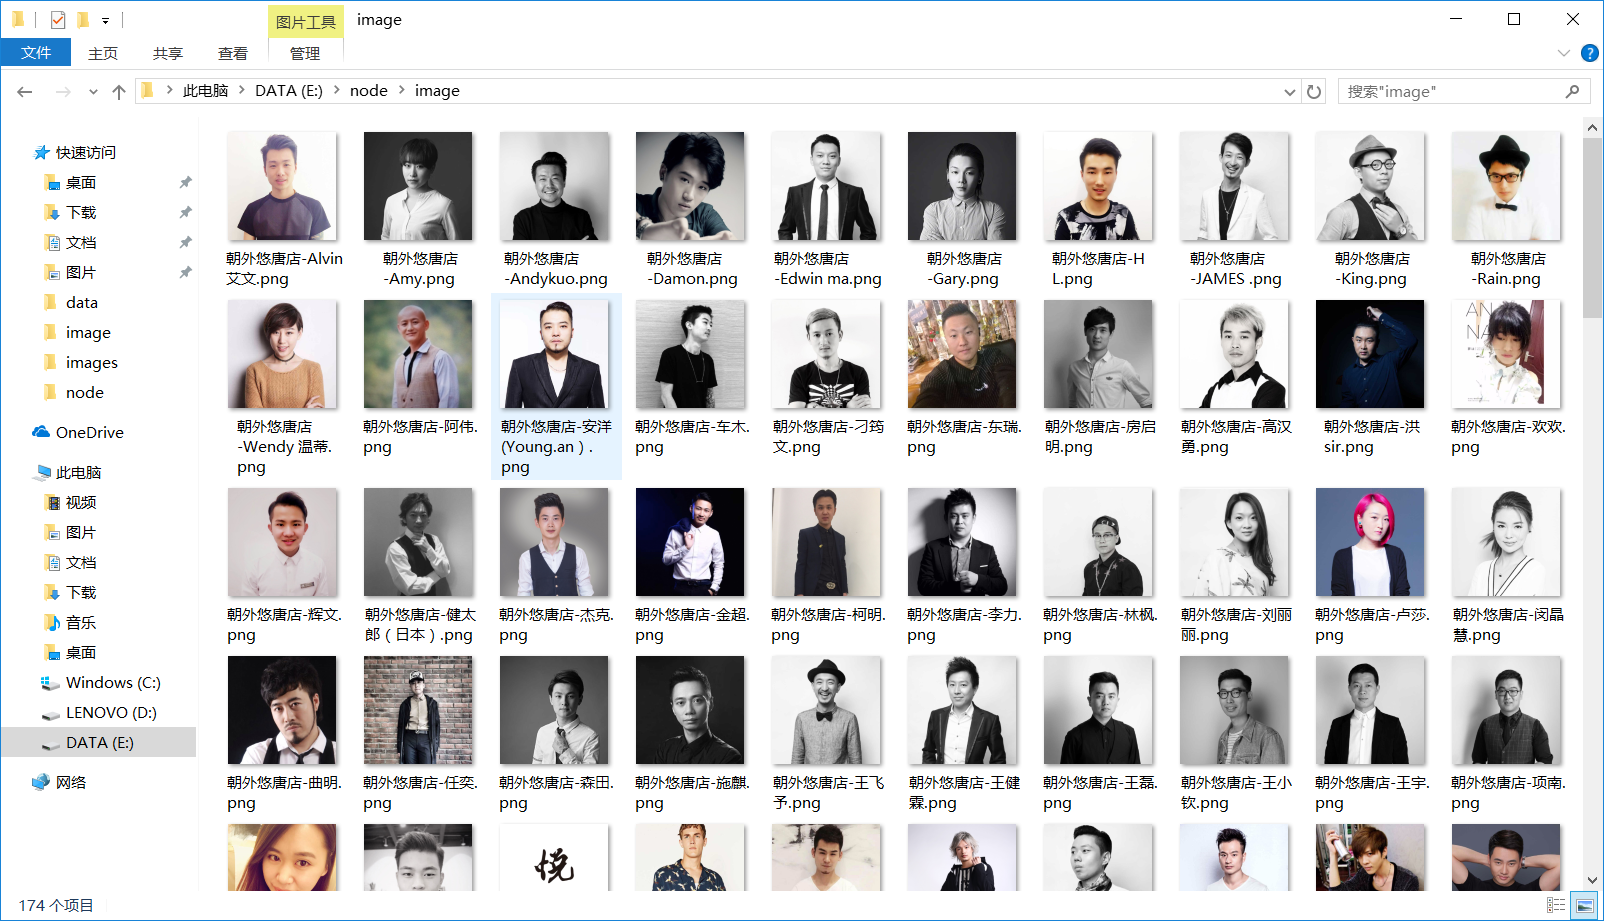
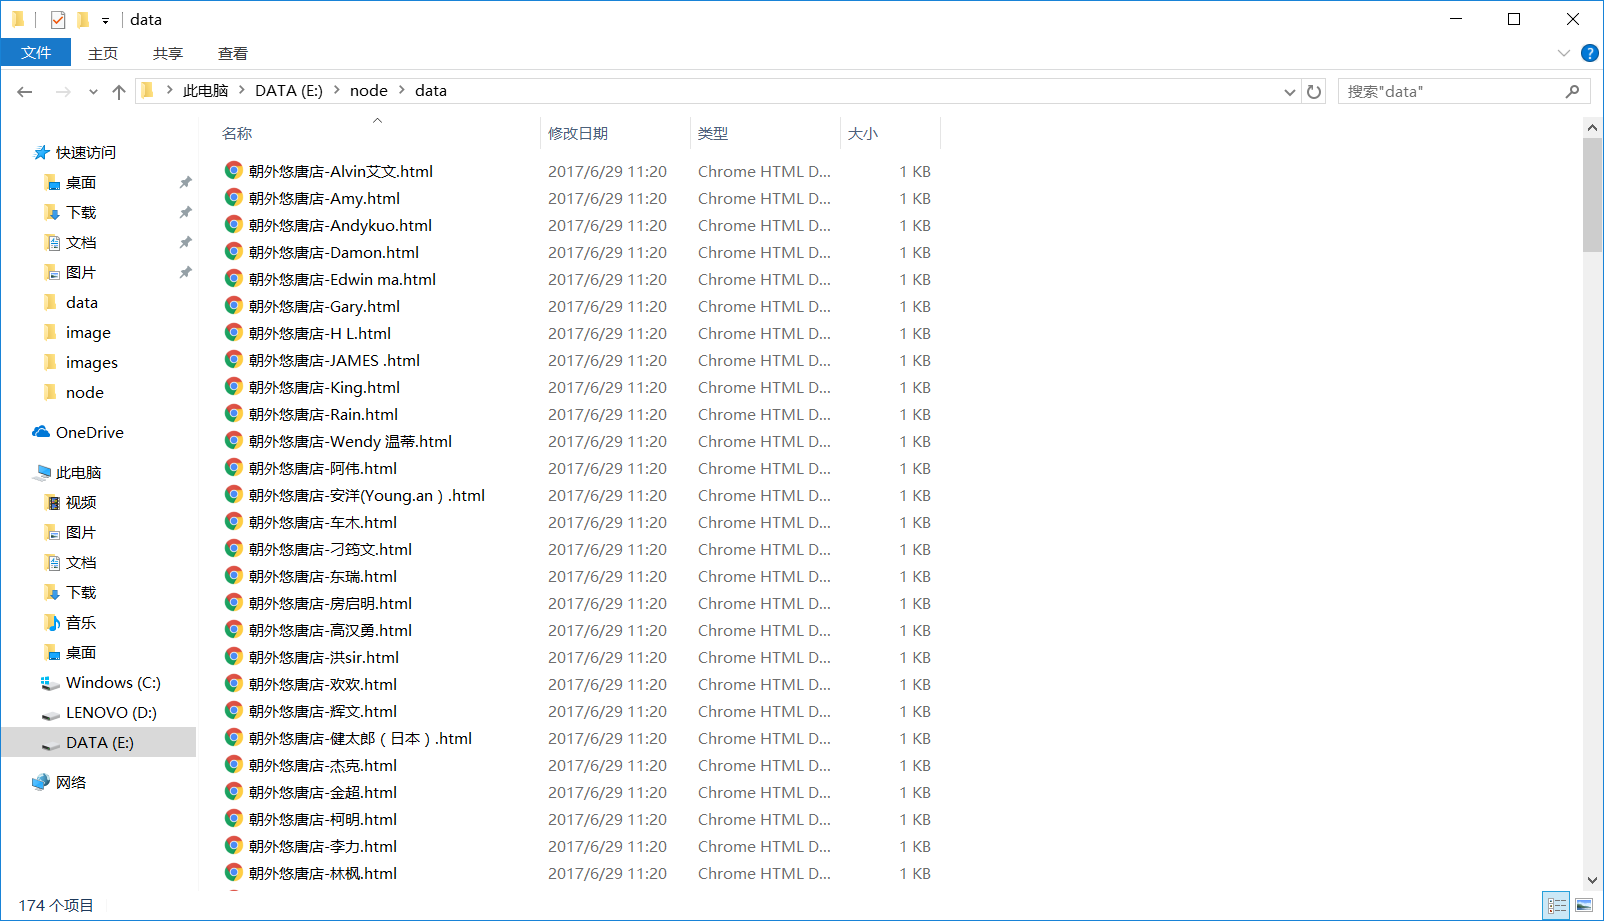
运行成功后,发型师基本信息以html文件的形式存储在data文件夹中,发型师头像图片存储在image文件夹下:
后记:到此一款基于node.js制作的简单爬虫就大功告成了,由于我也是初学者,好多地方也不是很理解,但好在是自己完成了,不足之处敬请谅解。
代码下载地址:https://github.com/yanglei0323/nodeCrawler
基于node.js制作爬虫教程的更多相关文章
- 基于Node.js的爬虫工具 – Node Crawler
Node Crawler的目标是成为最好的node.js爬虫工具,目前已经停止维护. 我们来抓取光合新知博客tech栏目中的文章信息.访问http://dev.guanghe.tv/category/ ...
- 基于node.js的爬虫框架 node-crawler简单尝试
百度爬虫这个词语,一般出现的都是python相关的资料. py也有很多爬虫框架,比如scrapy,Portia,Crawley等. 之前我个人更喜欢用C#做爬虫. 随着对nodejs的熟悉.发现做这种 ...
- 基于Node.js的强大爬虫 能直接发布抓取的文章哦
基于Node.js的强大爬虫 能直接发布抓取的文章哦 基于Node.js的强大爬虫能直接发布抓取的文章哦!本爬虫源码基于WTFPL协议,感兴趣的小伙伴们可以参考一下 一.环境配置 1)搞一台服务器,什 ...
- #1使用html+css+js制作网站教程 准备
#1使用html+css+js制作网站教程 准备 本系列链接 0 准备 0.1 IDE编辑软件 0.2 浏览器 0.3 基础概念 0.3.1 html 0.3.2 css 0.3.3 js 0.4 文 ...
- NodeBB – 基于 Node.js 的开源论坛系统
NodeBB 是一个更好的论坛平台,专门为现代网络打造.它是免费的,易于使用. NodeBB 论坛软件是基于 Node.js 开发,支持 Redis 或 MongoDB 的数据库.它利用 Web So ...
- 基于 Node.js 平台,快速、开放、极简的 web 开发框架。
资料地址:http://www.expressjs.com.cn/ Express 基于 Node.js 平台,快速.开放.极简的 web 开发框架. $ npm install express -- ...
- Pomelo:网易开源基于 Node.js 的游戏服务端框架
Pomelo:网易开源基于 Node.js 的游戏服务端框架 https://github.com/NetEase/pomelo/wiki/Home-in-Chinese
- Fenix – 基于 Node.js 的桌面静态 Web 服务器
Fenix 是一个提供给开发人员使用的简单的桌面静态 Web 服务器,基于 Node.js 开发.您可以同时在上面运行任意数量的项目,特别适合前端开发人员使用. 您可以通过免费的 Node.js 控制 ...
- 基于Node.js + jade + Mongoose 模仿gokk.tv
原文摘自我的前端博客,欢迎大家来访问 http://www.hacke2.cn 关于gokk 大学的娱乐活动基本就是在寝室看电影了→_→,一般都会选择去goxiazai.cc上看,里面的资源多,质量高 ...
随机推荐
- C#集合之字典
字典表示一种复杂的数据结构,这种数据结构允许按照某个键来访问元素.字典也称为映射或散列表. 字典的主要特性是能根据键快速查找值.也可以自由添加和删除元素,这有点像List<T>(http: ...
- The authenticity of host '172.16.33.53 (172.16.33.53)' can't be established的问题(日志六)
用ssh登录一个机器(换过ip地址)会出现如下错误 weiguohui@weiguohui1-virtual-machine:~/.ssh$ ssh 172.16.33.53The authentic ...
- [刷题]算法竞赛入门经典(第2版) 6-9/UVa127 - "Accordian" Patience
题意:52张牌排一行,一旦出现任何一张牌与它左边的第一张或第三张"匹配",即花色或点数相同,则须立即将其移动到那张牌上面,将其覆盖.能执行以上移动的只有压在最上面的牌.直到最后没有 ...
- H5水果机,一个网络版的lao hu ji
该游戏为h5小游戏,纯属娱乐,技术探讨,相关技术在文章结尾,欢迎探讨交流 花了几天时间开发了这款水果lao hu ji,更新了几个版本,还有不足的地方,由于时间有限暂时没有继续更新新版本 未完成的功能 ...
- 【Java并发系列03】ThreadLocal详解
img { border: solid 1px } 一.前言 ThreadLocal这个对象就是为多线程而生的,没有了多线程ThreadLocal就没有存在的必要了.可以将任何你想在每个线程独享的对象 ...
- PHP开发微信模版消息换行的问题
微信是个坑!微信是个坑!微信是个坑!重要的时间说三遍 关键的地方是空白换行符到底是什么也不说,百度说是"\n":但是在发送消息的时候发现原样输出,发现json_encode对\n进 ...
- 抱歉,您必须拥有一个终端来执行 sudo
Linux ssh执行远端服务器sudo命令时有如下报错: sudo: sorry, you must have a tty to run sudo sudo:抱歉,您必须拥有一个终端来执行 sudo ...
- Spring与Mybatis整合
一 概述 1.整合的目的 将Mapper映射器的创建任务交给Spring容器. 二 具体实现 1.创建sqlSessionFactory: <bean id="sqlSessionFa ...
- Java之进程与线程练习
1.设计一个线程类:创建3个子线程,每个线程分别打印数字,分别睡眠100,200,300ms ->每个执行都是20次 代码: package Homework; //1.设计一个线程类:创建3个 ...
- C语言集成开发环境vs2017的使用技巧之修改快捷键
首先这里是说编辑C语言内容,其次开发环境是vs2017(全称:visual studio 2017).像这个开发环境体积大,但你安装的时候不要安装到C盘,然后安装的时候选择模块,比如你不开发网站,就先 ...