
【Spark机器学习速成宝典】基础篇04数据类型(Python版)
目录
Vector
LabeledPoint
Matrix
使用C4.5算法生成决策树
使用CART算法生成决策树
预剪枝和后剪枝
应用:遇到连续与缺失值怎么办?
多变量决策树
Python代码(sklearn库)
|
Vector |
一个数学向量。MLlib 既支持稠密向量也支持稀疏向量,前者表示向量的每一位都存储下来,后者则只存储非零位以节约空间。后面会简单讨论不同种类的向量。向量可以通过mllib.linalg.Vectors 类创建出来
# -*-coding=utf-8 -*-

from pyspark import SparkConf, SparkContext

sc = SparkContext('local')

import numpy as np

import scipy.sparse as sps

from pyspark.mllib.linalg import Vectors

# Use a NumPy array as a dense vector.使用NumPy数组作为稠密向量

dv1 = np.array([1.0, 0.0, 3.0])

# Use a Python list as a dense vector.使用Python list作为稠密向量

dv2 = [1.0, 0.0, 3.0]

# Create a SparseVector.创建一个稀疏向量<1.0 0.0 2.0 3.0>的两种方式

sv1 = Vectors.sparse(4, {0: 1.0, 2: 2.0})

sv2 = Vectors.sparse(4, [0, 2], [1.0, 2.0])

# Use a single-column SciPy csc_matrix as a sparse vector.使用单列的csc_matrix作为稀疏向量

sv2 = sps.csc_matrix((np.array([10.0, 30.0]), np.array([0, 2]), np.array([0, 2])), shape=(3, 1))
|
LabledPoint |
在诸如分类和回归这样的监督式学习(supervised learning)算法中,LabeledPoint 用来表示带标签的数据点。它包含一个特征向量与一个标签(由一个浮点数表示),位置在mllib.regression 包中。
# -*-coding=utf-8 -*-

from pyspark import SparkConf, SparkContext

sc = SparkContext('local')

from pyspark.mllib.linalg import SparseVector

from pyspark.mllib.regression import LabeledPoint

# Create a labeled point with a positive label and a dense feature vector.使用稠密向量创建一个带有正标记LabeledPoint

pos = LabeledPoint(1.0, [1.0, 0.0, 3.0])

# Create a labeled point with a negative label and a sparse feature vector.使用稀疏向量创建一个带有负标记LabeledPoint

neg = LabeledPoint(0.0, SparseVector(3, [0, 2], [1.0, 3.0]))
|
Matrix |
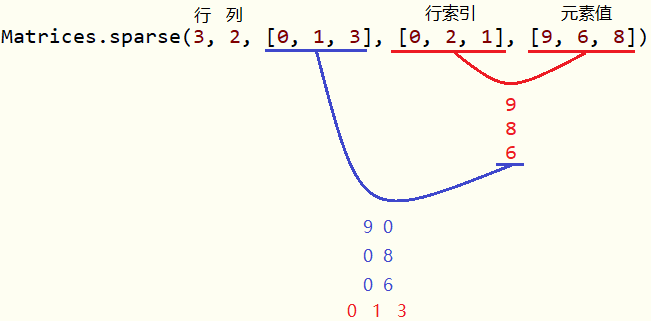
矩阵的基类是Matrix,我们提供了两种实现方法:稠密矩阵和稀疏矩阵。建议使用矩阵实现的工厂方法来创建矩阵。
# -*-coding=utf-8 -*-

from pyspark import SparkConf, SparkContext

sc = SparkContext('local')

from pyspark.mllib.linalg import Matrix, Matrices

# Create a dense matrix ((1.0, 2.0), (3.0, 4.0), (5.0, 6.0))

dm2 = Matrices.dense(3, 2, [1, 2, 3, 4, 5, 6])

# Create a sparse matrix ((9.0, 0.0), (0.0, 8.0), (0.0, 6.0))

sm = Matrices.sparse(3, 2, [0, 1, 3], [0, 2, 1], [9, 6, 8])
|
什么是决策树(Decision Tree)4 |
引例
现有训练集如下,请训练一个决策树模型,对未来的西瓜的优劣做预测。
|
什么是决策树(Decision Tree)5 |
引例
现有训练集如下,请训练一个决策树模型,对未来的西瓜的优劣做预测。
|
什么是决策树(Decision Tree)6 |
引例
现有训练集如下,请训练一个决策树模型,对未来的西瓜的优劣做预测。
|
什么是决策树(Decision Tree)7 |
引例
现有训练集如下,请训练一个决策树模型,对未来的西瓜的优劣做预测。
|
什么是决策树(Decision Tree)8 |
引例
现有训练集如下,请训练一个决策树模型,对未来的西瓜的优劣做预测。
【Spark机器学习速成宝典】基础篇04数据类型(Python版)的更多相关文章
- 【Spark机器学习速成宝典】基础篇01Windows下spark开发环境搭建+sbt+idea(Scala版)
注意: spark用2.1.1 scala用2.11.11 材料准备 spark安装包 JDK 8 IDEA开发工具 scala 2.11.8 (注:spark2.1.0环境于scala2.11环境开 ...
- 【Spark机器学习速成宝典】模型篇04朴素贝叶斯【Naive Bayes】(Python版)
目录 朴素贝叶斯原理 朴素贝叶斯代码(Spark Python) 朴素贝叶斯原理 详见博文:http://www.cnblogs.com/itmorn/p/7905975.html 返回目录 朴素贝叶 ...
- 【Spark机器学习速成宝典】基础篇02RDD常见的操作(Python版)
目录 引例入门:textFile.collect.filter.first.persist.count 创建RDD的方式:parallelize.textFile 转化操作:map.filter.fl ...
- 【Spark机器学习速成宝典】基础篇03数据读取与保存(Python版)
目录 保存为文本文件:saveAsTextFile 保存为json:saveAsTextFile 保存为SequenceFile:saveAsSequenceFile 读取hive 保存为文本文件:s ...
- 【Spark机器学习速成宝典】模型篇08保序回归【Isotonic Regression】(Python版)
目录 保序回归原理 保序回归代码(Spark Python) 保序回归原理 待续... 返回目录 保序回归代码(Spark Python) 代码里数据:https://pan.baidu.com/s/ ...
- 【Spark机器学习速成宝典】模型篇07梯度提升树【Gradient-Boosted Trees】(Python版)
目录 梯度提升树原理 梯度提升树代码(Spark Python) 梯度提升树原理 待续... 返回目录 梯度提升树代码(Spark Python) 代码里数据:https://pan.baidu.co ...
- 【Spark机器学习速成宝典】模型篇06随机森林【Random Forests】(Python版)
目录 随机森林原理 随机森林代码(Spark Python) 随机森林原理 参考:http://www.cnblogs.com/itmorn/p/8269334.html 返回目录 随机森林代码(Sp ...
- 【Spark机器学习速成宝典】模型篇05决策树【Decision Tree】(Python版)
目录 决策树原理 决策树代码(Spark Python) 决策树原理 详见博文:http://www.cnblogs.com/itmorn/p/7918797.html 返回目录 决策树代码(Spar ...
- 【Spark机器学习速成宝典】模型篇03线性回归【LR】(Python版)
目录 线性回归原理 线性回归代码(Spark Python) 线性回归原理 详见博文:http://www.cnblogs.com/itmorn/p/7873083.html 返回目录 线性回归代码( ...
随机推荐
- softmax函数笔记
- O008、LVM类型的Storage Pool
参考https://www.cnblogs.com/CloudMan6/p/5277927.html LVM类型的Storage Pool 不仅一个文件可以分配给客户机作为虚拟磁盘,宿主机上 ...
- 关于redis的几件小事(三)redis的数据类型与使用场景
1.string 这是最基本的类型了,就是普通的set和get,做简单的kv缓存. 2.hash 这个是类似map的一种结构,这个一般就是可以将结构化的数据,比如一个对象(前提是这个对象没嵌套其他的对 ...
- css3中单位rem与.less结合布局
rem是CSS3新增的一个相对单位(root em,根em),这个单位引起了广泛关注.这个单位与em有什么区别呢?区别在于使用rem为元素设定字体大小时,仍然是相对大小,但相对的只是HTML根元素. ...
- Linux学习篇之OpenKM的安装(汉化)
OpenKM是一个开放源代码的电子文档管理系统,它的特点是可用于大型公司或是中小企业, 适应性比较强. 并且在知识管理方面的加工,提供了更加灵活和成本较低的替代应用,下面讲一下搭建方法. 一.以下都是 ...
- ERA-interim
数据介绍整理中... https://software.ecmwf.int/wiki/display/UER/Time-integrated+surface+solar+radiation+downw ...
- 2019.9.20使用kali中的metasploi获取windows 的权限
1 kali 基于debin的数字取证系统,上面集成了很多渗透测试工具,其前身是bt5r3(bractrack) 其中Metasploit是一个综合利用工具,极大提高攻击者渗透效率,使用ruby开发的 ...
- 关于Linux系统下基于Tomcat部署和升级war包的详细过程
1.首先Linux先安装java,Tomcat 中间件规范要求: 1) 软件必须下载到/services/download_soft_v --------(用xftp上传 ...
- kotlin项目开发基础之gradle初识
在Android Studio推出之后默认的打包编译工具就变为gradle了,我想对于一名Android程序员而言没人不对它知晓,但是对于它里面的一些概念可能并不是每个人都了解,只知道这样配置就ok了 ...
- Codeforces 837E Vasya's Function 数论 找规律
题意:定义F(a,0) = 0,F(a,b) = 1 + F(a,b - GCD(a,b).给定 x 和 y (<=1e12)求F(x,y). 题解:a=A*GCD(a,b) b=B*GCD(a ...