
SingleNode HDFS 搭建过程
背景
1. 纯粹测试

2. 未考虑安全和授权以及数据处理.

3. 单节点最简单的部署, 验证功能连接的可能性
资料获取以及环境变量的设置
- 获取最新的安装文件
https://downloads.apache.org/hadoop/common/hadoop-3.3.1/hadoop-3.3.1.tar.gz
- 文件不到600m 大小 下载速度还是可以的.
- 设置环境变量
export PATH=$PATH:/app/server/runtime/java/x86_64-linux/bin/:/hadoop/bin:/hadoop/sbin

export HDFS_DATANODE_USER=root

export HDFS_NAMENODE_USER=root

export HDFS_SECONDARYNAMENODE_USER=root

export JAVA_HOME=/app/server/runtime/java/x86_64-linux/
- 注意我这边设置的表简单 直接放到了
/etc/profile.d/app.sh然后source一下就可以了 - 可以看到我这边使用了比较简单的 root用户运行.
部署单节点的hdfs
- 修改设置变量文件
前提条件, 我讲hadoop 整个目录放到了 /hadoop 里面, 跟环境变量呼应.

修改配置文件

cd /hadoop/etc/hadoop/

hdfs-site.xml

内容设置为

# 注意肯恩需要先设置一下file 后面的路径.

# 注意我这边是简单的singleNode 所以replication 设置的是 1.

<configuration>

   <!--指定hdfs保存数据的副本数量-->

    <property>

            <name>dfs.replication</name>

            <value>1</value>

    </property>

    <!--指定hdfs中namenode的存储位置-->

    <property>

             <name>dfs.namenode.name.dir</name>

             <value>file:/data/hadoop/tmp/dfs/name</value>

    </property>

    <!--指定hdfs中datanode的存储位置-->

    <property>

             <name>dfs.datanode.data.dir</name>

             <value>file:/data/hadoop/tmp/dfs/data</value>

    </property>

</configuration>

修改另一个配置文件

 core-site.xml

 <configuration>

   <property>

               <name>fs.defaultFS</name>

               <value>hdfs://someip:8020</value>

   </property>

  <property>

            <name>hadoop.tmp.dir</name>

            <value>file:/data/hadoop/tmp</value>

   </property>

       <name>fs.checkpoint.period</name>

       <value>3600</value>

</configuration>

# 注意需要记住ip地址.
- 进行初始化
直接使用官网介绍的命令就可以

Format the filesystem:

  $ bin/hdfs namenode -format

Start NameNode daemon and DataNode daemon:

  $ sbin/start-dfs.sh

The hadoop daemon log output is written to the $HADOOP_LOG_DIR directory (defaults to $HADOOP_HOME/logs).

Browse the web interface for the NameNode; by default it is available at:

NameNode - http://localhost:9870/

Make the HDFS directories required to execute MapReduce jobs:

  $ bin/hdfs dfs -mkdir /user

  $ bin/hdfs dfs -mkdir /user/<username>

Copy the input files into the distributed filesystem:

  $ bin/hdfs dfs -mkdir input

  $ bin/hdfs dfs -put etc/hadoop/*.xml input

Run some of the examples provided:

  $ bin/hadoop jar share/hadoop/mapreduce/hadoop-mapreduce-examples-3.3.1.jar grep input output 'dfs[a-z.]+'

Examine the output files: Copy the output files from the distributed filesystem to the local filesystem and examine them:

  $ bin/hdfs dfs -get output output

  $ cat output/*

or

View the output files on the distributed filesystem:

  $ bin/hdfs dfs -cat output/*

When you’re done, stop the daemons with:

  $ sbin/stop-dfs.sh
检查一下部署结果
- 打开网页 http://nodeip:9870
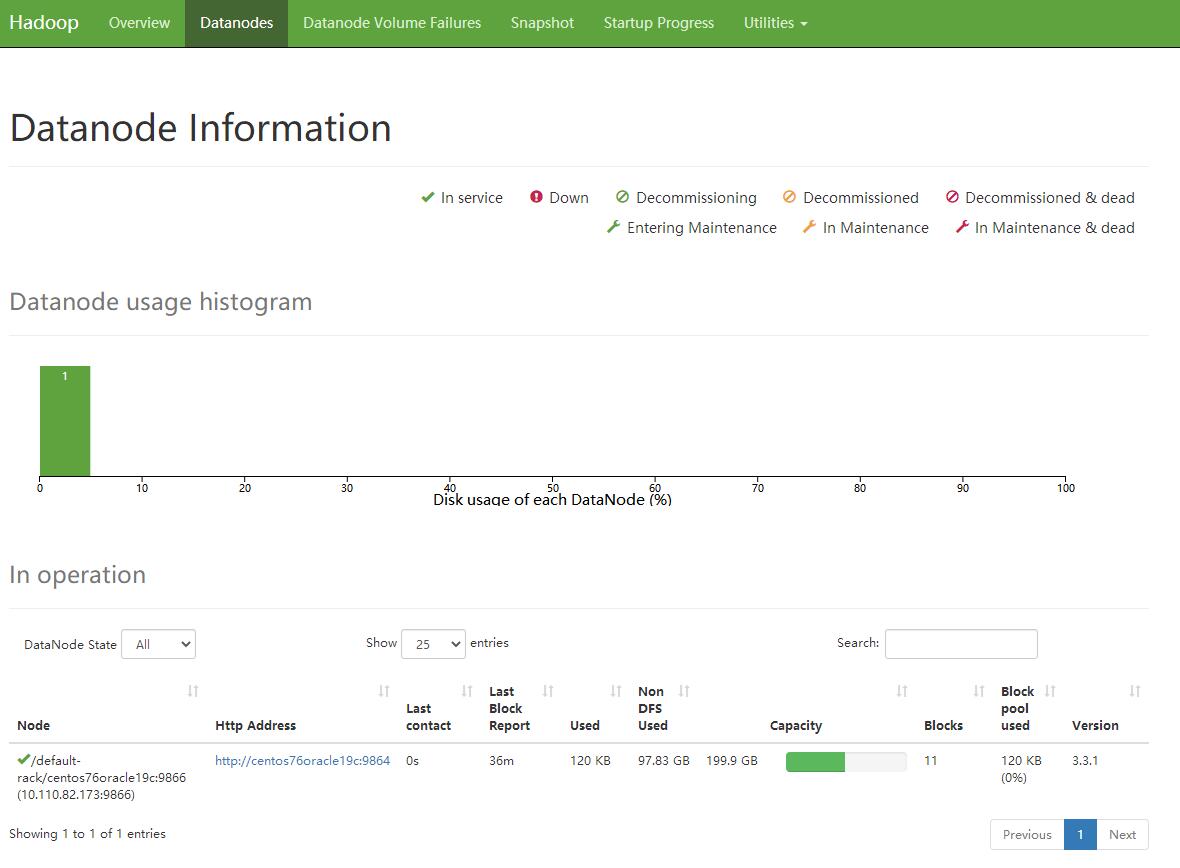
- 展示Node节点的情况的结果
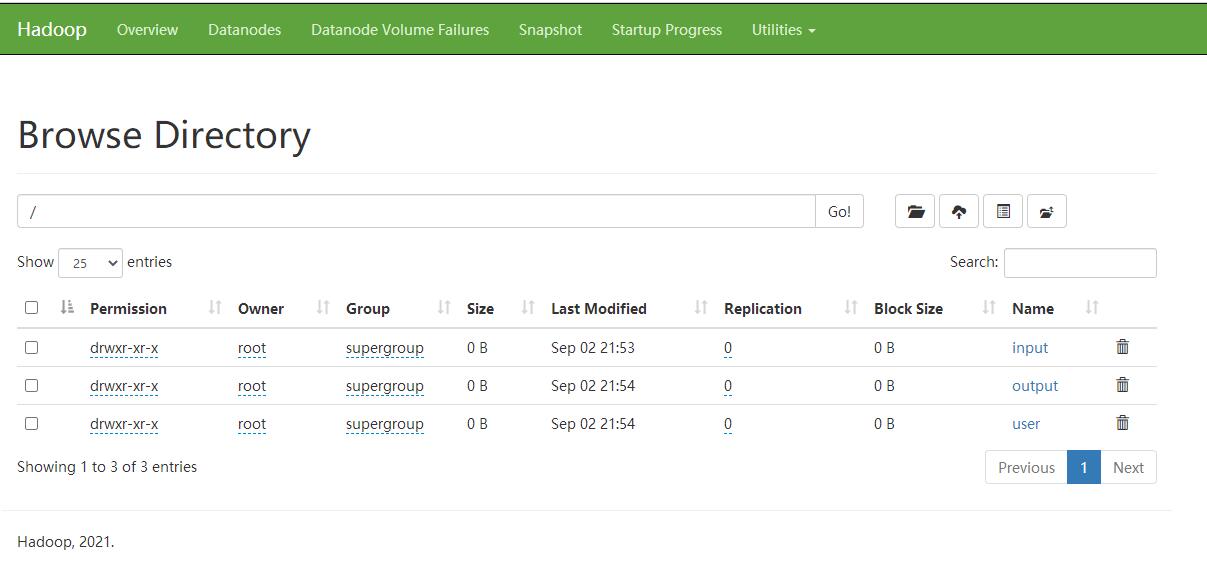
- 展示文件系统, 这里我没考虑权限 好像 控制台权限是没法进行upload和delete的 改天学习下 , 另外不清楚 8020端口的安全设置
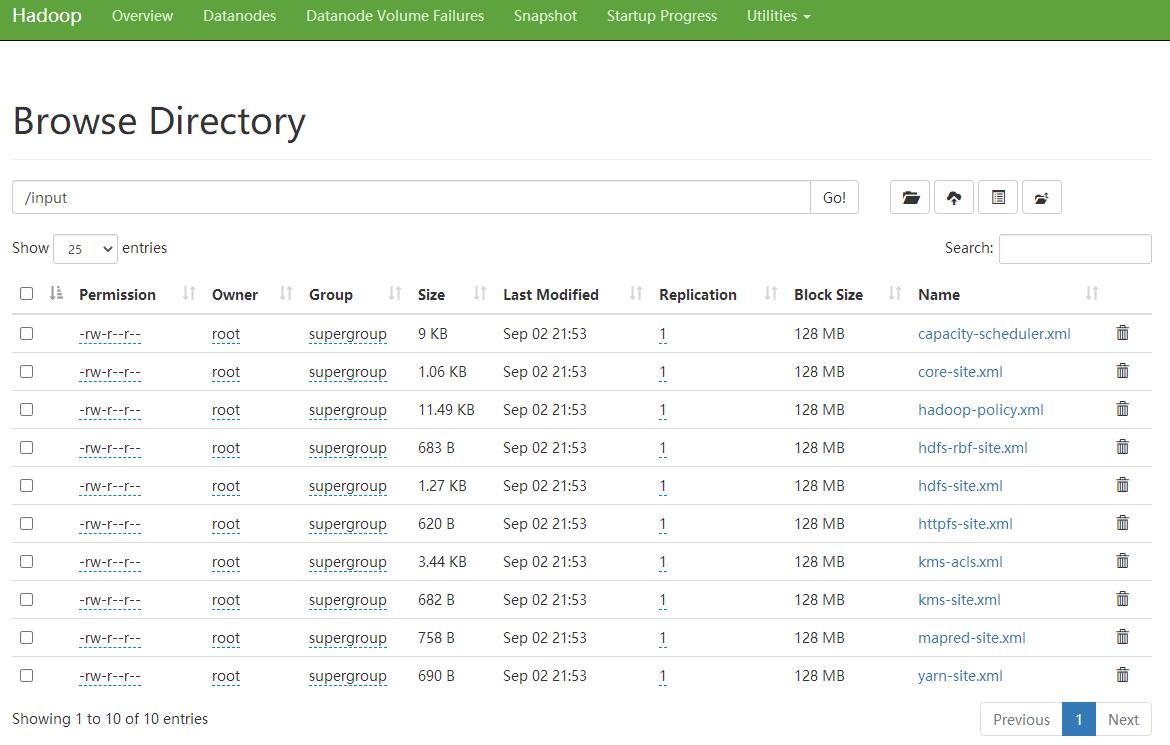
- 展示具体的文件夹内的内容
SingleNode HDFS 搭建过程的更多相关文章
- 懒人记录 Hadoop2.7.1 集群搭建过程
懒人记录 Hadoop2.7.1 集群搭建过程 2016-07-02 13:15:45 总结 除了配置hosts ,和免密码互连之外,先在一台机器上装好所有东西 配置好之后,拷贝虚拟机,配置hosts ...
- Hadoop完全分布式搭建过程中遇到的问题小结
前一段时间,终于抽出了点时间,在自己本地机器上尝试搭建完全分布式Hadoop集群环境,也是借助网络上虾皮的Hadoop开发指南系列书籍一步步搭建起来的,在这里仅代表hadoop初学者向虾皮表示衷心的感 ...
- Hadoop集群(二) HDFS搭建
HDFS只是Hadoop最基本的一个服务,很多其他服务,都是基于HDFS展开的.所以部署一个HDFS集群,是很核心的一个动作,也是大数据平台的开始. 安装Hadoop集群,首先需要有Zookeeper ...
- 【安装】Hadoop2.8.0搭建过程整理版
Hadoop搭建过程 前期环境搭建主要分为软件的安装与配置文件的配置,集成的东西越多,配置项也就越复杂. Hadoop集成了一个动物园,所以配置项也比较多,且每个版本之间会有少许差异. 安装的方式有很 ...
- 本地+分布式Hadoop完整搭建过程
1 概述 Hadoop在大数据技术体系中极为重要,被誉为是改变世界的7个Java项目之一(剩下6个是Junit.Eclipse.Spring.Solr.HudsonAndJenkins.Android ...
- Maven多模块,Dubbo分布式服务框架,SpringMVC,前后端分离项目,基础搭建,搭建过程出现的问题
现互联网公司后端架构常用到Spring+SpringMVC+MyBatis,通过Maven来构建.通过学习,我已经掌握了基本的搭建过程,写下基础文章为而后的深入学习奠定基础. 首先说一下这篇文章的主要 ...
- Access应用笔记<四>-一个完整的自动化报表搭建过程
距离之前的三篇日志已经很久啦,今天终于完成了一个比较完整的自动化报表搭建过程 基于公司数据保密原则,样板就不放到网上来了,简单说一下背景: 这次access实现的功能包括: 1)为部门整体搭建了一个员 ...
- iOS---XMPP环境搭建过程
什么是即时通信? 即时通信是目前Internet上最为流行的通讯方式, 各种各样的即时通讯软件也层出不穷, 服务提供商也提供了越来越枫木的通讯服务功能. 即时通讯有多重实现方式, XMPP就是其中一种 ...
- 最简单的SVN环境搭建过程
本文简单描述最简单的SVN环境搭建过程 搭建环境:windows (个人验证了windows2003,windows xp) 使用软件:Setup-Subversion-1.6.17 //Serve ...
- cocos2d-x3.9 NDK android 环境搭建过程中遇到的错误
编译环境:Mac OS, NDK r9d 错误:arm-linux-androideabi-gcc: error trying to exec '/media/Project/adt-bundle-l ...
随机推荐
- 跟我学Python图像处理丨5种图像阈值化处理及算法对比
摘要:本篇文章主要讲解Python调用OpenCV实现图像阈值化处理操作,包括二进制阈值化.反二进制阈值化.截断阈值化.反阈值化为0.阈值化为0. 本文分享自华为云社区<[Python图像处理] ...
- Mac 设置 JAVA_HOME
Mac /System/Library/Frameworks/JavaVM.framework/Home/bin/java: No such file or directory 查找JAVA_HOME ...
- go build 跟 go run 的区别
go build 和 go run 是 Go 语言中两个常用的命令,它们的主要区别在于编译和执行的过程. 1.go run go run 命令用于编译并运行 Go 程序.它将源代码直接编译成可执行文件 ...
- 【JAVA基础】常量变量维护
常量维护 //参与签名的系统Header前缀,只有指定前缀的Header才会参与到签名中 //换行符 private static final char LF = '\n'; public stati ...
- ElasticSearch 分组聚合统计
统计总数: GET mytest-statistics/_search { "size": 0, "query": { "bool": { ...
- Printer Queue,UVa 12100 (自定义标记法 + 优先队列)
题目描述: 我们需要用打印机打印任务.每个任务都有1~9间的优先级,优先级越高,任务越急. 打印机的运作方式:从打印队列里取出一个任务j,如果队列里有比j更急的任务,则直接把j放到打印队列尾部,否则打 ...
- P3574 [POI2014]FAR-FarmCraft (树形DP)
这题直接贪心显然不可行. 考虑树形dp,用 \(f_i\) 表示到 \(i\) 人后,以 \(i\) 为根的所有人安装完的最短时间. 对于一个节点 \(u\), 假设拜访子节点的顺序为 \(v_1,v ...
- HDU 1179:Ollivanders: Makers of Fine Wands since 382 BC.
HDU - 1179 二分图介绍:匈牙利算法 模板二分图: #include<bits/stdc++.h> using namespace std; const int maxn = 11 ...
- 2023陕西省大学生信息安全竞赛web writeup
前言 早写好了,忘发了,题目质量还行,够我坐大牢 ezpop 简单的反序列化,exp如下 <?php class night { public $night; } class day { pub ...
- 5分钟教会你如何在生产环境debug代码
前言 有时出现的线上bug在测试环境死活都不能复现,靠review代码猜测bug出现的原因,然后盲改代码直接在线上测试明显不靠谱.这时我们就需要在生产环境中debug代码,快速找到bug的原因,然后将 ...