
李宏毅2022机器学习HW4 Speaker Identification上(Dataset &Self-Attention)
Homework4
Dataset介绍及处理
Dataset introduction
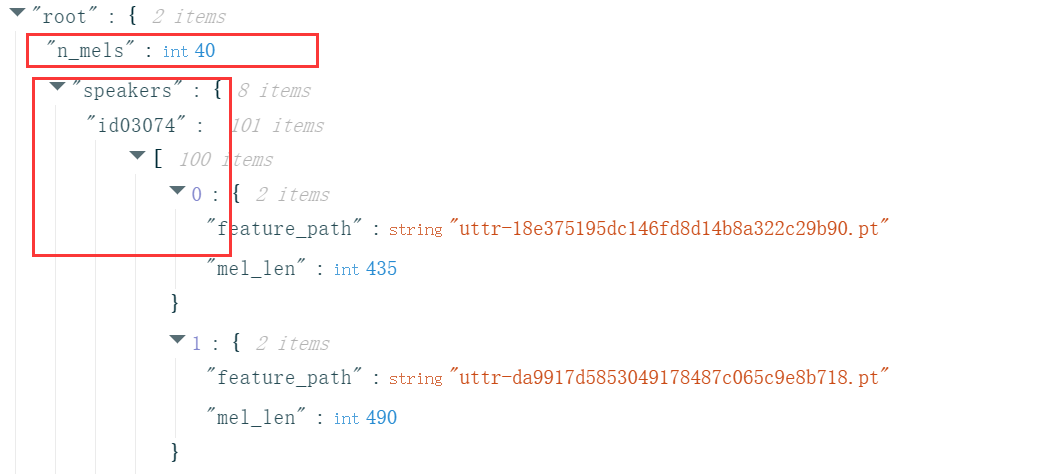
训练数据集metadata.json包括speakers和n_mels,前者表示每个speaker所包含的多条语音信息(每条信息有一个路径feature_path和改条信息的长度mel_len或理解为frame数即可),后者表示滤波器数量,简单理解为特征数即可,由此可知每个.pt语言文件可以表示为大小为mel_len \(\times\) n_mels的矩阵,其中所有文件已规定n_mels为40,不同的是语言信息的长度即mel_len。
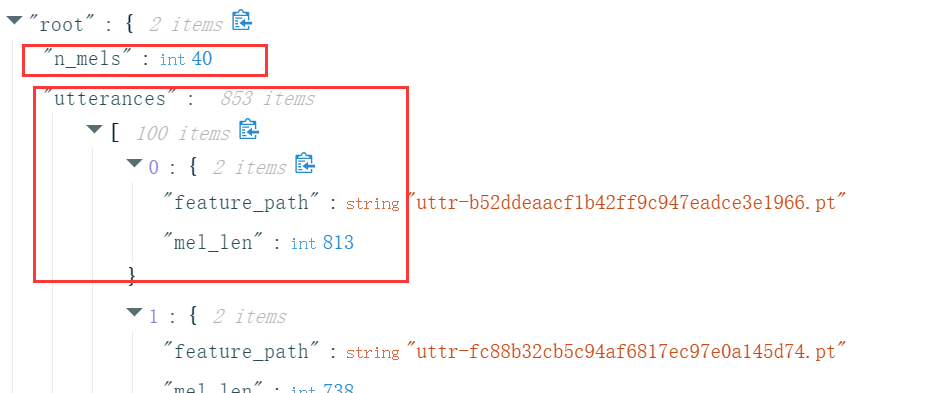
测试数据集testdata.json包括n_mels和utterances,其中n_mels和意义前面一样且固定为40,utterance表示一条语音信息,不同的是这里我们不知道这则信息是谁说出来的,任务就是检测这些信息分别是谁说的。
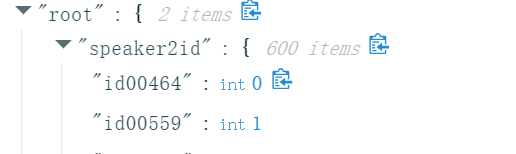
映射文件mapping.json包括两项speaker2id和id2speaker,前者将600个speaker的编号隐射为0-599,后者则是相反的操作。
Dataset procession
正如上面说,尽管“古圣先贤”已经帮我们做好了绝大多数的数据处理操作,但是如果想要批量训练数据那么就需要对每个语音序列的mel_len进行固定,比如在sample code里面固定为128个frame
class myDataset(Dataset):

	def __init__(self, data_dir, segment_len=128):
它的具体实现方式如下
def __getitem__(self, index):

		feat_path, speaker = self.data[index]

		# Load preprocessed mel-spectrogram.

		mel = torch.load(os.path.join(self.data_dir, feat_path))

		# Segmemt mel-spectrogram into "segment_len" frames.

		if len(mel) > self.segment_len:

			# Randomly get the starting point of the segment.

			start = random.randint(0, len(mel) - self.segment_len)

			# Get a segment with "segment_len" frames.

			mel = torch.FloatTensor(mel[start:start+self.segment_len])

		else:

			mel = torch.FloatTensor(mel)

		# Turn the speaker id into long for computing loss later.

		speaker = torch.FloatTensor([speaker]).long()

		return mel, speaker
即从每个语音序列总的frame中抽取连续的128个frame,但是这并不能够保证所有的语音需要都为128个frame,可能某语音序列的frame数原本就小于128,因此还需要另外一道保险即padding。
def collate_batch(batch):

	# Process features within a batch.

	"""Collate a batch of data."""

	mel, speaker = zip(*batch)

	# Because we train the model batch by batch, we need to pad the features in the same batch to make their lengths the same.

	mel = pad_sequence(mel, batch_first=True, padding_value=-20)    # pad log 10^(-20) which is very small value.

	# mel: (batch size, length, 40)

	return mel, torch.FloatTensor(speaker).long()

def get_dataloader(data_dir, batch_size, n_workers):

	"""Generate dataloader"""

	dataset = myDataset(data_dir)

	speaker_num = dataset.get_speaker_number()

	# Split dataset into training dataset and validation dataset

	trainlen = int(0.9 * len(dataset))

	lengths = [trainlen, len(dataset) - trainlen]

	trainset, validset = random_split(dataset, lengths)

	train_loader = DataLoader(

		trainset,

		batch_size=batch_size,

		shuffle=True,

		drop_last=True,

		num_workers=n_workers,

		pin_memory=True,

		collate_fn=collate_batch,

	)

	valid_loader = DataLoader(

		validset,

		batch_size=batch_size,

		num_workers=n_workers,

		drop_last=True,

		pin_memory=True,

		collate_fn=collate_batch,

	)

	return train_loader, valid_loader, speaker_num
在data_loader读取一个batch时,如果仍旧有不同大小的frame,那么就可以通过指定collate_fn=collate_batch对数据进行填充,确保每个batch的frame相同进而进行批量(并行?)计算。
当然你也可以不预先设置frame数为128,仅使用collate_batch,那么就会使这个batch内所有语音序列的frame数自动对齐到最长的frame,但往往会爆显存。
Self-Attention简单介绍
在不考虑Multi-Head Attention以及add &norm的情况下
\(X'=\)Self-Attention\((X, W^q, W^k, W^v, W^l)\) = \(\frac{XW^q(XW^k)^T}{\sqrt{d_k}}XW^vW^l\)
其中\(X, W^q, W^k, W^v, W^l\)维度分别为\(n\times d_{model}, d_{model}\times d_k, d_{model}\times d_k, d_{model}\times d_v, d_v\times d_{model}\),并称\(Q=X\times W^q, K = X\times W^k, V = X\times W^v\)
可知,变化后的\(X'\)与原来\(X\)的维度相同,这一变化过程简称为编码,那么问题来了\(X'\)与\(X\)究竟有何不同?
在变化过程中,我们对\(Q\)和\(K\)做了内积运算,这表示一个查询匹配过程,内积越大则相似度越高,那么匹配所得的权重也就越大(表明越关注这个讯息),之后再和\(V\)运算相当于通过前面的权重及原始\(V\)对新\(X\)的\(V\)做预测,视频给出了很生动的表述。
但是这里我有一疑问,为什么点积运算可以表示关注度?点积可以在一定程度表示两向量的关联性,这一点毫无疑问,但是凭什么关联性越高也意味着关注度(得分)越高呢?
李宏毅2022机器学习HW4 Speaker Identification上(Dataset &Self-Attention)的更多相关文章
- 李宏毅老师机器学习课程笔记_ML Lecture 3-1: Gradient Descent
引言: 这个系列的笔记是台大李宏毅老师机器学习的课程笔记 视频链接(bilibili):李宏毅机器学习(2017) 另外已经有有心的同学做了速记并更新在github上:李宏毅机器学习笔记(LeeML- ...
- 机器学习-Tensorflow之Tensor和Dataset学习
好了,咱们今天终于进入了现阶段机器学习领域内最流行的一个框架啦——TensorFlow.对的,这款由谷歌开发的机器学习框架非常的简单易用并且得到了几乎所有主流的认可,谷歌为了推广它的这个框架甚至单独开 ...
- 李宏毅老师机器学习课程笔记_ML Lecture 2: Where does the error come from?
引言: 最近开始学习"机器学习",早就听说祖国宝岛的李宏毅老师的大名,一直没有时间看他的系列课程.今天听了一课,感觉非常棒,通俗易懂,而又能够抓住重点,中间还能加上一些很有趣的例子 ...
- 李宏毅老师机器学习课程笔记_ML Lecture 1: ML Lecture 1: Regression - Demo
引言: 最近开始学习"机器学习",早就听说祖国宝岛的李宏毅老师的大名,一直没有时间看他的系列课程.今天听了一课,感觉非常棒,通俗易懂,而又能够抓住重点,中间还能加上一些很有趣的例子 ...
- 李宏毅老师机器学习课程笔记_ML Lecture 1: 回归案例研究
引言: 最近开始学习"机器学习",早就听说祖国宝岛的李宏毅老师的大名,一直没有时间看他的系列课程.今天听了一课,感觉非常棒,通俗易懂,而又能够抓住重点,中间还能加上一些很有趣的例子 ...
- 李宏毅老师机器学习课程笔记_ML Lecture 0-2: Why we need to learn machine learning?
引言: 最近开始学习"机器学习",早就听说祖国宝岛的李宏毅老师的大名,一直没有时间看他的系列课程.今天听了一课,感觉非常棒,通俗易懂,而又能够抓住重点,中间还能加上一些很有趣的例子 ...
- 李宏毅老师机器学习课程笔记_ML Lecture 0-1: Introduction of Machine Learning
引言: 最近开始学习"机器学习",早就听说祖国宝岛的李宏毅老师的大名,一直没有时间看他的系列课程.今天听了一课,感觉非常棒,通俗易懂,而又能够抓住重点,中间还能加上一些很有趣的例子 ...
- Python 机器学习实战 —— 监督学习(上)
前言 近年来AI人工智能成为社会发展趋势,在IT行业引起一波热潮,有关机器学习.深度学习.神经网络等文章多不胜数.从智能家居.自动驾驶.无人机.智能机器人到人造卫星.安防军备,无论是国家级军事设备还是 ...
- z/OS上Dataset 的移动
最近的一个需求,需要把大批量的Dataset移到新的Storage Class,新的Volume中去,刚开始感觉非常头疼.仔细研究后发现这个事情其实很简单.确实符合别人所说,事情的在你真正开始努力之后 ...
- 机器学习之神经网络模型-上(Neural Networks: Representation)
在这篇文章中,我们一起来讨论一种叫作"神经网络"(Neural Network)的机器学习算法,这也是我硕士阶段的研究方向.我们将首先讨论神经网络的表层结构,在之后再具体讨论神经网 ...
随机推荐
- vue在render函数中如何实现v-model和事件绑定(4)
1.h函数的三个参数 第一个参数是必须的. 类型:{String | Object | Function} 一个 HTML 标签名.一个组件.一个异步组件.或一个函数式组件. 是要渲染的html标签. ...
- Fabric区块链浏览器(2)
本文是区块链浏览器系列的第四篇. 在上一篇文章介绍如何解析区块数据时,使用session对客户端上传的pb文件进行区分,到期后自动删除. 在这片文章中,会着重介绍下认证系统的实现,主要分为三部分: 添 ...
- 全新Self-RAG框架亮相,自适应检索增强助力超越ChatGPT与Llama2,提升事实性与引用准确性
全新Self-RAG框架亮相,自适应检索增强助力超越ChatGPT与Llama2,提升事实性与引用准确性 1. 基本思想 大型语言模型(LLMs)具有出色的能力,但由于完全依赖其内部的参数化知识,它们 ...
- C# 笔记之基本语法
C#是一种现代的.通用的编程语言,由微软公司开发和推广.它于2000年发布,是一种结构化.面向对象和组件化的语言,旨在为Windows操作系统和Microsoft .NET框架提供强大的支持.可用于开 ...
- html的input type=file
文件上传:https://www.zhangxinxu.com/wordpress/2015/11/html-input-type-file/ some与every的使用:https://blog.c ...
- python-ssh链接linux查询日志,并按日志等级在控制台分颜色输出日志
import paramiko # unicode_utils.py def to_str(bytes_or_str): """ 把byte类型转换为str :param ...
- 4、Web前端学习规划:JavaScript - 学习规划系列文章
JavaScript作为Web前端里的第3重要的语言,笔者认为该重点进行学习.因为JavaScript衍生出来的框架和类库有不少,而且很强大.所以JavaScript的学习要抓好重点,在基本的语法及应 ...
- Python Fire:自动生成命令行接口
命令行程序是平时写一些小工具时最常用的方式. 为了让命令行程序更加灵活,我们常常会设置一些参数,根据参数让程序执行不同的功能.这样就不用频繁的修改代码来执行不同的功能. 随着命令行程序功能的丰富,也就 ...
- SpringBoot自动化配置
SpringBoot自动化配置 一.SpringBoot自动化配置原理 1.SpringBoot引导类注解介绍 在SpringBoot的启动引导类上有一个@SpringBootApplication注 ...
- Java锁到底是个什么东西
一.java锁存在的必要性 要认识java锁,就必须对2个前置概念有一个深刻的理解:多线程和共享资源. 对于程序来说,数据就是资源. 在单个线程操作数据时,或快或慢不存在什么问题,一个人你爱干什么干什 ...