
从R-CNN到FAST-RCNN再到Faster R-CNN
(Faster R-CNN: Towards Real-Time Object Detection with Region Proposal Networks)
R-CNN:
(1)输入测试图像;
(2)利用selective search 算法在图像中从上到下提取2000个左右的Region Proposal;
(3)将每个Region Proposal缩放(warp)成227*227的大小并输入到CNN,将CNN的fc7层的输出作为特征;
(4)将每个Region Proposal提取的CNN特征输入到SVM进行分类;
(5)对于SVM分好类的Region Proposal做边框回归,用Bounding box回归值校正原来的建议窗口,生成预测窗口坐标.
缺陷:
(1) 训练分为多个阶段,步骤繁琐:微调网络+训练SVM+训练边框回归器;
(2) 训练耗时,占用磁盘空间大;5000张图像产生几百G的特征文件;
(3) 速度慢:使用GPU,VGG16模型处理一张图像需要47s;
(4) 测试速度慢:每个候选区域需要运行整个前向CNN计算;
(5) SVM和回归是事后操作,在SVM和回归过程中CNN特征没有被学习更新.
FAST-RCNN:
(1)输入测试图像;
(2)利用selective search 算法在图像中从上到下提取2000个左右的建议窗口(Region Proposal);
(3)将整张图片输入CNN,进行特征提取;
(4)把建议窗口映射到CNN的最后一层卷积feature map上;
(5)通过RoI pooling层使每个建议窗口生成固定尺寸的feature map;
(6)利用Softmax Loss(探测分类概率) 和Smooth L1 Loss(探测边框回归)对分类概率和边框回归(Bounding box regression)联合训练.
相比R-CNN,主要两处不同:
(1)最后一层卷积层后加了一个ROI pooling layer;
(2)损失函数使用了多任务损失函数(multi-task loss),将边框回归直接加入到CNN网络中训练
改进:
(1) 测试时速度慢:R-CNN把一张图像分解成大量的proposal,每个proposal拉伸形成的图像都会单独通过CNN提取特征,这相当于对一张图像进行了2000次的提取特征和分类的过程!实际上这些建议框之间大量重叠,(这2000个proposal都是图像的一部分!)特征值之间完全可以共享,造成了运算能力的浪费.
SO 我们完全可以对图像提一次卷积层特征,然后只需要将Region Proposal在原图的位置映射到CNN最后一层的卷积层特征图上,这样对于一张图像我们只需要提一次卷积层特征,然后将每个Region Proposal的卷积层特征输入到全连接层做后续操作.(对于CNN来说,大部分运算都耗在卷积操作上,这样做可以节省大量时间).
(2) 训练时速度慢:R-CNN在训练时,是在采用SVM分类之前,把通过CNN提取的特征存储在硬盘上.这种方法造成了训练性能低下,因为在硬盘上大量的读写数据会造成训练速度缓慢.
FAST-RCNN在训练时,只需要将一张图像送入网络,每张图像一次性地提取CNN特征和建议区域,训练数据在GPU内存里直接进Loss层,这样候选区域的前几层特征不需要再重复计算且不再需要把大量数据存储在硬盘上.
(3) 训练所需空间大:R-CNN中独立的SVM分类器和回归器需要大量特征作为训练样本,需要大量的硬盘空间.FAST-RCNN把类别判断和位置回归统一用深度网络实现,不再需要额外存储.
FASTER -RCNN:
(1)输入测试图像;
(2)将整张图片输入CNN,进行特征提取;
(3)用RPN生成建议窗口(proposals),每张图片生成300个建议窗口;
(4)把建议窗口映射到CNN的最后一层卷积feature map上;
(5)通过RoI pooling层使每个RoI生成固定尺寸的feature map;
(6)利用Softmax Loss(探测分类概率) 和Smooth L1 Loss(探测边框回归)对分类概率和边框回归(Bounding box regression)联合训练.
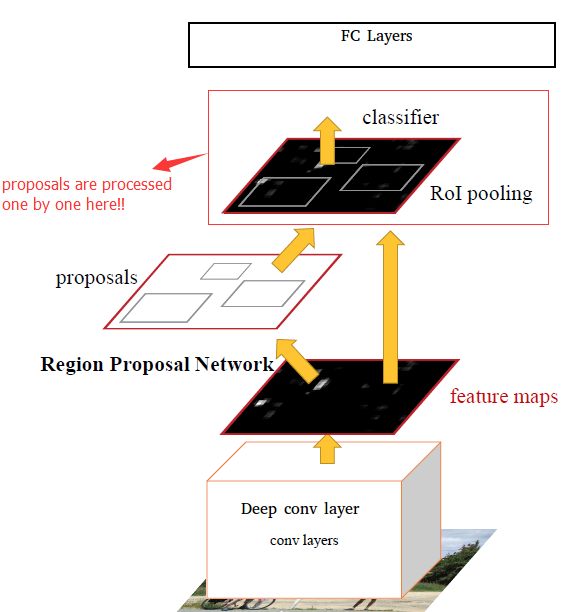
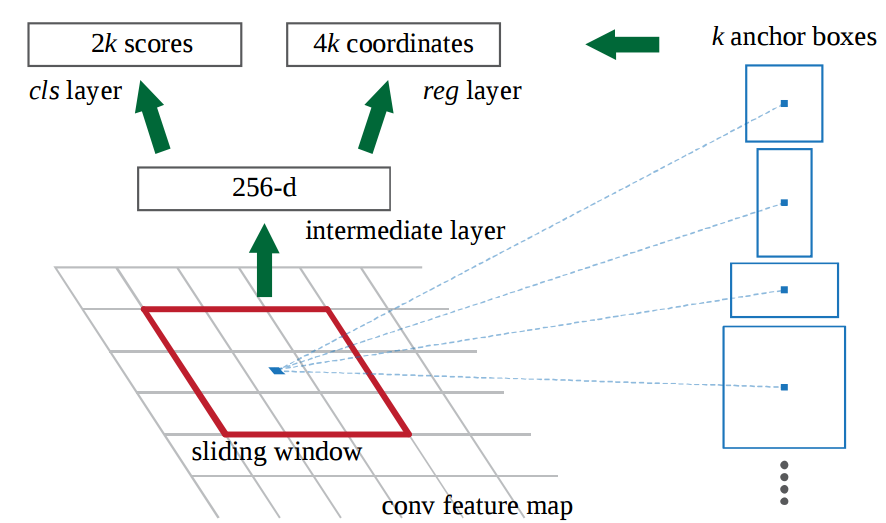
(RPN的输入是任意大小的图像,输出是一组打过分的候选框(object proposals)。在卷积的最后一层feature map上使用固定大小的窗口滑动,每个窗口会输出固定大小维度的特征(图中256),每一个窗口对候选的9个box进行回归坐标和分类(这里的分类表示box中是一个object,而不是具体的类别)。)
相比FASTER-RCNN,主要两处不同:
(1)使用RPN(Region Proposal Network)代替原来的Selective Search方法产生建议窗口;
(2)产生建议窗口的CNN和目标检测的CNN共享
改进:
(1) 如何高效快速产生建议框?
FASTER-RCNN创造性地采用卷积网络自行产生建议框,并且和目标检测网络共享卷积网络,使得建议框数目从原有的约2000个减少为300个,且建议框的质量也有本质的提高.
Bounding box regression:
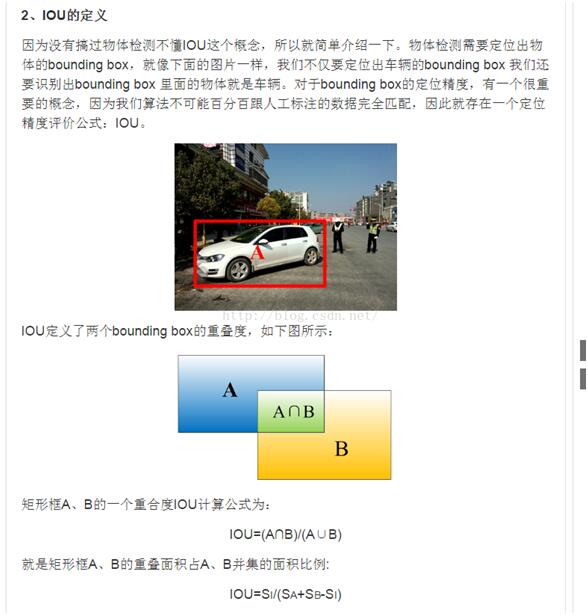
1.IOU
(2) 为什么要做Bounding-box regression?
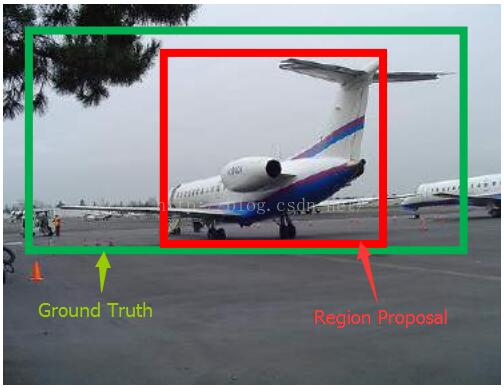
如上图所示,绿色的框为飞机的Ground Truth,红色的框是提取的Region Proposal.那么即便红色的框被分类器识别为飞机,但是由于红色的框定位不准(IoU<0.5),那么这张图相当于没有正确的检测出飞机.如果我们能对红色的框进行微调,使得经过微调后的窗口跟Ground Truth更接近,这样岂不是定位会更准确.确实,Bounding-box regression 就是用来微调这个窗口的.
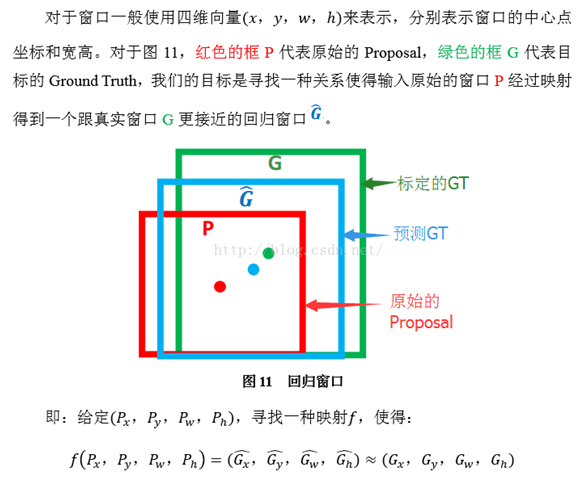
(3) 回归/微调的对象是什么?
RPN原理介绍:
RPN的实现方式:在conv5-3的卷积feature map上用一个n*n的滑窗(论文中作者选用了n=3,即3*3的滑窗)生成一个长度为256(对应于ZF网络)或512(对应于VGG网络)维长度的全连接特征.然后在这个256维或512维的特征后产生两个分支的全连接层:
(1)reg-layer,用于预测proposal的中心锚点对应的proposal的坐标x,y和宽高w,h;
(2)cls-layer,用于判定该proposal是前景还是背景.sliding window的处理方式保证reg-layer和cls-layer关联了conv5-3的全部特征空间.事实上,作者用全连接层实现方式介绍RPN层实现容易帮助我们理解这一过程,但在实现时作者选用了卷积层实现全连接层的功能.
(3)个人理解:全连接层本来就是特殊的卷积层,如果产生256或512维的fc特征,事实上可以用Num_out=256或512, kernel_size=3*3, stride=1的卷积层实现conv5-3到第一个全连接特征的映射.然后再用两个Num_out分别为2*9=18和4*9=36,kernel_size=1*1,stride=1的卷积层实现上一层特征到两个分支cls层和reg层的特征映射.
(4)注意:这里2*9中的2指cls层的分类结果包括前后背景两类,4*9的4表示一个Proposal的中心点坐标x,y和宽高w,h四个参数.采用卷积的方式实现全连接处理并不会减少参数的数量,但是使得输入图像的尺寸可以更加灵活.在RPN网络中,我们需要重点理解其中的anchors概念,Loss fucntions计算方式和RPN层训练数据生成的具体细节.
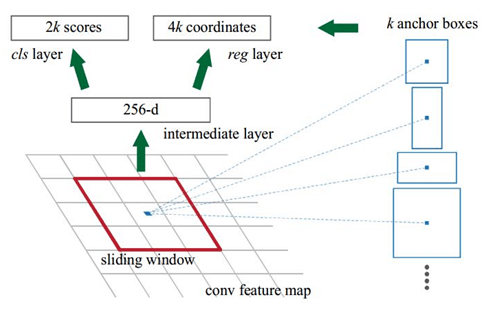
Anchors:字面上可以理解为锚点,位于之前提到的n*n的sliding window的中心处.对于一个sliding window,我们可以同时预测多个proposal,假定有k个.k个proposal即k个reference boxes,每一个reference box又可以用一个scale,一个aspect_ratio和sliding window中的锚点唯一确定.所以,我们在后面说一个anchor,你就理解成一个anchor box 或一个reference box.作者在论文中定义k=9,即3种scales和3种aspect_ratio确定出当前sliding window位置处对应的9个reference boxes, 4*k个reg-layer的输出和2*k个cls-layer的score输出.对于一幅W*H的feature map,对应W*H*k个锚点.所有的锚点都具有尺度不变性.
Loss functions:
在计算Loss值之前,作者设置了anchors的标定方法.正样本标定规则:
1) 如果Anchor对应的reference box与ground truth的IoU值最大,标记为正样本;
2) 如果Anchor对应的reference box与ground truth的IoU>0.7,标记为正样本.事实上,采用第2个规则基本上可以找到足够的正样本,但是对于一些极端情况,例如所有的Anchor对应的reference box与groud truth的IoU不大于0.7,可以采用第一种规则生成.
3) 负样本标定规则:如果Anchor对应的reference box与ground truth的IoU<0.3,标记为负样本.
4) 剩下的既不是正样本也不是负样本,不用于最终训练.
5) 训练RPN的Loss是有classification loss (即softmax loss)和regression loss (即L1 loss)按一定比重组成的.
计算softmax loss需要的是anchors对应的groundtruth标定结果和预测结果,计算regression loss需要三组信息:
i. 预测框,即RPN网络预测出的proposal的中心位置坐标x,y和宽高w,h;
ii. 锚点reference box:
之前的9个锚点对应9个不同scale和aspect_ratio的reference boxes,每一个reference boxes都有一个中心点位置坐标x_a,y_a和宽高w_a,h_a;
iii. ground truth:标定的框也对应一个中心点位置坐标x*,y*和宽高w*,h*.因此计算regression loss和总Loss方式如下:
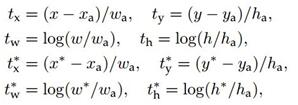
RoI Pooling:
在测试(inference)的时候,ROI Pooling从RPN网络得到候选的roi列表,通过conv5拿到所有的特征,进行后面的分类和回归。
在训练的时候,如果还是只使用RPN预测的roi可能会训练速度很慢或者loss就不收敛。这里需要对拿到的roi列表数据进行一些改造。
- 将ground-truth box加入到rpn_roi
- 通过rpn_roi和ground-truth box对比,调整覆盖覆盖比例
比较巧妙的一点是R-CNN的分类label生成和bbox的label生成,方法就是训练的时候根据每次生成的rpn_roi和gt对比,生成相应的标注信息,反向传播的时候只将目标类别的loss权重不为0,达到反向传播的时候只考虑正确的分类。
smooth L1 Loss:
使用的方法本质上就是滑动窗口。RPN的设计比较巧妙,RPN只需在最后的卷积层上滑动一遍,因为anchor机制和边框回归可以得到多尺度多长宽比的region proposal:
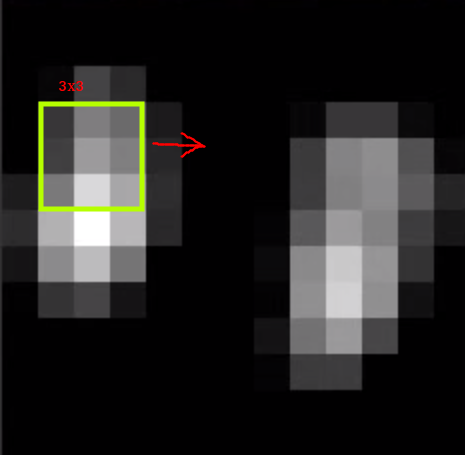
3*3滑窗对应的每个特征区域同时预测输入图像3种尺度(128,256,512),3种长宽比(1:1,1:2,2:1)的region proposal,这种映射的机制称为anchor:
从R-CNN到FAST-RCNN再到Faster R-CNN的更多相关文章
- 【深度学习】目标检测算法总结(R-CNN、Fast R-CNN、Faster R-CNN、FPN、YOLO、SSD、RetinaNet)
目标检测是很多计算机视觉任务的基础,不论我们需要实现图像与文字的交互还是需要识别精细类别,它都提供了可靠的信息.本文对目标检测进行了整体回顾,第一部分从RCNN开始介绍基于候选区域的目标检测器,包括F ...
- 目标检测算法之Fast R-CNN和Faster R-CNN原理
一.Fast R-CNN原理 在SPPNet中,实际上特征提取和区域分类两个步骤还是分离的.只是使用ROI池化层提取了每个区域的特征,在对这些区域分类时,还是使用传统的SVM作为分类器.Fast R- ...
- 目标检测算法的总结(R-CNN、Fast R-CNN、Faster R-CNN、YOLO、SSD、FNP、ALEXnet、RetianNet、VGG Net-16)
目标检测解决的是计算机视觉任务的基本问题:即What objects are where?图像中有什么目标,在哪里?这意味着,我们不仅要用算法判断图片中是不是要检测的目标, 还要在图片中标记出它的位置 ...
- Object Detection(RCNN, SPPNet, Fast RCNN, Faster RCNN, YOLO v1)
RCNN -> SPPNet -> Fast-RCNN -> Faster-RCNN -> FPN YOLO v1-v3 Reference RCNN: Rich featur ...
- RCNN (Regions with CNN) 目标物检测 Fast RCNN的基础
Abstract: 贡献主要有两点1:可以将卷积神经网络应用region proposal的策略,自底下上训练可以用来定位目标物和图像分割 2:当标注数据是比较稀疏的时候,在有监督的数据集上训练之后到 ...
- 标题 发布状态 评论数 阅读数 操作 操作 CNN目标检测系列算法发展脉络简析——学习笔记(三):Fast R-CNN
最近两周忙着上网课.投简历,博客没什么时间写,姑且把之前做的笔记放上来把... 下面是我之前看论文时记的笔记,之间copy上来了,内容是Fast R-CNN的,以后如果抽不出时间写博客,就放笔记上来( ...
- RCNN--对象检测的又一伟大跨越 2(包括SPPnet、Fast RCNN)(持续更新)
继续上次的学习笔记,在RCNN之后是Fast RCNN,但是在Fast RCNN之前,我们先来看一个叫做SPP-net的网络架构. 一,SPP(空间金字塔池化,Spatial Pyramid Pool ...
- Fast R-CNN论文理解
论文地址:https://arxiv.org/pdf/1504.08083.pdf 翻译请移步:https://blog.csdn.net/ghw15221836342/article/details ...
- Fast R-CNN论文详解 - CSDN博客
废话不多说,上车吧,少年 paper链接:Fast R-CNN &创新点 规避R-CNN中冗余的特征提取操作,只对整张图像全区域进行一次特征提取: 用RoI pooling层取代最后一层max ...
- 论文笔记:目标检测算法(R-CNN,Fast R-CNN,Faster R-CNN,FPN,YOLOv1-v3)
R-CNN(Region-based CNN) motivation:之前的视觉任务大多数考虑使用SIFT和HOG特征,而近年来CNN和ImageNet的出现使得图像分类问题取得重大突破,那么这方面的 ...
随机推荐
- HTML标签使用
`<!-- 什么是HTML 超文本标记语言 由标签(属性和实体组成)和内容组成 --> <!-- 定义文档类型 --> <!DOCTYPE html> <!- ...
- English trip V1 - B 16. Giving Reasons 提供个人信息 Teacher:Lamb Key: Why/Because
In this lesson you will learn how to give reasons for something you've done. 课上内容(Lesson) Why do peo ...
- VLC播放H264文件问题
VLC1.1.7版本默认情况下不能播放H264数据流.需要做如下设置
- 20180226xlVbaGetStockData
Sub LoopGetStockData() Dim StartTime As Variant Dim UsedTime As Variant StartTime = VBA.Timer Cells. ...
- Being a Good Boy in Spring Festival HDU - 1850
桌子上有M堆扑克牌:每堆牌的数量分别为Ni(i=1…M):两人轮流进行:每走一步可以任意选择一堆并取走其中的任意张牌:桌子上的扑克全部取光,则游戏结束:最后一次取牌的人为胜者. 现在我们不想研究到底先 ...
- Shiro中Realm
6.1 Realm [2.5 Realm]及[3.5 Authorizer]部分都已经详细介绍过Realm了,接下来再来看一下一般真实环境下的Realm如何实现. 1.定义实体及关系 即用户-角色 ...
- Oracle11g温习-第十二章:tables
2013年4月27日 星期六 10:44 1.表的功能 存储.管理数据的基本单元(二维表:由行和列组成) 2.表的类型 1)普通表:[heap table(堆表) :数据存储时,无序的,对它的访问采 ...
- SpringBoot热部署:spring-boot-devtools在Idea中热部署方法
1 pom.xml文件 注:热部署功能spring-boot-1.3开始有的 <!--添加依赖--> <dependency> <groupId>org.sprin ...
- android project
- 【转】vuex2.0 之 modules
vue 使用的是单一状态树对整个应用的状态进行管理,也就是说,应用中的所有状态都放到store中,如果是一个大型应用,状态非常多, store 就会非常庞大,不太好管理.这时vuex 提供了另外一种方 ...