
在Solr中配置和使用ansj分词
在上一节【编译Ansj之Solr插件】中介绍如何编译ansj分词在solr(lucene)环境中使用的接口,本章将介绍如何在solr中使用ansj,其步骤主要包括:下载或者编译ansj和nlp-lang等jar包、在schema中配置相关类型、将ansj和nlp-lang等jar包配置到solr中、测试ansj分词效果。
一、下载或者编译ansj-seg和nlp-lang等jar包。
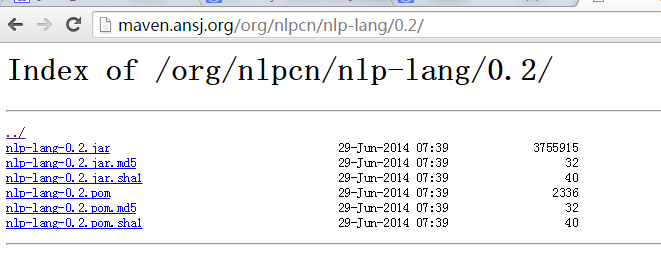
1、您可以到 http://maven.ansj.org/org/ansj/ansj_seg/ | http://maven.ansj.org/org/nlpcn/ 中下载相关jar包。
ansj-seg相关jar包,如下图所示:
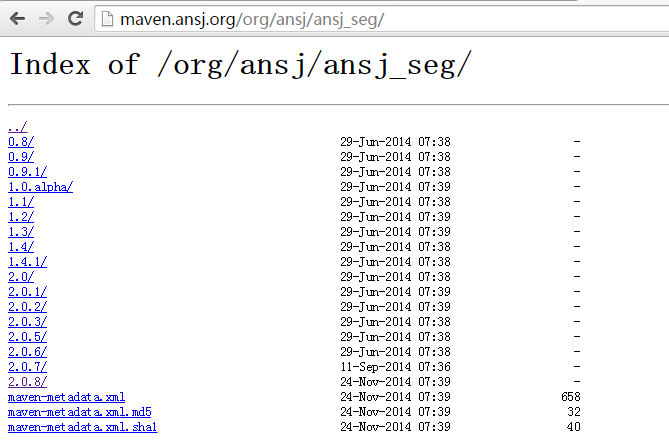
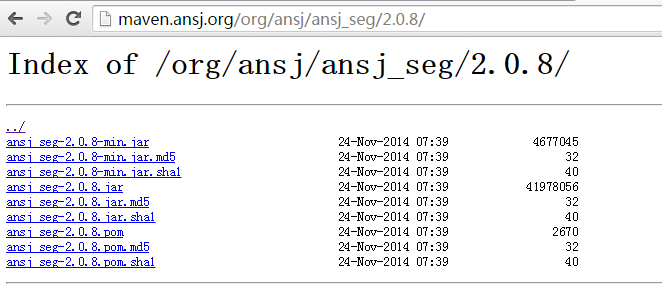
nlp-lang 是ansj-seg分词中关于自然语言处理相关工具类,功能比较强大:

2、下载相关源码,自己编译。
这种是相对复杂的,但是如果长久使用,这种是很有必要的。对于这种优秀的分词,我们更有必要好好研究一番。
github地址:https://github.com/NLPchina/ansj_seg
git客户端地址:http://git-scm.com/download/
git下载源码命令:git clone https://github.com/NLPchina/ansj_seg.git
下载后的文件结构如下:
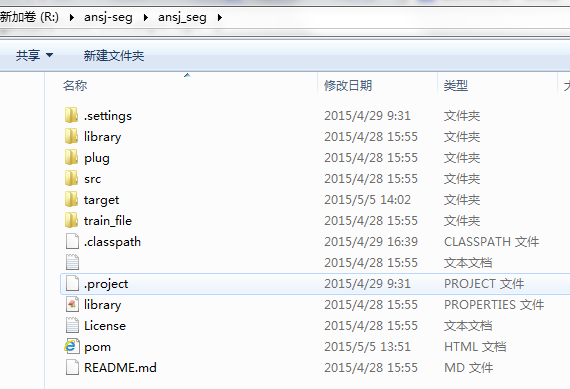
可见代码是用maven组中管理的。对于maven的安装配置本文旧粗略带过,主要包括:
下载maven相关包,解压:

配置环境变量M2_HOME:C:\apache-maven-3.2.1
配置PATHb环境变量:%M2_HOME%\bin;
mvn常有命令:mvn clean install#清理本地缓存、下载依赖jar包 可以添加-DskipTests=true忽略单元测试;mvn eclipse:clean #清理mvn生成的eclipse工程;mvn eclipse:eclipse #根据pom.xml生成eclipse工程。
步骤:
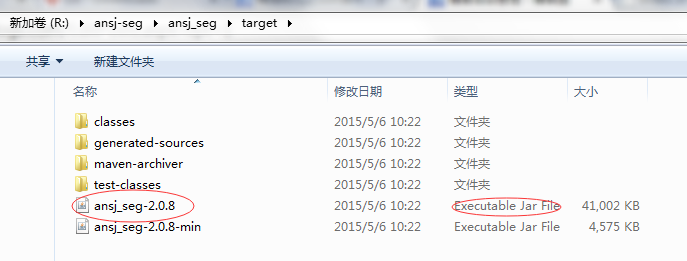
在源码根路径下执行: mvn clean install -DskipTests=true 命令,在target目录下生成jar包。
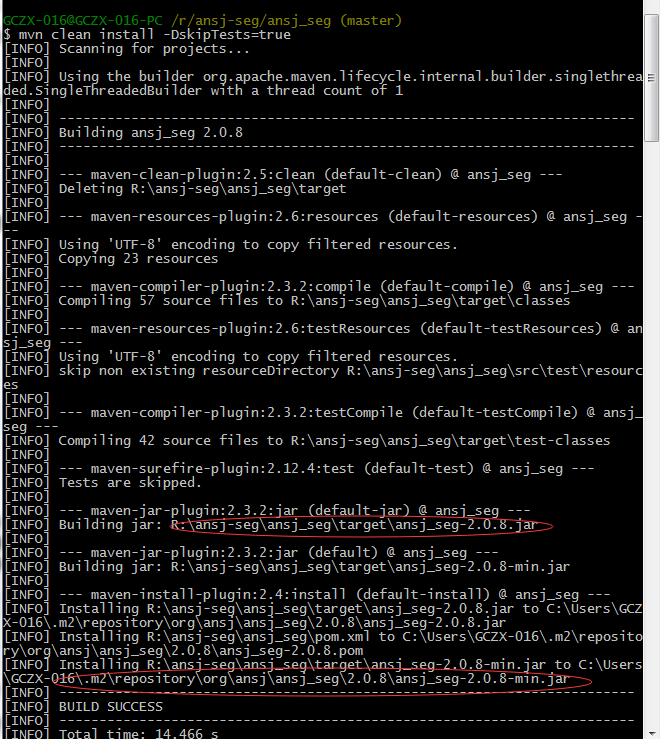
target目录:
同义的道理,可以编译nlp-lang jar包,地址:https://github.com/NLPchina/nlp-lang
二、在solr schema.xml中配置好ansj字段类型。
1、创建ansj类型。
找到schema.xml,添加ansj类型text_ansj:
	<!--ansj start -->

	<fieldType name="text_ansj" class="solr.TextField" positionIncrementGap="100">

    <analyzer type="index">

         <tokenizer class="org.ansj.solr.AnsjTokenizerFactory"  isQuery="false"/>

    </analyzer>

    <analyzer type="query">

        <tokenizer class="org.ansj.solr.AnsjTokenizerFactory"/>

    </analyzer>

</fieldType>

	<!--ansj end -->
org.ansj.solr.AnsjTokenizerFactory 是我们编译的ansj-lucene插件。
2、配置需要索引的字段。
   <!-- ansj_test field -->

   <field name="POI_OID" type="string" indexed="false" stored="true"/>

   <field name="POI_NAME" type="text_ansj" indexed="true" stored="false"/>

   <field name="POI_NAME_SUGGEST" type="string" indexed="false" stored="true"/>

   <field name="POI_ADDRESS" type="text_ansj" indexed="true" stored="false"/>

   <field name="POI_ADDRESS_SUGGEST" type="string" indexed="false" stored="true"/>

   <field name="POI_PHONE" type="string" indexed="true" stored="true"/>

   <field name="POI_TYPE" type="string" indexed="true" stored="true" multiValued="true"/>

   <field name="POI_URL" type="string" indexed="false" stored="true"/>

   <field name="POI_DIANPING" type="string" indexed="true" stored="true" />

   <field name="POI_BRAND" type="string" indexed="true" stored="true"/>

   <field name="POI_CITY" type="string" indexed="true" stored="true" multiValued="true"/>

   <field name="POI_TAG" type="text_ansj" indexed="true" stored="true"/>

   <field name="POI_LAT" type="double" indexed="false" stored="true"/>

   <field name="POI_LON" type="double" indexed="false" stored="true"/>

   <field name="POI_DATA_TYPE" type="string" indexed="true" stored="false"/>
三、在solr环境中配置好ansj。
在编译好的ansj-seg、nlp-lang、ansj_lucene4_plug 放到solr war包的lib下。
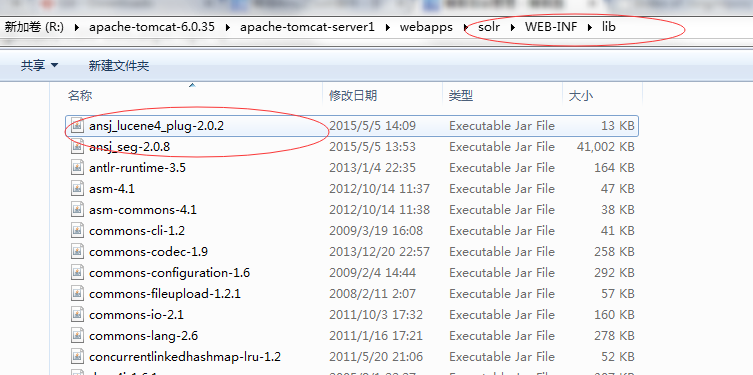
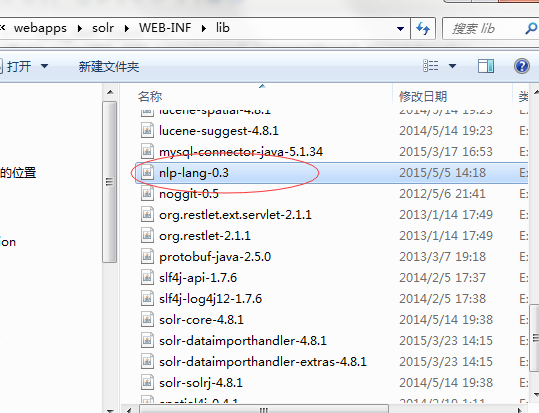
配置ansj相关词库和配置文件,这些配置文件在ansj源码目录下:
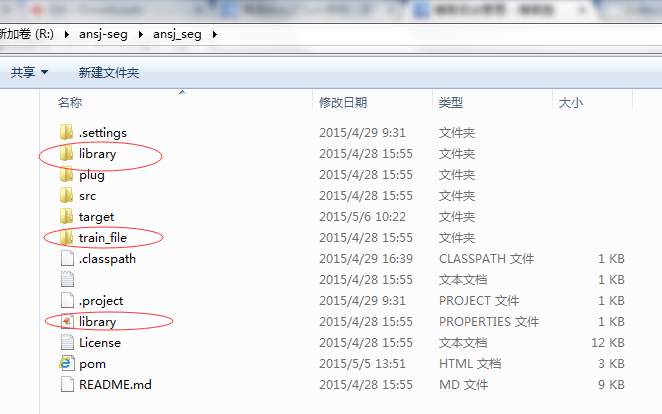
把这三个配置文件放到solr程序WEB-INF/classes目录下,classes目录不存在则手动创建。
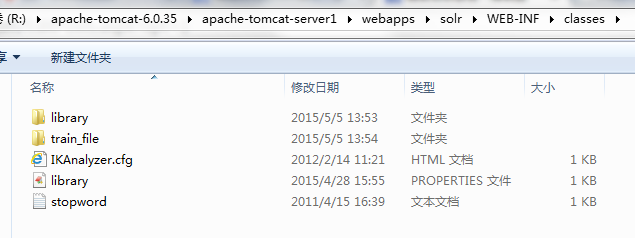
四、测试ansj分词效果。
ansj配置好了以后,把solr所在的tomcat启动一下。用solr管理页面查看效果:
1、测试分词 "南京市长江大桥”
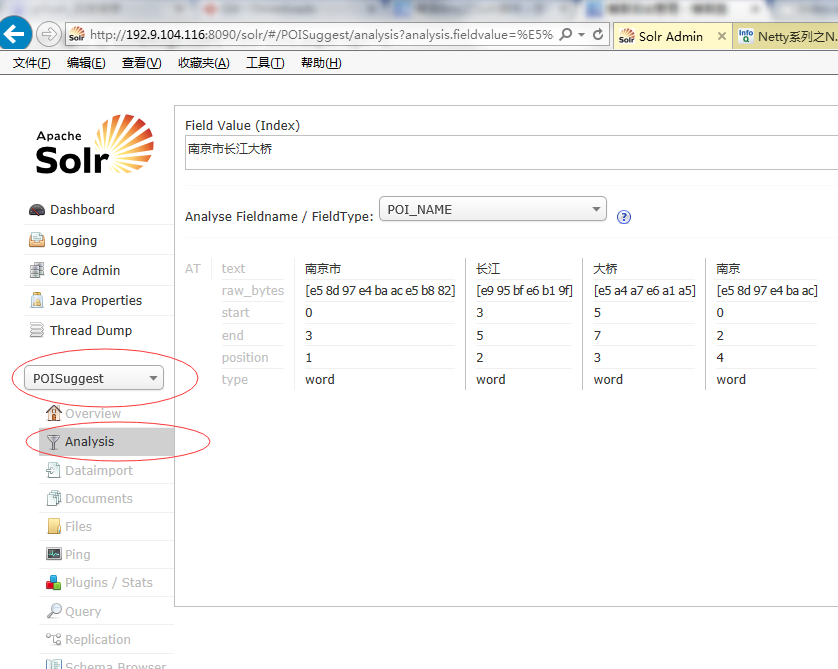
备注:在文本框中输入“南京市长江大桥” 点击右边蓝色的按钮“Analyse Values”
文章转载,请注明出处:http://www.cnblogs.com/likehua/p/4481219.html
在Solr中配置和使用ansj分词的更多相关文章
- 在Solr中配置中文分词IKAnalyzer
李克华 云计算高级群: 292870151 交流:Hadoop.NoSQL.分布式.lucene.solr.nutch 在Solr中配置中文分词IKAnalyzer 1.在配置文件schema.xml ...
- Solr 06 - Solr中配置使用IK分词器 (配置schema.xml)
目录 1 配置中文分词器 1.1 准备IK中文分词器 1.2 配置schema.xml文件 1.3 重启Tomcat并测试 2 配置业务域 2.1 准备商品数据 2.2 配置商品业务域 2.3 配置s ...
- Solr的配置和在java中的使用
Solr是一个全局站内搜索引擎,可以快速的搜索出结果. Solr依赖于tomcat,把Solr的war包放到tomcat中即可运行. 使用solr,需要在solr的schema.xml中配置solr与 ...
- Solr中Schema.xml中文版
<?xml version="1.0" encoding="UTF-8" ?> <!-- Licensed to the Apache Sof ...
- ansj分词
本文转载至:https://blog.csdn.net/bitcarmanlee/article/details/53607776 最近的项目需要使用到分词技术.本着不重复造轮子的原则,使用了ansj ...
- Solr索引配置
Solr主配置文件 schema.xml,在SolrCore的conf目录下,它是Solr数据表配置文件,它定义了加入索引的数据的数据类型的.主要包括FieldTypes.Fields和其他的一些缺省 ...
- elasticsearch安装ansj分词器
1.概述 elasticsearch用于搜索引擎,需要设置一些分词器来优化索引.常用的有ik_max_word: 会将文本做最细粒度的拆分.ik_smart: 会做最粗粒度的拆分.ansj等. ...
- BugPhobia沟通篇章:Solr模式配置与数据导入调研
0x01 :Scrum Meeting特别说明 特别说明,考虑到编译原理课程考核的时间安排,每天开发时间急剧缩短以至于难以维系正常的Scrum Meeting,因此,将2015/12/13 00:00 ...
- ansj分词史上最详细教程
最近的项目需要使用到分词技术.本着不重复造轮子的原则,使用了ansj_seg来进行分词.本文结合博主使用经过,教大家用最快的速度上手使用ansj分词. 1.给ansj来个硬广 项目的github地址: ...
随机推荐
- SNMPv3/pygal制图/smtplib发邮件
SNMPv3 SNMPv3在路由器端的配置 这个我都没配置过,还得现学现卖这个链接说的是SNMPv3的基本配置 这个链接说的是SNMPv3的view命令,用于管理员可以看到哪些层级的内容 1) 配置 ...
- PyCharm使用(完全图解(最新经典))
PyCharm使用 一.PyCharm设置(版本:PyCharm 2016.1.2) 1.python环境设置 1.1.pycharm新建程序自动补全编码和环境: pycharm设置在 ...
- 微信网页授权(OAuth2.0) PHP 源码简单实现
提要: 1. 建议对OAuth2.0协议做一个学习. 2. 微信官方文档和微信官网工具要得到充分利用. 比较简单,直接帖源代码了.其中“xxxxxxxxxx”部分,是需要依据自己环境做替换的 /** ...
- JavaScript中的普通函数与构造函数比较
问题 什么是构造函数?构造函数与普通函数区别是什么?用new关键字的时候到底做了什么?构造函数有返回值怎么办?构造函数能当普通函数调用吗? thisthis永远指向当前正在被执行的函数或方法的owne ...
- 关于一些网络代理实现智能流量分流的研究(PAC脚本介绍及利用)
因为工作原因,需要访问一些国外的网站(科学上网),但直接FQ并不方便,于是研究了一些代理软件,比如Nydus,Green等, 在Nydus的Proxy版本中发现了实现国内国外流量的智能分流的办法,通过 ...
- [Java] Tomcat环境变量设置
@echo off title Tomcat环境变量设置 color 0a set /p inputTH=D:\Work\024_Tomcat if /i "%inputTH%"= ...
- IDA调试android so文件.init_array和JNI_OnLoad
我们知道so文件在被加载的时候会首先执行.init_array中的函数,然后再执行JNI_OnLoad()函数.JNI_Onload()函数因为有符号表所以非常容易找到,但是.init_array里的 ...
- html 常用的标签
1.html 的基本格式 <html> <head> <meta charset="UTF-8"> <title>HTML5的标题& ...
- iOS 页面跳转传值,属性传值,代理传值,代码块传值,单例传值,通知传值
有时候我们在页面跳转的时候回传递相应的参数,如,你想把在第一个页面的文本框里的内容显示在第二个文本框中,或者你又想把第二个文本框中的内容改变之后到第一个页面的文本框中,所有,这个时候我们就要用到页面跳 ...
- C++自定义修饰键,实现如<Capslock+J>等组合键的按键映射
前:所谓修饰键,就是Ctrl,Alt,Shift,Win这些按键. Update: 我使用AHK写了一个功能更丰富的脚本:https://github.com/h46incon/ModifierCus ...