
NCCL(Nvidia Collective multi-GPU Communication Library) Nvidia英伟达的Multi-GPU多卡通信框架NCCL 学习;PCIe 速率调研;
为了了解,上来先看几篇中文博客进行简单了解:
- 如何理解Nvidia英伟达的Multi-GPU多卡通信框架NCCL?(较为优秀的文章)
- 使用NCCL进行NVIDIA GPU卡之间的通信(GPU卡通信模式测试)
- nvidia-nccl 学习笔记 (主要是一些接口介绍)
- https://developer.nvidia.com/nccl (官方网站)
- https://github.com/NVIDIA/nccl (官方仓库)
- https://www.cnblogs.com/xuyaowen/p/heterogeneous-system-architecture.html GPU 相关架构
- https://www.nvidia.cn/data-center/nvlink/ (NVLink)
- https://docs.nvidia.com/deeplearning/sdk/nccl-developer-guide/docs/overview.html (nccl doc)
内容摘录:
- 通信性能(应该主要侧重延迟)是pcie switch > 同 root complex (一个cpu接几个卡) > 不同root complex(跨cpu 走qpi)。ib的gpu direct rdma比跨cpu要快,所以甚至单机八卡要按cpu分成两组,每组一个switch,下面四个卡,一个ib,不通过cpu的qpi通信,而是通过ib通信。- 摘自评论
- 对于多个GPU卡之间相互通信,硬件层面上的实现有Nvlink、PCIe switch(不经过CPU)、Infiniband、以及PCIe Host Bridge(通常就是借助CPU进行交换)这4种方式。而NCCL是Nvidia在软件层面对这些通信方式的封装。
保持更新,更多内容,请参考cnblogs.com/xuyaowen;
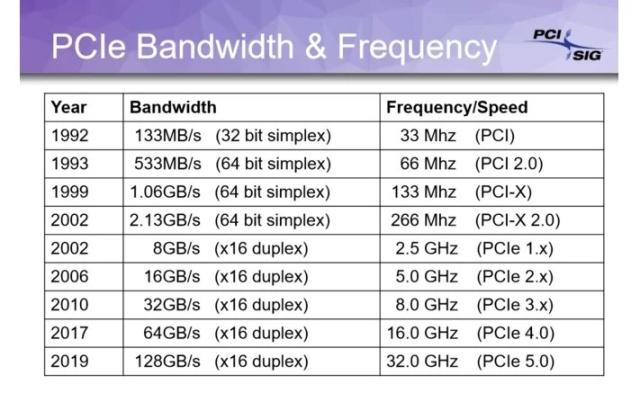
z390 芯片组资料:
https://ark.intel.com/content/www/cn/zh/ark/products/133293/intel-z390-chipset.html
P2P 显卡通信性能测试:
cuda/samples/1_Utilities/p2pBandwidthLatencyTest
nvidia 驱动安装:
https://www.cnblogs.com/xuyaowen/p/nvidia-driver-cuda-installation.html
nccl 编译安装过程:
git clone git@github.com:NVIDIA/nccl.git
cd nccl
make -j src.build (进行编译)
cd build
export LD_LIBRARY_PATH=$LD_LIBRARY_PATH:/home/yourname/nccl/build/lib # 添加环境变量;也可以配置环境变量.bashrc;
export C_INCLUDE_PATH=/home/yourname/nccl/build/include (设置 C 头文件路径)
export CPLUS_INCLUDE_PATH=/home/yourname/nccl/build/include (设置C++头文件路径)
测试是否安装成功:
git clone https://github.com/NVIDIA/nccl-tests.git
cd nccl-tests
make CUDA_HOME=/path/to/cuda NCCL_HOME=/path/to/nccl (具体编译,可以参考官方文档)
./build/all_reduce_perf -b 8 -e 256M -f 2 -g <ngpus>
才是
NCCL(Nvidia Collective multi-GPU Communication Library) Nvidia英伟达的Multi-GPU多卡通信框架NCCL 学习;PCIe 速率调研;的更多相关文章
- 基于英伟达Jetson TX1的GPU处理平台
基于英伟达Jetson TX1 GPU的HDMI图像输入的深度学习套件 [309] 本平台基于英伟达的Jetson TX1视觉计算的全功能开发板,配合本公司研发的HDMI输入图像采集板:Jetson ...
- 英伟达GPU 嵌入式开发平台
英伟达GPU 嵌入式开发平台 1. JETSON TX1 开发者组件 JETSON TX1 开发者组件是视觉计算的全功能 开发平台,旨在让您能够快速地安装和运行. 该组件带有 Lin ...
- 玩深度学习选哪块英伟达 GPU?有性价比排名还不够!
本文來源地址:https://www.leiphone.com/news/201705/uo3MgYrFxgdyTRGR.html 与“传统” AI 算法相比,深度学习(DL)的计算性能要求,可以说完 ...
- 英伟达GPU虚拟化---申请英伟达测试License
此文基于全新的License 2.0系统,针对vGPU License的试用申请以及软件下载和License管理进行了详细的说明,方便今后我们申请测试License,快速验证GPU的功能. 试用步骤: ...
- Linux查看英伟达GPU信息
命令: nvidia-smi 结果:
- 学习笔记︱Nvidia DIGITS网页版深度学习框架——深度学习版SPSS
DIGITS: Deep Learning GPU Training System1,是由英伟达(NVIDIA)公司开发的第一个交互式深度学习GPU训练系统.目的在于整合现有的Deep Learnin ...
- MLHPC 2018 | Aluminum: An Asynchronous, GPU-Aware Communication Library Optimized for Large-Scale Training of Deep Neural Networks on HPC Systems
这篇文章主要介绍了一个名为Aluminum通信库,在这个库中主要针对Allreduce做了一些关于计算通信重叠以及针对延迟的优化,以加速分布式深度学习训练过程. 分布式训练的通信需求 通信何时发生 一 ...
- Aluminum: An Asynchronous, GPU-Aware Communication Library Optimized for Large-Scale Training of Deep Neural Networks on HPC Systems
本文发表在MLHPC 2018上,主要介绍了一个名为Aluminum通信库,这个库针对Allreduce做了一些关于计算通信重叠以及针对延迟的优化,以加速分布式深度学习训练过程. 分布式训练的通信需求 ...
- GPU 编程入门到精通(五)之 GPU 程序优化进阶
博主因为工作其中的须要,開始学习 GPU 上面的编程,主要涉及到的是基于 GPU 的深度学习方面的知识.鉴于之前没有接触过 GPU 编程.因此在这里特地学习一下 GPU 上面的编程. 有志同道合的小伙 ...
随机推荐
- redlock算法及其问题
背景 redlock算法是为了解决什么问题呢? 在单redis实例实现分布式锁时,可能会出现线程A设置完锁后,master挂掉,slave提升为master,因为异步复制的特性,线程A设置的锁丢失了, ...
- IM即时通信软件设计
参考资料: 架构篇:https://yq.aliyun.com/articles/698301 模型篇:https://yq.aliyun.com/articles/701593 实现篇:https: ...
- Password Management:Password in Configuration File 密码管理:配置文件中的密码
- Dubbo学习系列之十四(Seata分布式事务方案AT模式)
一直说写有关最新技术的文章,但前面似乎都有点偏了,只能说算主流技术,今天这个主题,我觉得应该名副其实.分布式微服务的深水区并不是单个微服务的设计,而是服务间的数据一致性问题!解决了这个问题,才算是把分 ...
- js 注意事项使用误区
1.加法注意事项 2.浮点数注意事项 3.js,数组需使用数字作为下标索引,不支持关联数组的用法.对象不能混淆使用数组的length方法,并且不能使用数字作为下标,得使用属性值作为下标使用,否则会返回 ...
- CentOS 安装Asp.net Core & FTP服务
网络设置 确认是否成功连网: ping baidu.com 如果无法上网请检查以下设置 ip link show vim /etc/sysconfig/network-scripts/ipcfg-(看 ...
- diango入门(持续更新中)
学习注意点:理顺项目逻辑,记住重点,项目做好重点注释保留好,以后做项目了能知道这样可以实现,忘了回来查 下载 命令行 pip install django==1.11.26 -i https://py ...
- 斐波那契数列(Java)
一.什么是斐波那契数列 斐波那契数列(Fibonacci sequence),又称黄金分割数列.因数学家列昂纳多·斐波那契(Leonardoda Fibonacci)以兔子繁殖为例子而引入,故又称为& ...
- 十一、Powell算法(鲍威尔算法)原理以及实现
一.介绍 Powell算法是图像配准里面的常用的加速算法,可以加快搜索速度,而且对于低维函数的效果很好,所以本篇博客主要是为了介绍Powell算法的原理以及实现. 由于网上已经有了对于Powell算法 ...
- 数组类的创建——StaticArray.h
创建好的基于顺序存储结构的线性表存在两个方面的问题:1)功能上的问题:数组操作符的重载带来的问题,有可能线性表被无用为数组了,线性表被当做数组来使用了.2)效率方面的问题 本篇博客就要解决功能上的问题 ...