
python网络爬虫学习笔记(二)BeautifulSoup库
Beautiful Soup库也称为beautiful4库、bs4库,它可用于解析HTML/XML,并将所有文件、字符串转换为'utf-8'编码。HTML/XML文档是与“标签树一一对应的。具体地说,Beautiful Soup库是可以解析、遍历、维护HTML/XML文件的“标签树”的功能库。本文总结了BeautifulSoup的基本使用方法。
一、Beautiful Soup库基本元素
库的比较常见的引用方式如下
from bs4 import BeautifulSoup #从Beautiful Soup库引入BeautifulSoup类
import bs4 #直接引入Beautiful Soup库
Beautiful Soup库可用的解析器有以下4种:
- bs4的HTML解析器:BeautifulSoup(mk, 'html.parser')
- lxml的HTML解析器:BeautifulSoup(mk, 'lxml')
- lxml的XML解析器:BeautifulSoup(mk, 'xml')
- html5lib的解析器:BeautifulSoup(mk, 'html5lb')
BeautifulSoup类对应一个HTML/XML文档的全部内容,其5种基本元素罗列如下:
- Tag:标签,最基本的信息组织单元,分别用<>和</>标明开头和结尾
- Name:标签的名字,<p>...</p>的名字是'p',格式<tag>.name
- Attributes:标签的属性,字典形式组织,格式<tag>.attrs
- NavigableString:标签内非属性字符串,<>...</>中字符串,格式<tag>.string
- Comment:标签内字符串的注释部分,一种特殊的Comment类型
下面一段运行实例,其中demo是一段HTML代码

我们看一下a标签,其父标签以及祖父标签的名字

接下来,解析a标签的属性

从中可以看到,属性是字典类型。
再看一看标签本身的类型

标签的NavigableString元素

获取标签的Comment(与获取NavigableString比较)

p标签包含b标签,然而p.string并不包含b标签,这说明NavigableString是可以跨越多个标签层次的。
二、利用Beautiful Soup库遍历HTML内容
前面提到,HTML文档其实就是一棵标签树。对HTML的遍历即是对标签树的遍历。遍历的方式分为上行遍历、下行遍历和平行遍历。
2.1 标签树的下行遍历
标签树的下行遍历包含三个属性
- .contents:子节点的列表,将<tag>所有儿子节点存入列表
- .children:子节点的迭代类型,与.content相似,用于循环遍历儿子节点
- .descendants:子孙节点的迭代类型,包含所有子孙节点,用于循环遍历
使用.contents获取子节点列表的示例如下
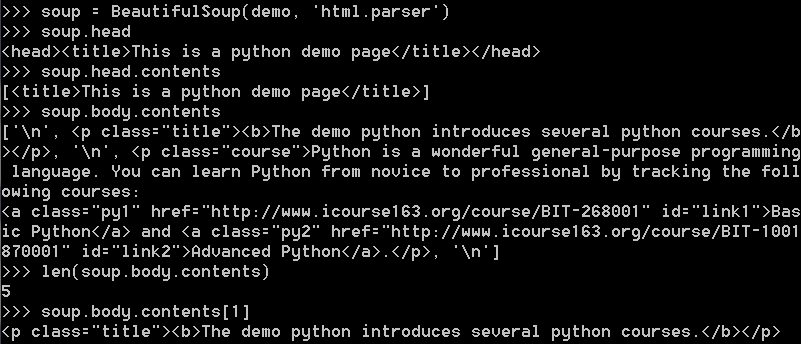
一般地,如果要遍历子节点,可以用如下代码框架
for child in soup.body.children:

    print(child)
如果要遍历子孙节点,则可以用如下代码框架
for child in soup.body.descendents:

    print(child)
2.2 标签树的上行遍历
上行遍历包含的属性罗列如下:
- .parent:节点的父亲标签
- .parents:节点先辈标签的迭代模型,用于循环遍历先辈节点
下面是使用.parent获取父标签的一段实例
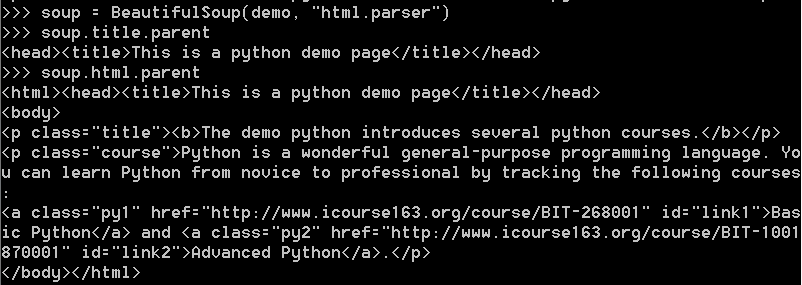
这里看到,html是最高级的标签,因此其父标签即为自己。
一般地,对标签树进行上行遍历,可采用如下代码框架
for parent in soup.a.parents:

    if parent is None:

        print(parent)

    else:

        print(parent.name)
相应给出一段运行实例:打印所有先辈标签的名字
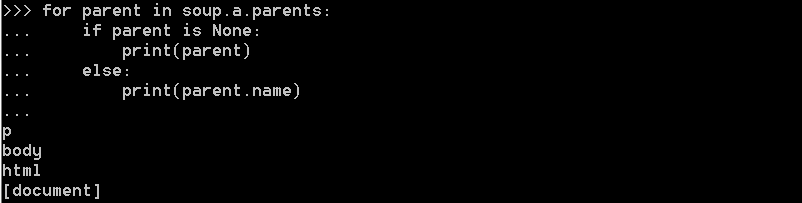
2.3 标签树的平行遍历
Beautiful Soup库提供以下四种平行遍历属性:
- .next_sibling:返回按照HTML文本顺序的下一个平行节点标签
- .previous_sibling:返回按照HTML文本顺序的上一个平行节点标签
- .next_siblings:迭代类型,返回按照HTML文本顺序的后续所有平行节点标签
- .previous_siblings:迭代类型,返回按照HTML文本顺序的前续所有平行节点标签
值得注意的是,平行遍历是在同一个父节点下建立的。
一段运行实例
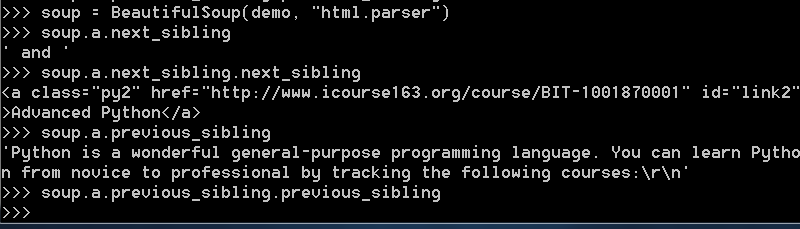
最后,soup.a.previous_sibling.previous_sibling没有输出,说明a标签的前一个再前一个节点标签为空。
一般地,标签树的平行遍历可采用如下代码框架
for sibling in soup.a.next_siblings: #遍历后续节点

    print(sibling)
for sibling in soup.a.previous_siblings: #遍历前续节点

    print(sibling)
三、基于Beautiful Soup库的HTML格式输出
bs4库提供了prettify()方法,用于对HTML的内容给出更友好的输出。
下面是一段运行实例
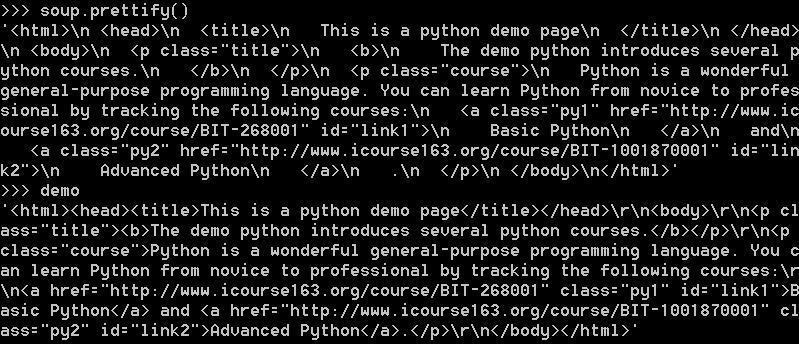
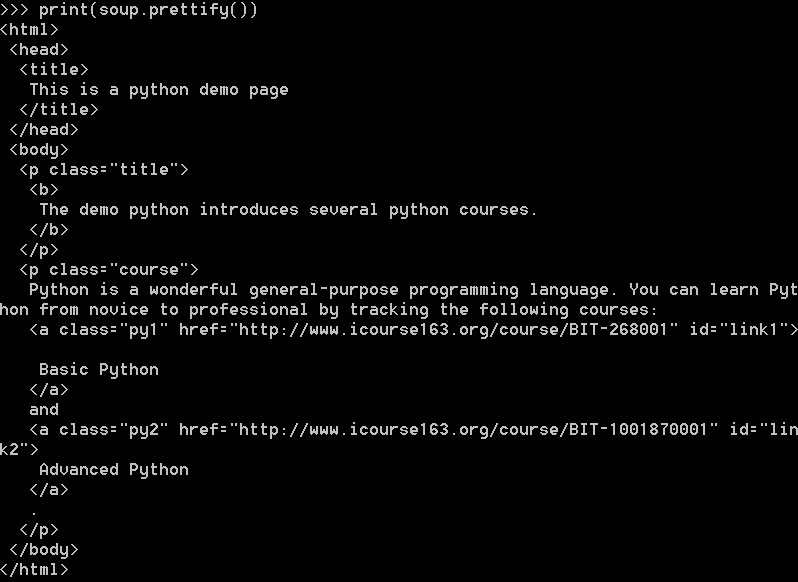
看到pretiffy()在每个标签后添加了换行符'\n'。将相关信息打印出来,得到如下结果
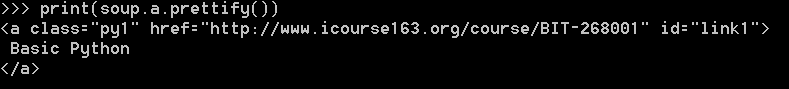
prettify()也可以对某一个标签进行处理,示例如下
相关内容为笔者根据中国大学MOOC网站嵩天教授的python爬虫课程所撰写的学习笔记,感谢中国MOOC学习平台提供的学习资源与嵩老师的授课。
python网络爬虫学习笔记(二)BeautifulSoup库的更多相关文章
- python网络爬虫学习笔记
python网络爬虫学习笔记 By 钟桓 9月 4 2014 更新日期:9月 4 2014 文章文件夹 1. 介绍: 2. 从简单语句中開始: 3. 传送数据给server 4. HTTP头-描写叙述 ...
- python网络爬虫学习笔记(一)Request库
一.Requests库的基本说明 引入Rquests库的代码如下 import requests 库中支持REQUEST, GET, HEAD, POST, PUT, PATCH, DELETE共7个 ...
- 关于Python网络爬虫实战笔记③
Python网络爬虫实战笔记③如何下载韩寒博客文章 Python网络爬虫实战笔记③如何下载韩寒博客文章 target:下载全部的文章 1. 博客列表页面规则 也就是, http://blog.sina ...
- python爬虫学习(一):BeautifulSoup库基础及一般元素提取方法
最近在看爬虫相关的东西,一方面是兴趣,另一方面也是借学习爬虫练习python的使用,推荐一个很好的入门教程:中国大学MOOC的<python网络爬虫与信息提取>,是由北京理工的副教授嵩天老 ...
- 关于Python网络爬虫实战笔记①
python网络爬虫项目实战笔记①如何下载韩寒的博客文章 python网络爬虫项目实战笔记①如何下载韩寒的博客文章 1. 打开韩寒博客列表页面 http://blog.sina.com.cn/s/ar ...
- 《精通python网络爬虫》笔记
<精通python网络爬虫>韦玮 著 目录结构 第一章 什么是网络爬虫 第二章 爬虫技能概览 第三章 爬虫实现原理与实现技术 第四章 Urllib库与URLError异常处理 第五章 正则 ...
- Python网络爬虫学习总结
1.检查robots.txt 让爬虫了解爬取该网站时存在哪些限制. 最小化爬虫被封禁的可能,而且还能发现和网站结构相关的线索. 2.检查网站地图(robots.txt文件中发现的Sitemap文件) ...
- python网络爬虫(三)requests库的13个控制访问参数及简单案例
酱酱~小编又来啦~
- python爬虫学习之使用BeautifulSoup库爬取开奖网站信息-模块化
实例需求:运用python语言爬取http://kaijiang.zhcw.com/zhcw/html/ssq/list_1.html这个开奖网站所有的信息,并且保存为txt文件和excel文件. 实 ...
随机推荐
- Angular/cli 安装(windows环境)。
1.卸载先前安装的Angular/cli npm uninstall -g angular-clinpm uninstall --save-dev angular-clinpm uninstall - ...
- imeiimsi生成规则
添加SMI 和 IMSI修改 添加模拟器名修改(MEmu_ 修改成其他的名字,不支持批量修改) IMSI第十位:7代表是145卡,6代表186卡,3代表156,0代表130,其他的可以自己找 预 ...
- 【EMV L2】CDA复合动态数据认证/应用密文生成
复合动态数据认证/应用密文生成处理流程:对于复合动态数据认证/应用密文生成,终端执行标准动态数据认证的步骤1到3:1.认证中心公钥的获取终端使用认证中心公钥索引(PKI)以及卡片中的注册的应用提供商标 ...
- docker for windows 部署gitlab
gitlab的安装相对繁琐,如果使用docker 镜像的方式就轻松太多了. 我是用的环境是windows10 专业版 + docker for windows 1.右键docker打开Kitemati ...
- CSS学习笔记_day1
目录 一. 什么是HTML 二.编辑器 三.Html的基本骨架 四.html基本标签 h.p.img.a.audio.video.ul>li.ol>li.dl dd dt.span.div ...
- JMeter在linux服务器上使用
环境部署: 1.在Linux服务器先安装jdk:此步骤省略,可参考百度经验:https://jingyan.baidu.com/article/6b18230980c294ba59e15967.htm ...
- 输入框VS软键盘
最近在做一个h5的时候遇到的问题 我们都知道当页面上的有输入框被选中了,这个时候就回调出键盘用户可以输入.但是安卓手机在弹出键盘时页面的输入框也会被覆盖住: 以下为暂时的解决办法:(以下方法同时解决了 ...
- 渗透测试学习 二、Windows基础
系统目录 服务 端口 注册表 黑客常用DOS命令(在拿到shell时会用到) 一. 系统目录 Windows目录 系统的安装目录 System32àconfigàSAM文件 是用户密码的 ...
- requests 爬虫
爬虫 常用爬虫爬取网页,但如果一直爬取会被ban掉,因此需要对爬虫进行一些改进反反爬 使用requests和beautifulsoup4构建爬虫,1.随机user-agent:2.ip代理:4.coo ...
- vc6.0问题
1.VC6不自动提示函数的参数 是工程中的.ncb文件有问题,把这个文件删除就正常了. 2.设置代码提示快捷键 Tools-->定制-->弹出框,按照下图设置 3.报错 (1)ident ...