
结巴库及词频统计bb
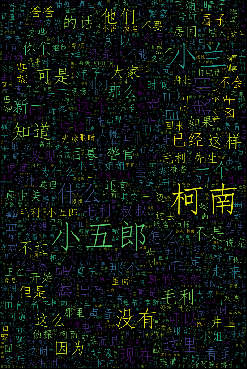
下面是利用云图和结巴库完成词频统计。代码如下:
# -*- coding:utf- -*-

from wordcloud import WordCloud

import matplotlib.pyplot as plt

import numpy as np

from PIL import Image

from jieba import *

def Replace(text,old,new): #替换列表的字符串

    for char in old:

        text = text.replace(char,new)

    return text

def getText(filename): #读取文件内容(utf- 编码格式)

    #特殊符号和部分无意义的词

    sign = '''!~·@¥……*“”‘’\n(){}【】;:"'「,」。-、?'''

    txt = open('{}.txt'.format(filename),encoding='utf-8').read()

    return Replace(txt,sign," ")

def creat_word_cloud(filename): #将filename 文件的词语按出现次数输出为词云图

    text = getText(filename) #读取文件

    wordlist = lcut(text) #jieba库精确模式分词

    wl = ' '.join(wordlist) #生成新的字符串

    #设置词云图

    font = r'C:\Windows\Fonts\simfang.ttf' #设置字体路径

    wc = WordCloud(

        background_color = 'black', #背景颜色

        max_words = ,           #设置最大显示的词云数

        font_path = font,           #设置字体形式(在本机系统中)

        height = ,              #图片高度

        width = ,               #图片宽度

        max_font_size = ,        #字体最大值

        random_state = ,         #配色方案的种类

        )

    myword = wc.generate(wl) #生成词云

    #展示词云图

    plt.imshow(myword)

    plt.axis('off')

    plt.show()

    #以原本的filename命名保存词云图

    wc.to_file('{}.png'.format(filename))

if __name__ == '__main__':

    creat_word_cloud('Detective_Novel') #输入文件名生成词云图
注:代码使用的文档 >>> Detective_Novel(utf-8).zip[点击下载],也可自行找 utf-8 编码格式的txt文件。
效果如下:
结巴库及词频统计bb的更多相关文章
- 软工结对项目之词频统计update
队友 胡展瑞 031602215 作业页面 GitHub 具体分工 111500206 赵畅:负责WordCount的升级,添加新的命令行参数支持(自定义输入输出文件,权重词频统计,词组统计等所有新功 ...
- 作业3-个人项目<词频统计>
上了一天的课,现在终于可以静下来更新我的博客了. 越来越发现,写博客是一种享受.来看看这次小林老师的“作战任务”. 词频统计 单词: 包含有4个或4个以上的字 ...
- C语言实现词频统计——第二版
原需求 1.读取文件,文件内包可含英文字符,及常见标点,空格级换行符. 2.统计英文单词在本文件的出现次数 3.将统计结果排序 4.显示排序结果 新需求: 1.小文件输入. 为表明程序能跑 2.支持命 ...
- c语言实现词频统计
需求: 1.设计一个词频统计软件,统计给定英文文章的单词频率. 2.文章中包含的标点不计入统计. 3.将统计结果以从大到小的排序方式输出. 设计: 1.因为是跨专业0.0···并不会c++和java, ...
- 软件工程第一次个人项目——词频统计by11061153柴泽华
一.预计工程设计时间 明确要求: 15min: 查阅资料: 1h: 学习C++基础知识与特性: 4-5h: 主函数编写及输入输出部分: 0.5h: 文件的遍历: 1h: 编写两种模式的词频统计函数: ...
- python瓦登尔湖词频统计
#瓦登尔湖词频统计: import string path = 'D:/python3/Walden.txt' with open(path,'r',encoding= 'utf-8') as tex ...
- Hadoop上的中文分词与词频统计实践 (有待学习 http://www.cnblogs.com/jiejue/archive/2012/12/16/2820788.html)
解决问题的方案 Hadoop上的中文分词与词频统计实践 首先来推荐相关材料:http://xiaoxia.org/2011/12/18/map-reduce-program-of-rmm-word-c ...
- pyspark进行词频统计并返回topN
Part I:词频统计并返回topN 统计的文本数据: what do you do how do you do how do you do how are you from operator imp ...
- 使用storm分别进行计数和词频统计
计数 直接上代码 public class LocalStormSumTopology { public static void main(String[] agrs) { //Topology是通过 ...
随机推荐
- go 并发编程(1)
优雅的并发编程范式,完善的并发支持,出色的并发性能是go语言区别于其他语言的一大特色. 1.并发基础 win和linux 出现之前,程序员并没有并发的概念.因为命令式程序设计语言是以串行为基础的,程序 ...
- JAVA RPC (三) 之thrift序列化协议入门杂谈
首先抱歉让大家久等了,最近工作的原因,再加上自己维护koalas rpc利用的大部分时间,一直没腾出空来写这篇文章. 先放出来自研的企业级RPC框架源代码地址,上面有使用方式和部署环境说明,说环境部署 ...
- redis 3.2 新数据结构:quicklist、String的embstr与raw编码方式分界点
Redis3.2.0引入了新的quicklist的数据结构做了list的底层存储方案.废弃了原来的两个配置参数, list-max-ziplist-entries list-max-ziplist-v ...
- MATLAB程序控制语句
Matlab中的程序控制语句包括条件控制(Conditional Control).循环(Loop Control).异常处理(Error Control)和程序返回(Program Terminat ...
- 使用AD画PCB的技能总结(纯属个人笔记,请大神多多指导)
在参加2017全国电子设计大赛的过程中,我将平时学到的点点滴滴记录下来,作为曾经的回忆吧!(未完待续) ------------------------------------------------ ...
- centos7 vmd-1.9.3安装
1. 下载安装包 安装包下载地址是http://www.ks.uiuc.edu/Research/vmd/,选择自己合适的版本,我下载1.9.3版本 2. 安装必要库 yum install free ...
- php普通传值和引用传值 (相当通俗易懂的一篇讲解)
首先,要理解变量名存储在内存栈中,它是指向堆中具体内存的地址,通过变量名查找堆中的内存; 普通传值,传值以后,是不同的地址名称,指向不同的内存实体; 引用传值,传引用后,是不同的地址名称,但都指向同一 ...
- flask框架中,利用数据库增删查改
# 配置数据库app.config['SQLALCHEMY_DATABASE_URI'] = "mysql://root:mysql@127.0.0.1:3306/booktest" ...
- java操作Maven
记录瞬间 import org.dom4j.Document; import org.dom4j.DocumentException; import org.dom4j.Element; import ...
- docker运行jar文件
一.环境 本地虚拟机安装的centos7 二.安装docker yum install docker-engine 三.开启阿里云加速 docker的镜像仓库在国外,下载会很慢,启用阿里云加速. 在/ ...