
Python菜鸟之路:Python基础-Python操作RabbitMQ
RabbitMQ简介
rabbitmq中文翻译的话,主要还是mq字母上:Message Queue,即消息队列的意思。rabbitmq服务类似于mysql、apache服务,只是提供的功能不一样。rabbimq是用来提供发送消息的服务,可以用在不同的应用程序之间进行通信。
Python操作RabbitMQ
操作准备:安装API
pip install pika
简单的发送与接收案例
对于RabbitMQ来说,生产和消费不再针对内存里的一个Queue对象,而是某台服务器上的RabbitMQ Server实现的消息队列。
* > 生产者代码
import pika

# ######################### 生产者 #########################

# 连接到rabbitmq服务器

connection = pika.BlockingConnection(pika.ConnectionParameters(

        host='172.25.50.13'))

channel = connection.channel()

# 声明消息队列,消息将在这个队列中进行传递。如果将消息发送到不存在的队列,rabbitmq将会自动清除这些消息。如果队列不存在,则创建

channel.queue_declare(queue='wzg')

# 发送消息到上面声明的'wzg'队列,其中exchange表示交换器,能精确指定消息应该发送到哪个队列(有指定的队列可以不进行配置),routing_key设置为队列的名称,body就是发送的内容

channel.basic_publish(exchange='',

                      routing_key='wzg',

                      body='Hello World!')

print(" [x] Sent 'Hello World!'")

# 关闭连接

connection.close()
* > 消费者代码
import pika

# ########################## 消费者 ##########################

# 连接到rabbitmq服务器

connection = pika.BlockingConnection(pika.ConnectionParameters(

        host='172.25.50.13'))

channel = connection.channel()

# 声明消息队列,消息将在这个队列中进行传递。如果队列不存在,则创建

channel.queue_declare(queue='wzg')

# 定义一个回调函数来处理,这边的回调函数就是将信息打印出来。

def callback(ch, method, properties, body):

    print(" [x] Received %r" % body)

# 告诉rabbitmq使用callback来接收信息

channel.basic_consume(callback,

                      queue='wzg',

                      no_ack=True) # no_ack=True表示在回调函数中不需要发送确认标识

print(' [*] Waiting for messages. To exit press CTRL+C')

# 开始接收信息,并进入阻塞状态,队列里有信息才会调用callback进行处理。按ctrl+c退出。

channel.start_consuming()
上述代码中的知识点1:消息确认(Message acknowledgment)
生效方法:channel.basic_consume(consumer_callback, queue, no_ack=False, exclusive=False, consumer_tag=None, arguments=None)
即no_ack=False(默认为False,即必须有确认标识),在回调函数consumer_callback中,未收到确认标识,那么,RabbitMQ会重新将该任务添加到队列中。
import pika

# ########################## 消费者 ##########################

# 连接到rabbitmq服务器

connection = pika.BlockingConnection(pika.ConnectionParameters(

        host='172.25.50.13'))

channel = connection.channel()

# 声明消息队列,消息将在这个队列中进行传递

channel.queue_declare(queue='wzg')

# 定义一个回调函数来处理,这边的回调函数就是将信息打印出来。

def callback(ch, method, properties, body):

    print(" [x] Received %r" % body)

    exit() # 在这里exit,就会中断发送确认标识,可以用来测试消息确认功能

    ch.basic_ack(delivery_tag=method.delivery_tag)

# 告诉rabbitmq使用callback来接收信息

channel.basic_consume(callback,

                      queue='wzg',

                      no_ack=False) # no_ack=False表示在回调函数中必须发送确认标识,否则认为任务异常,会被重新添加到队列中

print(' [*] Waiting for messages. To exit press CTRL+C')

# 开始接收信息,并进入阻塞状态,队列里有信息才会调用callback进行处理。按ctrl+c退出。

channel.start_consuming()
上述代码中的知识点2:消息持久化存储(Message durability)
虽然有了消息反馈机制,但是如果rabbitmq自身挂掉的话,那么任务还是会丢失。所以需要将任务持久化存储起来。声明持久化存储
channel.queue_declare(queue='wzg', durable=True) # 声明持久化
Ps: 但是这样程序会执行错误,因为‘wzg’这个队列已经存在,并且是非持久化的,rabbitmq不允许使用不同的参数来重新定义存在的队列。因此需要重新定义一个队列
channel.queue_declare(queue='test_queue', durable=True) # 声明持久化
注意:如果仅仅是设置了队列的持久化,仅队列本身可以在rabbit-server宕机后保留,队列中的信息依然会丢失,如果想让队列中的信息或者任务保留,还需要做以下设置:
channel.basic_publish(exchange='',

                      routing_key="test_queue",

                      body=message,

                      properties=pika.BasicProperties(

                         delivery_mode = 2, # 使消息或任务也持久化存储

                      ))
消息队列持久化包括3个部分:
(1)exchange持久化,在声明时指定durable => 1
(2)queue持久化,在声明时指定durable => 1
(3)消息持久化,在投递时指定delivery_mode=> 2(1是非持久化)如果exchange和queue都是持久化的,那么它们之间的binding也是持久化的。如果exchange和queue两者之间有一个持久化,一个非持久化,就不允许建立绑定。
上述代码中的知识点3:公平调度(Fair dispatch)
上面实例中,虽然每个工作者是依次分配到任务,但是每个任务不一定一样。可能有的任务比较重,执行时间比较久;有的任务比较轻,执行时间比较短。如果能公平调度就最好了,使用basic_qos设置prefetch_count=1,使得rabbitmq不会在同一时间给工作者分配多个任务,即只有工作者完成任务之后,才会再次接收到任务。
channel.basic_qos(prefetch_count=1) # 在消费者中进行设置
发布与订阅
RabbitMQ的发布与订阅,借助于交换机(Exchange)来实现。
交换机的工作原理:消息发送端先将消息发送给交换机,交换机再将消息发送到绑定的消息队列,而后每个接收端(consumer)都能从各自的消息队列里接收到信息。
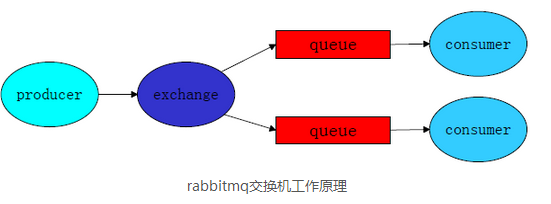
Exchange有三种工作模式,分别为:Fanout, Direct, Topic
模式1:Fanout
任何发送到Fanout Exchange的消息都会被转发到与该Exchange绑定(Binding)的所有Queue上
1.可以理解为路由表的模式
2.这种模式不需要routing_key(即使指定,也是无效的)
3.这种模式需要提前将Exchange与Queue进行绑定,一个Exchange可以绑定多个Queue,一个Queue可以同多个Exchange进行绑定。
4.如果接受到消息的Exchange没有与任何Queue绑定,则消息会被抛弃。
注意:这个时候必须先启动消费者,即订阅者。因为随机队列是在consumer启动的时候随机生成的,并且进行绑定的。producer仅仅是发送至exchange,并不直接与随机队列进行通信。
* > 生产者代码
# rabbitmq 发布者

import pika

# 创建连接

connection = pika.BlockingConnection(pika.ConnectionParameters(

        host='172.25.50.13'))

channel = connection.channel()

# 定义交换机,exchange表示交换机名称,type表示类型

channel.exchange_declare(exchange='logs_fanout',

                         type='fanout')

message = 'Hello Python'

# 将消息发送到交换机

channel.basic_publish(exchange='logs_fanout', # 指定exchange

                      routing_key='', # fanout下不需要配置,配置了也不会生效

                      body=message)

print(" [x] Sent %r" % message)

connection.close()
* > 消费者代码
#  rabbitmq 订阅者

import pika

connection = pika.BlockingConnection(pika.ConnectionParameters(

        host='172.25.50.13'))

channel = connection.channel()

# 定义交换机,进行exchange声明,exchange表示交换机名称,type表示类型

channel.exchange_declare(exchange='logs_fanout',

                         type='fanout')

# 随机创建队列

result = channel.queue_declare(exclusive=True) # exclusive=True表示建立临时队列,当consumer关闭后,该队列就会被删除

queue_name = result.method.queue

# 将队列与exchange进行绑定

channel.queue_bind(exchange='logs_fanout',

                   queue=queue_name)

print(' [*] Waiting for logs. To exit press CTRL+C')

def callback(ch, method, properties, body):

    print(" [x] %r" % body)

# 从队列获取信息

channel.basic_consume(callback,

                      queue=queue_name,

                      no_ack=True)

channel.start_consuming()
模式2:Direct
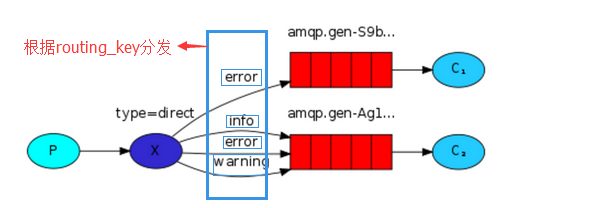
路由键的工作原理:每个接收端的消息队列在绑定交换机的时候,可以设定相应的路由键。发送端通过交换机发送信息时,可以指明路由键 ,交换机会根据路由键把消息发送到相应的消息队列,这样接收端就能接收到消息了。
任何发送到Direct Exchange的消息都会被转发到routing_key中指定的Queue:
1.一般情况可以使用rabbitMQ自带的Exchange:”” (该Exchange的名字为空字符串), 也可以自定义Exchange
2.这种模式下不需要将Exchange进行任何绑定(bind)操作。当然也可以进行绑定。可以将不同的routing_key与不同的queue进行绑定,不同的queue与不同exchange进行绑定
3.消息传递时需要一个“routing_key”
4.如果消息中中不存在routing_key中绑定的队列名,则该消息会被抛弃。
如果一个exchange 声明为direct,并且bind中指定了routing_key,那么发送消息时需要同时指明该exchange和routing_key.
* > 消费者代码
# 消费者

import pika

# 建立连接

connection = pika.BlockingConnection(pika.ConnectionParameters(

        host='172.25.50.13'))

channel = connection.channel()

# 定义exchange和类型

channel.exchange_declare(exchange='direct_test',

                         type='direct')

# 生成随机队列

result = channel.queue_declare(exclusive=True)

queue_name = result.method.queue

severities = ['error',]

# 将随机队列与routing_key关键字以及exchange进行绑定

for severity in severities:

    channel.queue_bind(exchange='direct_test',

                       queue=queue_name,

                       routing_key=severity)

print(' [*] Waiting for logs. To exit press CTRL+C')

def callback(ch, method, properties, body):

    print(" [x] %r:%r" % (method.routing_key, body))

# 接收消息

channel.basic_consume(callback,

                      queue=queue_name,

                      no_ack=True)

channel.start_consuming()
* > 生产者代码
# 发布者

import pika

# 建立连接

connection = pika.BlockingConnection(pika.ConnectionParameters(

        host='172.25.50.13'))

channel = connection.channel()

# 定义交换机名称及类型

channel.exchange_declare(exchange='direct_test',

                         type='direct')

severity = 'info'

message = '123'

# 发布消息至交换机direct_test,且发布的消息携带的关键字routing_key是info

channel.basic_publish(exchange='direct_test',

                      routing_key=severity,

                      body=message)

print(" [x] Sent %r:%r" % (severity, message))

connection.close()
当接收端正在运行时,可以使用rabbitmqctl list_bindings来查看绑定情况。
模式3:Topic
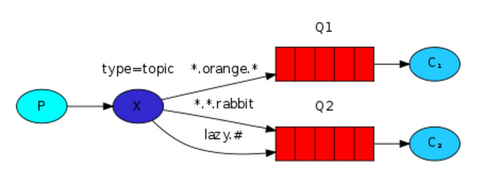
路由键模糊匹配,其实是路由键(routing_key)的扩展,就是可以使用正则表达式,和常用的正则表示式不同,这里的话“#”表示所有、全部的意思;“*”只匹配到一个词。
任何发送到Topic Exchange的消息都会被转发到所有关心routing_key中指定话题的Queue上
1.这种模式较为复杂,简单来说,就是每个队列都有其关心的主题,所有的消息都带有一个“标题”(routing_key),Exchange会将消息转发到所有关注主题能与 routing_key模糊匹配的队列。
2.这种模式需要routing_key,也许要提前绑定Exchange与Queue。
3.在进行绑定时,要提供一个该队列关心的主题,如“#.log.#”表示该队列关心所有涉及log的消息(一个routing_key为”MQ.log.error”的消息会被转发到该队列)。
4.“#”表示0个或若干个关键字,“*”表示一个关键字。如“log.*”能与“log.warn”匹配,无法与“log.warn.timeout”匹配;但是“log.#”能与上述两者匹配。
5.同样,如果Exchange没有发现能够与routing_key匹配的Queue,则会抛弃此消息。
具体代码这里不在多余写,参照第二种模式的就可以,唯一变动的地方就是exchange type的声明,以及进行绑定和发送的时候routing_key使用正则模式即可。
至此,利用Python操作RabbitMQ,以及一些简单用法,在这里介绍完毕。如有错误,请指正!
Python菜鸟之路:Python基础-Python操作RabbitMQ的更多相关文章
- Python菜鸟之路:Django 数据库操作进阶F和Q操作
Model中的F F 的操作通常的应用场景在于:公司对于每个员工,都涨500的工资.这个时候F就可以作为查询条件 from django.db.models import F models.UserI ...
- python学习之路-day2-pyth基础2
一. 模块初识 Python的强大之处在于他有非常丰富和强大的标准库和第三方库,第三方库存放位置:site-packages sys模块简介 导入模块 import sys 3 sys模 ...
- Python菜鸟之路:Django 路由补充1:FBV和CBV - 补充2:url默认参数
一.FBV和CBV 在Python菜鸟之路:Django 路由.模板.Model(ORM)一节中,已经介绍了几种路由的写法及对应关系,那种写法可以称之为FBV: function base view ...
- Python菜鸟之路:Python基础-模块
什么是模块? 在计算机程序的开发过程中,随着程序代码越写越多,在一个文件里代码就会越来越长,越来越不容易维护.为了编写可维护的代码,我们把很多函数分组,分别放到不同的文件里,分组的规则就是把实现了某个 ...
- Python菜鸟之路:JQuery基础
前言 JQuery可以理解为是一个模块,里边封装了DOM以及JavaScript,可以方便的对JQuery对象进行操作. 版本 尽量选择1.X系统的Jquery版本,例如1.12.jquery.js. ...
- Python菜鸟之路:Python基础——函数
一.函数 1. 简介 函数是组织好的,可重复使用的,用来实现单一,或相关联功能的代码段.函数能提高应用的模块性,和代码的重复利用率. 2. 组成 函数代码块以 def 关键词开头,后接函数名和圆括号( ...
- Python学习之路-Day2-Python基础2
Python学习之路第二天 学习内容: 1.模块初识 2.pyc是什么 3.python数据类型 4.数据运算 5.bytes/str之别 6.列表 7.元组 8.字典 9.字符串常用操作 1.模块初 ...
- PYTHON学习之路_PYTHON基础(1)
学习内容: 1.Python介绍 2.Python程序初接触和变量 3.Python用户交互 4.Python数据类型 5.Python循环if...(elif)...else 6.Python循环w ...
- python学习之路-day1-python基础1
本节内容: Python介绍 发展史 Python 2 or 3? 安装 Hello World程序 变量 用户输入 模块初识 .pyc是个什么鬼? 数据类型初识 数据运算 表达式if ...else ...
随机推荐
- spring 配置多数据源 (可行)
可以看到AbstractRoutingDataSource获取数据源之前会先调用determineCurrentLookupKey方法查找当前的lookupKey,这个lookupKey就是数据源标识 ...
- /profile文件修改后立即生效
修改profile etc/profile文件是只读的,直接用vi或gedit打开修改后是无法保存的.要修改profile,需要取得root权限,(使用gedit编辑) $sudo gedit /et ...
- native method与so中function的关联
在Android中,可以通过JNI的方式来调用和访问用C/C++实现的代码,这些代码以SharedLibrary的方式存在于so中.从Java Code到Native Code的一般使用过程为: 在J ...
- 飘逸的python - 实现一个pretty函数美丽的输出嵌套字典
演示样例: d = { "root": { "folder2": { "item2": None, "item1": N ...
- cordova与ios native code交互的原理
非常早曾经写了一篇博客,总结cordova插件怎么调用到原生代码:cordova调用过程,只是写得太水.基本没有提到原理.近期加深了一点理解,又一次补充说明一下 js调用native 以下是我们产品中 ...
- DeleteDC、ReleaseDC 、DeleteObject的使用
DeleteDC 该函数删除指定的设备上下文环境(DC). 原型: BOOL DeleteDC(HDC hdc): 参数: hdc:设备上下文环境的句柄. 返回值: 成功,返回非零值:失败,返回零.调 ...
- Linux shell快捷键
Ctrl + a 可以快速切换到命令行开始处Ctrl + e 切换到命令行末尾Ctrl + r 在历史命令中查找 ctrl + u 删除光标前面所有字符相当于VIM里d shift+^ ct ...
- EFCore & Mysql migration on Production
最好的办法是通过脚本进行生产环境数据库更新. 如: dotnet ef migration script -i -o "script.sql". 这样将会产生一个你不用在意线上版本 ...
- 【转】Intellij IDEA常用配置详解
1. IDEA内存优化 先看看你机器本身的配置而配置. \IntelliJ IDEA 8\bin\idea.exe.vmoptions -------------------------------- ...
- firewalld实现网关功能
用ip a查看自己的路由服务器接口,一个外网接口 wan ,还有内网接口: 我这里是一块网卡,配了一个虚拟ip,eth0: wan口 eth0:1 lan口 注意:要注意顺序,先将接口加到zone ...